7. OcclusionGateNet 개발기 7 — 모델들을 연결하고, 야간 영상을 찍어보기까지
해설글
작성 · 6분 읽기 · 조회수 —
들어가며
학습된 모델이 여러 개 준비되었다고 시스템이 바로 완성되는 것은 아니다. 얼굴 검출기는 bbox를 내고, MediaPipe는 landmark를 내고, 복원 모델은 crop 좌표를 낸다. 분류기는 이 값들이 같은 순간을 가리키고 같은 전처리를 거쳤다고 가정한다.
한 모델의 출력과 다음 모델의 입력 사이에서 맞춰야 할 것이 많았다. 마지막 편에서는 이 연결부를 살펴보고, 영종도 야간 촬영과 데모, 그리고 프로젝트에 남은 과제를 정리한다.
Part 1. 한 번의 step 안에서는 무슨 일이 일어날까?
통합 코드의 진입점은 FullDMSSystem.step(face_frame, body_frame)이다. 얼굴 카메라 프레임과 몸 카메라 프레임을 받아 각각 특징을 만들고, 최근 48프레임을 모아 분류한다.
| 순서 | 처리 | 다음 단계로 전달하는 것 |
|---|---|---|
| 1 | Body 영상의 YOLO-Pose | 17개 관절점과 confidence |
| 2 | Face 영상의 YOLO-face | 얼굴 bbox |
| 3 | Bbox crop의 가시성 CNN·MediaPipe | visibility, 478개 landmark |
| 4 | 가림이 있을 때 ORFormer + HGNet | 복원 landmark |
| 5 | 정렬 후 가림 부위 merge | 실제 분류기에 넣을 최종 landmark |
| 6 | Temporal buffer | 48프레임 입력 묶음 |
| 7 | DMS classifier | Action·gaze·hands·talk 예측 |
얼굴 쪽에서는 YOLO bbox를 공통 기준으로 사용한다. 다만 각 wrapper의 padding과 입력 크기까지 동일한 것은 아니므로, crop과 원본 프레임 사이의 좌표 변환이 필요하다. 5편에서 본 alignment도 이 연결 과정의 일부다.
학습 때 사용한 face·pose 전처리 함수를 런타임에서도 재사용한다. 학습에서는 특정 기준으로 정규화한 좌표를 사용했는데, 실행할 때 원본 픽셀 좌표를 그대로 넣는 식의 불일치를 줄이기 위해서다.
복원은 매 프레임 무조건 실행하지 않는다
가시성 CNN이 교체 대상 부위의 가림을 표시한 경우에만 ORFormer와 HGNet을 실행한다. 가림이 없으면 MediaPipe 좌표를 그대로 사용한다.
따라서 전체 처리 시간도 장면에 따라 달라질 수 있다. 얼굴 검출·가시성·MediaPipe·pose·분류 비용에, 복원 경로가 실행된 프레임의 비용이 추가된다. 분류기 단독의 ms/window를 측정했다고 전체 시스템의 FPS를 바로 알 수는 없다.
Part 2. 얼굴이 안 잡히면 시스템도 멈춰야 할까?
통합 코드에는 실패 상황별 분기가 있다. 얼굴 경로가 실패했다고 무조건 프로그램을 종료하면 몸 영상에서 얻을 수 있는 정보까지 버리게 된다. 그래서 배열 형태와 검출 상태를 유지한 채 다음 단계로 전달하도록 구성했다.
| 상황 | 현재 코드의 처리 |
|---|---|
| Body 검출 실패 | zero skeleton과 zero confidence 입력 |
| 얼굴 bbox 검출 실패 | zero FaceMesh, 중립 visibility, crop_valid=0 |
| Bbox는 있지만 MediaPipe 실패 | zero FaceMesh와 실패 상태; 이미 계산한 occ 정보는 유지 |
| 가시성 CNN 미사용·사용 불가 | wrapper의 중립 가시성 fallback |
| 가림이 있지만 HGNet 사용 불가·실패 | MediaPipe landmark 유지 |
| 정상 처리 | 가림 부위만 복원 좌표로 교체 |
README에는 얼굴 실패를 한 문장으로 요약한 부분이 있지만, 실제 코드는 bbox 실패와 MediaPipe 실패를 구분한다. 특히 MediaPipe가 실패하면 HGNet으로 얼굴 전체를 다시 만드는 것이 아니라 zero landmark를 전달한다.
fallback이 있다는 것은 프로그램이 계속 출력할 수 있다는 뜻이다. 실패한 입력에서도 예측 정확도가 보장된다는 뜻은 아니다. zero 입력과 검출 상태를 받은 모델이 어떻게 동작하는지는 별도로 평가해야 한다.
화면에 그린 점과 실제 입력이 같아야 한다
복원 데모에서는 landmark를 그리는 코드와 분류기에 넣는 코드가 어긋나지 않는지도 중요하다. 화면에는 복원 좌표를 보여주지만 분류기는 기존 좌표를 읽고 있다면, 데모를 보고 복원의 기여를 잘못 이해할 수 있다.
통합 코드는 최종 입력 좌표를 debug["facemesh"]에 넣고, hgnet_used, restored_regions, face_status도 함께 반환한다. 예측만 기록하기보다 실제로 어느 경로가 실행되었는지 확인할 수 있게 한 부분이다. 복원 checkpoint가 없는데도 출력 파일이 만들어졌다는 이유로 복원 경로까지 성공했다고 간주하면 안 된다.
Part 3. 48프레임 버퍼와 실시간이라는 말
TemporalDMSBuffer는 최대 48프레임을 유지하는 deque들로 구성된다. 얼굴·자세·가시성 값을 함께 추가하며, 첫 48프레임이 쌓이기 전에는 예측을 반환하지 않는다.
입력 프레임 레이트가 $f$라면, 48프레임이 담는 관측 시간은 대략 다음과 같다.
[설명용 유도 — 버퍼 길이로 계산한 관측 시간]
\[\tau_{\mathrm{window}}\approx\frac{48}{f}\ \mathrm{seconds}\]예를 들어 30fps 입력에서는 약 1.6초 분량이다. 이것은 프레임을 모으는 시간 범위이지, GPU가 예측 한 번에 1.6초를 사용한다는 뜻이 아니다. 입력 시작 시 버퍼가 차기를 기다리는 시간과 계산 지연을 나눠 봐야 한다.
버퍼가 찬 뒤에는 predict_stride에 따라 출력을 낸다. 기본값 1이면 매 입력 프레임마다 최근 창을 사용한다. 학습 데이터의 window stride 24와 런타임 예측 stride는 서로 다른 설정이다.
초기 기획에는 10~15FPS 수준의 목표가 있었다. 이를 실제 모든 모듈을 포함한 처리 속도로 확정하려면 장비, 입력 해상도, 가림 비율, 두 영상 읽기 비용까지 포함한 측정이 필요하다. 이 글에서는 시간 창 기반 스트리밍 추론을 구현했다는 사실과 특정 FPS를 검증했다는 주장을 구분한다.
두 카메라의 동기화도 같은 문제다. API에 두 프레임을 함께 전달한다고 실제 촬영 시각이 자동으로 같아지는 것은 아니다. 얼굴과 팔의 움직임을 같은 시간 창에 넣으려면 영상의 시간 기준과 frame alignment까지 확인해야 한다.
Part 4. 영종도 야간 촬영과 데모
최종 보고서에는 Arducam IR-Cut B0506 카메라 2대를 사용하고, 영종도에서 자정 무렵 야간 영상을 촬영한 기록이 남아 있다. 얼굴과 몸을 각각 관찰하는 두 시점의 입력을 준비하기 위한 촬영이었다.
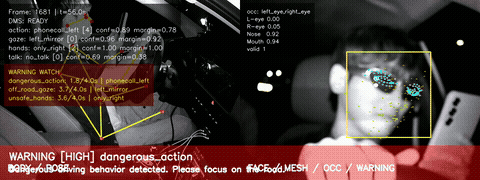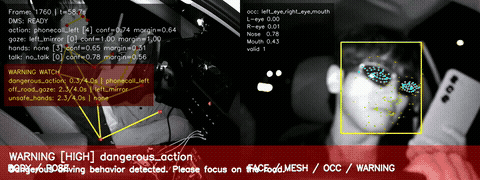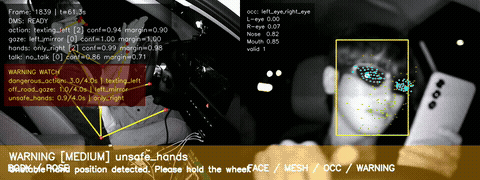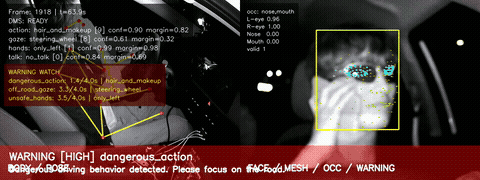
프로젝트에서 저장한 데모 GIF. 영상 처리 결과를 보여주는 정성 자료이며, 블로그 작성 시 새로 실행한 결과는 아니다.
이런 데모는 숫자 표에서 보이지 않는 연결 문제를 보여준다. 얼굴 bbox가 제대로 잡히는지, 복원 좌표가 프레임에서 어긋나지 않는지, 출력 상태가 입력 장면과 함께 움직이는지 볼 수 있다.
하지만 GIF에는 모든 실패 구간과 처리 지연의 분포가 담기지 않는다. 저장된 영상에서의 동작, 라이브 카메라 연결에서의 동작, 다양한 실제 주행 환경에서의 검증은 서로 다른 단계다. 데모를 마지막 증명으로 보기보다 모듈들이 연결되었음을 확인하는 한 자료로 두었다.
Part 5. 저장소를 받아서 실행하려면
통합 코드는 공개되어 있지만 체크포인트는 Git에 포함되어 있지 않다. 모델 목록에는 다음 6개 파일이 정의되어 있다.
full_system/Model/
├── yolo_pose.pt
├── yolo_face.pt
├── occ_cnn.pt
├── orformer.pt
├── hgnet.pt
└── dms_checkpoint.pt
전체 복원 경로에는 ORFormer와 HGNet 두 체크포인트가 모두 필요하다. DMS config도 checkpoint와 같은 variant여야 한다. taskGated라는 이전 모델 이름과 최종 explicitRegionScalarMaskGate를 같은 것으로 바꿔 넣으면 안 된다.
의존성과 checkpoint 경로를 준비한 뒤 두 영상으로 실행하는 진입점은 다음과 같다.
cd full_system
python scripts/run_video_pair.py \
  --config configs/full_dms_config_template.yaml \
  --face-video /path/to/face_video.mp4 \
  --body-video /path/to/body_video.mp4 \
  --out-jsonl outputs/predictions.jsonl
경로는 실행 환경에 맞게 바꿔야 한다. 저장소의 shape smoke test는 버퍼 배열 형태만 확인하며 모델을 로드하지 않는다. 그래서 smoke test 성공, 프로그램의 예측 출력, 모든 checkpoint가 활성화된 재현 성공은 서로 다른 확인 항목이다.
현재 공개 자료만으로 가능한 것은 구조와 학습·평가 코드를 읽고 저장된 결과를 확인하는 데까지다. 이 글을 작성하면서 checkpoint를 받아 전체 추론이나 학습을 재실행한 것은 아니다.
Part 6. 이 프로젝트에서 맡았던 일과 남은 일
이 프로젝트는 팀 작업이었다. 보고서의 역할 분담을 기준으로, 데이터 준비와 pose annotation·촬영은 함께 수행했다. 나는 얼굴 landmark 복원을 맡았고, fusion classifier와 ablation은 팀원과 함께 작업했다. 가시성 CNN, 외부 비교 구현 등 다른 파트도 각 담당자가 나누어 진행했다.
그래서 프로젝트의 결과를 설명할 때도 ORFormer를 적용한 복원 파트, 팀에서 만든 융합 구조, 통합과 실험을 구분해서 적으려 했다. 기존 논문의 기반과 팀의 기여를 함께 드러내는 편이 실제 작업을 더 잘 보여준다고 생각한다.
다시 이어서 한다면 우선순위는 다음과 같다.
- 실험의 정의부터 정리하기. 실제 체크포인트·config·코드 commit을 하나의 실행 기록으로 연결하고,
no_occ처럼 이름과 제거 범위가 다른 조건을 다시 정의한다. - 복원 supervision 검증하기. 임시 landmark-to-patch 매핑을 공간 좌표에 맞게 바꾸고, target 시각화와 독립적인 landmark 평가를 먼저 수행한다.
- 새로운 사람과 실제 가림에서 확인하기. 원본·운전자 단위 분리를 검증하고, 합성 패턴 외의 실제 선글라스·손 가림·촬영 조건으로 평가한다.
- Gaze의 남은 오류를 구체적으로 보기. 보고서에서 제안한 눈 crop·동공 정보를 검토하되, 관측 가능한 장면과 가려진 장면의 차이를 나누어 실험한다.
- 시스템 비용 측정하기. 전체 지연과 복원 실행 비율을 먼저 측정한 뒤, 경량화·양자화가 성능과 지연에 주는 영향을 확인한다.
TabPFN 글에서는 캡스톤 이야기를 괄호 한 줄로 적었는데, 이렇게 정리하고 보니 모델 구조보다 연결부와 실험을 설명하는 분량이 더 많아졌다. 정답을 어디서 얻었는지, loss가 무엇을 학습시키는지, gate가 실제로 어느 경로를 바꾸는지까지 따라가야 결과를 이해할 수 있었다.
우수상으로 마무리한 프로젝트지만, 저장소에는 해결한 부분과 아직 손봐야 할 부분이 같이 남아 있다. 이 개발기가 완성된 숫자뿐 아니라 그 숫자에 도달한 과정과 남은 질문까지 보여주는 기록이었으면 한다.