5. OcclusionGateNet 개발기 5 — 복원한 얼굴을 얼마나 믿어야 할까?
해설글
작성 · 5분 읽기 · 조회수 —
들어가며
선글라스 때문에 눈 좌표가 흔들려서 복원 모델을 붙였다. 이제 분류기에 넣기만 하면 될까? 복원이 추정인 이상, 복원된 얼굴과 관측된 몸 자세 중 무엇을 얼마나 참고할지라는 문제가 남는다.
action과 gaze도 필요한 정보가 다르다. 옆으로 팔을 뻗는 행동은 몸의 움직임이 큰 단서가 될 수 있고, 비슷한 자세에서 시선만 달라지는 장면은 얼굴 정보가 더 필요하다. 모든 과제에 같은 비율로 얼굴과 자세를 섞는 것이 최선이라고 가정할 이유는 없다.
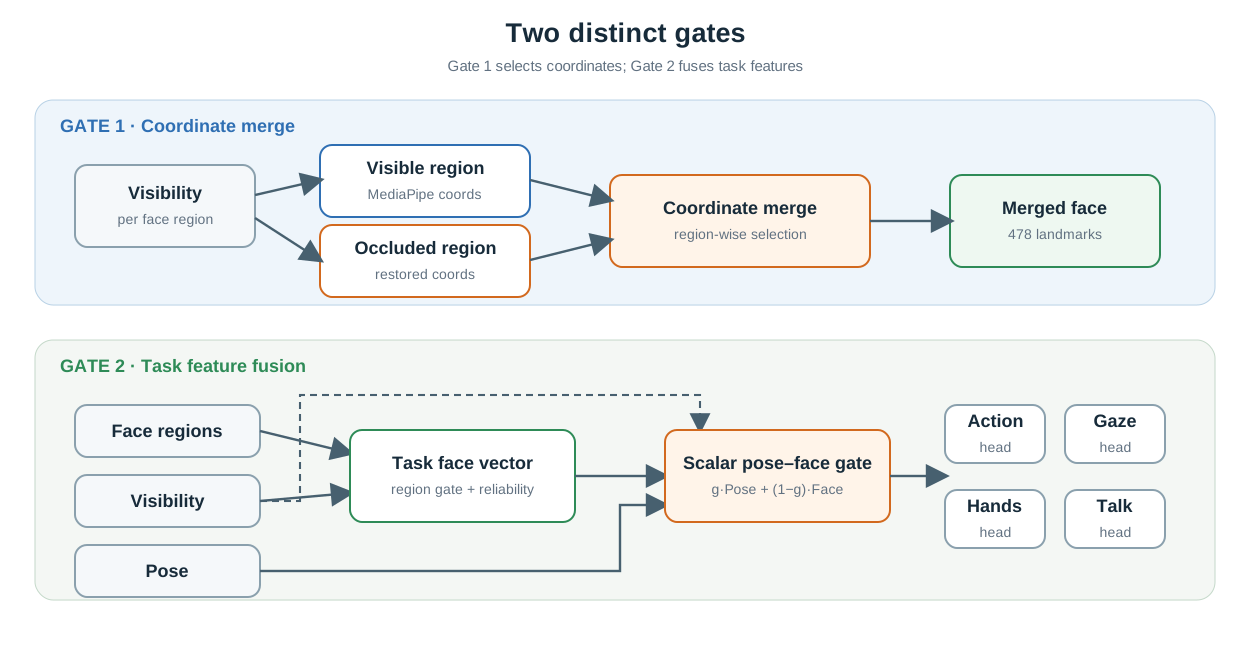
그래서 OcclusionGateNet에서는 가시성을 두 단계에 사용한다.
첫 번째 gate는 좌표를 선택한다. 두 번째 gate는 과제별로 feature를 섞는다.
Part 1. 좌표를 바꾸기 전에 좌표계부터 맞춘다
MediaPipe와 HGNet의 점을 바로 섞을 수 있을까?
두 모델이 같은 얼굴을 보더라도 crop과 전처리, 예측 좌표의 기준이 다를 수 있다. 그래서 HGNet의 출력은 먼저 원본 프레임 좌표계로 변환하고, merge 단계에서 MediaPipe와 2D similarity alignment를 수행한다.
similarity transform은 회전·크기·이동을 조정하는 변환이다. 얼굴 형태를 임의로 휘어 맞추는 연산은 아니다. 현재 구현은 미리 정의한 눈·코·입의 교체 대상 영역을 제외한 점들을 정렬 기준으로 사용한다. 매번 검출된 모든 가시점에서 동적으로 최적 subset을 선택하는 구조와는 다르다.
가림 부위만 교체한다
외부 CNN의 visibility가 threshold 0.5보다 작으면 해당 부위를 가림으로 표시한다. crop이 유효하고 MediaPipe와 HGNet 결과가 사용 가능하다는 조건 아래, merge는 다음처럼 쓸 수 있다.
[코드 기반 재구성 — 정상 처리 경로]
\[p_i^{\mathrm{merge}}= \begin{cases} A(p_i^{\mathrm{HG}}), & i\text{가 가림 판정 부위에 속할 때},\\ p_i^{\mathrm{MP}}, & \text{그 외}. \end{cases}\]$A$는 앞에서 구한 2D 정렬이다. 잘 보이는 부위를 이미 MediaPipe가 잡고 있다면 그 좌표를 유지하고, 필요한 부분에만 복원 결과를 적용한다.
이 방식에는 분명한 전제가 있다. 현재 통합 코드는 MediaPipe 자체가 실패하면 HGNet만으로 얼굴을 되살리는 경로로 넘어가지 않는다. zero landmark와 검출 실패 상태를 전달한다. 복원기가 없거나 복원에 실패한 경우에는 기존 MediaPipe 좌표를 유지한다. ‘가려진 일부 부위의 보완’과 ‘얼굴 검출 전체 실패의 복구’를 구분해야 한다.
Part 2. 478개 점을 10개 region으로 읽기
분류기의 입력
최종 설정의 시간 창은 48프레임이다. 한 프레임의 얼굴 모양만 보는 대신, 얼굴과 자세가 시간에 따라 어떻게 바뀌는지 읽는다.
| 입력 | 원자료 | 분류 설정 |
|---|---|---|
| Face | 478개 landmark와 검출 상태 | 10개 region pooling, z·검출 채널 사용 |
| Pose | 17개 관절점과 confidence | bone·velocity·confidence 정보 사용 |
| Occ | 부위별 visibility + crop 유효성 | 5차원 벡터를 window 평균으로 집계 |
얼굴은 dms_10 정의에 따라 landmark를 부위별로 묶는다. 모든 점을 독립 token으로 transformer에 보내는 것이 아니라, region 표현을 만든 뒤 관계를 학습한다.
얼굴 backbone의 출력 형태를 $(N,C,T,R)$로 쓰면, $N$은 batch, $C$는 feature 차원, $T$는 시간, $R$은 region이다. 융합 모듈은 시간 평균을 취하고 축을 바꿔 $(N,R,C)$ 의 region token으로 만든다. 최종 설정에서 $R=10$, branch feature 차원은 128이다.
Transformer는 어느 축에 걸릴까?
여기서 transformer는 얼굴 region 사이의 관계를 처리한다. 최종 config의 추가 temporal module은 identity다. backbone 안의 시간 방향 연산까지 없다는 뜻은 아니지만, ‘48프레임 전체를 별도의 temporal transformer로 처리한다’고 설명하면 현재 설정과 맞지 않는다.
눈 region이 혼자 무엇을 나타내는지만 보는 대신, 코·입·윤곽 등의 다른 region과 함께 표현을 갱신한다. 그다음 task마다 다른 가중치를 계산한다.
Part 3. 중요한 부위와 잘 보이는 부위를 함께 반영한다
region transformer를 거친 token을 $u_r$, task $t$의 학습된 region gate를 $a_{t,r}$, visibility로 만든 reliability를 $v_r$라고 두자. 최종 explicit mask variant의 얼굴 feature는 다음과 같다.
[코드 기반 재구성]
\[w_{t,r}=a_{t,r}v_r, \qquad f_t^{\mathrm{face}} =\frac{\sum_r w_{t,r}u_r} {\max\!\left(\sum_r w_{t,r},\varepsilon\right)}\]$a_{t,r}$는 task별로 학습한다. 같은 눈 region이라도 action head와 gaze head에서 같은 중요도를 가질 필요가 없다. 여기에 $v_r$를 곱해, 가시성이 낮은 부위의 상대적 비중을 조정한다. region gate를 만드는 네트워크 자체에도 occ 벡터를 조건으로 전달한다.
다만 이것은 정규화된 가중 평균이다. 모든 가중치에 똑같이 작은 상수를 곱하면 분자와 분모에서 상쇄될 수 있다. 따라서 visibility를 곱했으니 얼굴 feature의 절대 크기가 항상 줄어든다고 해석하면 안 된다. 주된 효과는 어떤 region을 상대적으로 더 참고하는지 바꾸는 데 있다.
Visibility를 10개 region에 옮기는 방식
외부 CNN은 얼굴의 모든 10개 region을 각각 예측하지 않는다. 현재 설정은 5차원 occ 벡터의 앞 네 값을 region에 대응시키고, 직접 대응시키지 않은 region에는 기본 reliability 1을 준다. 아래는 실제 설정이다.
region_occ_indices: [0, 1, 2, 2, 3, 3, -1, -1, -1, -1]
default_visible: 1.0
min_reliability: 0.05
mask_strength: 1.0
-1은 해당 region을 외부 visibility에 직접 연결하지 않는다는 뜻이다. reliability의 최솟값도 0.05로 제한한다. crop 유효성인 다섯 번째 값은 gate의 조건 입력에는 들어가지만, 이 배열에서 모든 region을 끄는 직접 mask로 사용되지는 않는다.
그래서 이 부분은 설정으로 지정한 region–visibility 대응이라고 설명하는 편이 정확하다. 모든 얼굴 부위에 독립적인 가림 정답을 주었다거나, 검출 실패 시 모든 face feature를 수학적으로 0으로 만든 구조는 아니다.
Part 4. 얼굴과 자세를 task마다 다시 섞는다
region pooling으로 task별 얼굴 벡터를 얻었으면, pose feature와 함께 scalar gate를 계산한다. 각 task마다 별도의 gate가 있다.
[코드 기반 재구성]
\[g_t=\sigma\!\left(G_t(f^{\mathrm{pose}},f_t^{\mathrm{face}},o)\right)\] \[h_t=h_{\mathrm{shared}}+0.25\left[ g_tP(f^{\mathrm{pose}})+(1-g_t)F(f_t^{\mathrm{face}}) \right]\]$o$는 occ 벡터이고, $P$와 $F$는 각 feature를 256차원으로 옮기는 projection이다. 여기서 $g_t$는 pose 쪽 가중치다. 값이 커질수록 pose가, 작아질수록 face가 혼합 항에 더 많이 들어간다.
그리고 앞에 $h_{\mathrm{shared}}$가 있다. 얼굴과 자세를 함께 처리한 공유 feature 위에 task별 혼합 feature를 residual로 더하는 구조다. 이 shared 경로에도 얼굴 정보가 들어간다.
따라서 scalar gate가 pose 쪽으로 기울었다고 해서 최종 head로 가는 모든 얼굴 정보가 차단되지는 않는다. 그림에서는 gate 하나로 간단히 표현하기 쉽지만, 실제 동작을 이해하려면 공유 경로까지 봐야 한다. 앞의 도식은 task별 혼합 경로를 중심으로 그렸고, 전체 출력에는 이 residual 결합이 추가된다.
Part 5. 네 과제를 동시에 학습하기
각 task feature는 action 11개, gaze 9개, hands 4개, talk 2개의 logit으로 이어진다. 최종 설정의 loss 가중치는 다음과 같다.
[코드 기반 재구성 — 최종 config의 task loss 결합]
\[\mathcal L_{\mathrm{DMS}} =0.45\mathcal L_{\mathrm{action}} +0.45\mathcal L_{\mathrm{gaze}} +0.05\mathcal L_{\mathrm{hands}} +0.05\mathcal L_{\mathrm{talk}}\]각 task에는 class weight를 사용하는 설정이 켜져 있다. best checkpoint를 고를 때도 같은 비율의 task score를 사용한다. 따라서 이 모델은 네 과제를 똑같은 우선순위로 최적화한 결과가 아니다. action과 gaze에 더 큰 비중을 둔 설정이다.
평가 표를 볼 때 hands와 talk가 항상 가장 높은 값을 내지 않더라도 이상한 일은 아니다. 모델 구조의 효과와 어떤 목적함수로 checkpoint를 선택했는지를 함께 읽어야 한다.
통합 추론과 end-to-end 학습은 다르다
통합 시스템은 영상부터 네 가지 출력까지 한 흐름으로 실행한다. 하지만 분류기 학습에서는 미리 추출한 landmark와 occ cache를 읽는다. 최종 DMS loss가 MediaPipe나 ORFormer·HGNet까지 거슬러 올라가 전체를 공동 학습하는 구조는 아니다.
복원 모델을 학습하고, 그 결과를 cache로 만들고, 그 입력으로 분류기를 학습하는 단계가 나뉜다. 따라서 ‘end-to-end 시스템’이라는 말을 사용할 때도 입출력이 연결된 시스템인지, gradient까지 이어진 학습인지를 구분하는 편이 좋다.
이제 구조 설명은 끝났다. 다음 편에서는 gate가 왜 필요한지 말로 설득하는 대신, 실제로 조건을 바꾸어 재학습한 결과를 본다. 다만 ablation 이름만 보고 무엇이 제거되었는지 단정하지 않고, 설정에서 바뀐 연산까지 함께 확인한다.