2. CIGPose 구현 해설 - 관절 벡터 하나를 바꾸면 어디까지 학습될까?
해설글
작성 · 14분 읽기 · 조회수 —
들어가며
1편에서는 CIGPose가 왜 불확실한 관절 특징을 바꾸는지 살펴봤다. 그런데 코드를 읽기 시작하면 질문이 조금 달라진다.
“관절 특징이 512차원이라는데, 그 안에 좌표가 들어 있는 건가?”
“손목 특징을 바꾸면 원래 손목을 뽑은 인코더는 학습을 못 하는 건가?”
“관찰 경로를 고정한다면서 같은 GNN을 어떻게 학습하지?”
이 글은 그 질문들을 하나씩 따라간다. 먼저 전체 지도를 보고, 각 모듈의 입력과 출력을 확인한 뒤, 마지막에 두 손실의 gradient를 연결한다. 계산은 조금 길지만 어디에서 무엇이 바뀌는지 정리하면 모듈 이름만 외울 때보다 훨씬 편하다.
읽는 기준
공식 저장소의 commit b7444d8과 CIGPose-x · COCO-WholeBody · 384×288 설정을 기준으로 한다. 학습을 직접 재현한 실험 기록이 아니라, 원문·보충자료와 해당 소스의 정적 분석을 대조한 해설이다. 다른 모델 크기나 커밋에서는 설정이 달라질 수 있다.
Part 1. 전체 텐서 지도부터
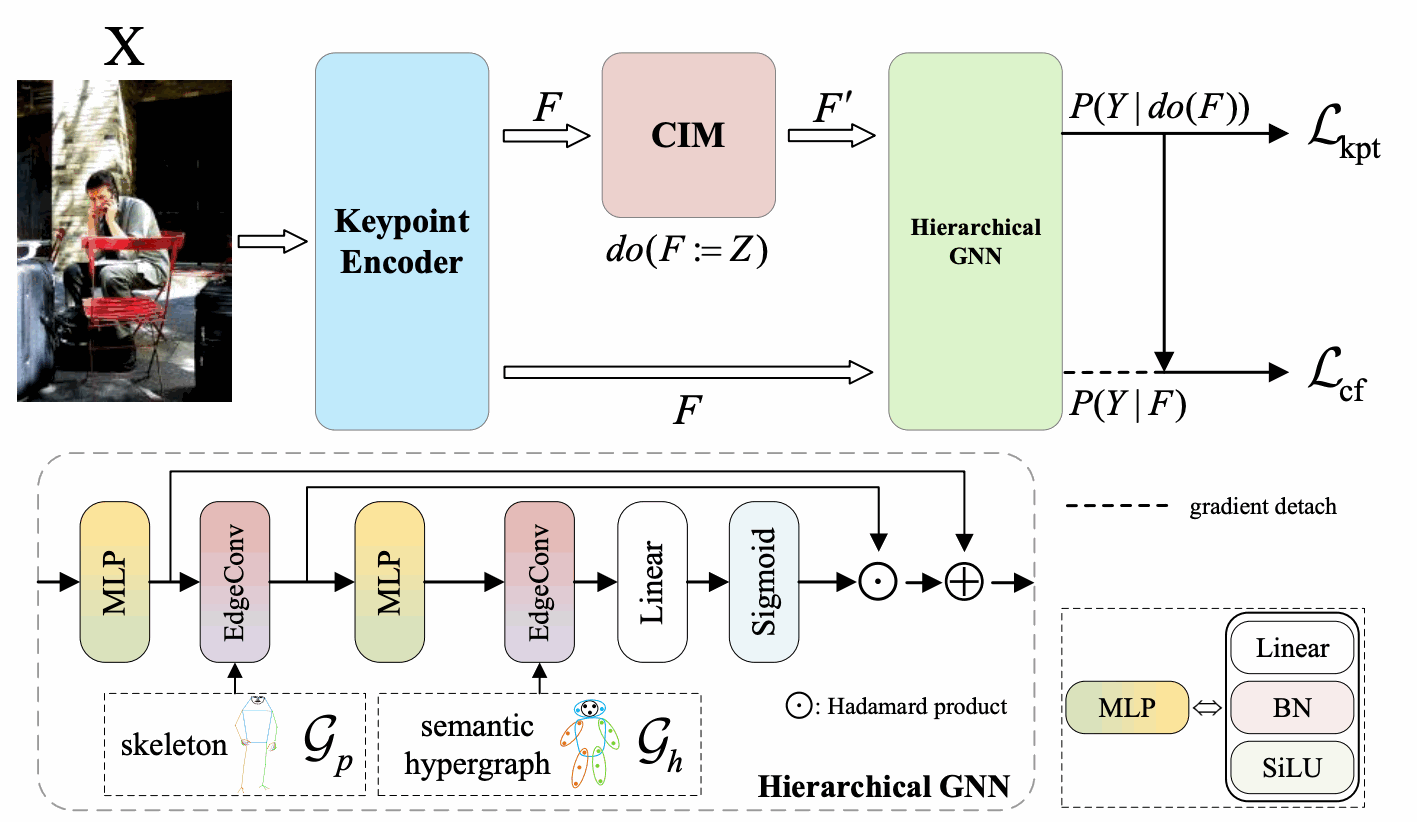 출처: 논문 Fig. 5. 먼저 위쪽의 Encoder → CIM → HGNN → prediction을 따라가고, 아래의 세부 구조는 HGNN 절에서 다시 보자.
아래 표의 크기는 [코드 기반 재구성]이다. B는 배치 크기다. 한 샘플은 원본 사진 전체가 아니라, 사람 영역을 변환한 crop이다.
| 순서 | 코드에서 하는 일 | 출력 크기 |
|---|---|---|
| 1 | RGB 사람 crop 입력 | [B, 3, 384, 288] |
| 2 | CSPNeXt-x backbone | [B, 1280, 12, 9] |
| 3 | 7×7 convolution, final_layer |
[B, 133, 12, 9] |
| 4 | 공간축 flatten | [B, 133, 108] |
| 5 | ScaleNorm + Linear | [B, 133, 512] |
| 6 | GAU | [B, 133, 512] |
| 7 | CIM의 일부 특징 치환 | [B, 133, 512] |
| 8 | HGNN | [B, 133, 512] |
| 9 | 최종 x / y 선형 head | [B, 133, 576] / [B, 133, 768] |
가장 먼저 주의할 것은 config의 input_size=(288, 384)는 (W, H) 순서라는 점이다. PyTorch 이미지 텐서는 [B, C, H, W]이므로 순서가 바뀐다. x축이 576개, y축이 768개인 이유도 여기에 있다.
그리고 [B, 133, 512]에서 133은 관절 수지만, 512는 좌표의 수가 아니다. 각 관절을 표현하는 학습된 feature의 차원이다. 좌표 후보 bin으로 바뀌는 것은 마지막 선형 head를 통과한 뒤다. CIGHead
Part 2. Keypoint Encoder — 이미지가 관절 토큰이 되기까지
CSPNeXt와 7×7 convolution
선택한 설정은 MMDetection의 CSPNeXt-x를 backbone으로 사용한다. config에 _scope_='mmdet'가 있으므로, 저장소에 이름이 같은 파일이 있다고 해서 그것이 실제 runtime의 backbone이라고 단정하면 안 된다. 모델 설정
큰 흐름은 downsampling으로 공간 해상도를 줄이고, CSP 계열 블록과 SPP로 특징을 처리하는 것이다. 역할을 구분해보면 다음과 같다.
| 구성 | 이해할 포인트 |
|---|---|
| Downsampling | 공간 크기를 줄여 더 넓은 영역의 특징을 다룬다 |
| CSP 계열 블록 | 특징을 두 경로로 처리하고 다시 결합한다. 모든 short branch를 단순 identity로 생각하면 안 된다 |
| SPP | 서로 다른 크기의 pooling 결과를 결합해 여러 수용영역의 정보를 모은다 |
이 글에서는 backbone 내부의 모든 convolution을 나열하기보다, CIGPose head로 넘어오는 경계부터 구체적으로 보자. 최종 feature map은 1280개 채널과 12×9 공간 위치를 가진다. 여기에 출력 채널이 133개인 7×7 convolution을 적용한다.
[코드 기반 재구성: 선택 config와 CIGHead의 특징 처리]
\[[B,1280,12,9] \xrightarrow{\operatorname{Conv}_{7\times7}} [B,133,12,9] \xrightarrow{\operatorname{flatten}} [B,133,108]\]7×7은 커널 크기, 133은 출력 채널 수다. 적절한 padding으로 공간 크기를 유지한다. 각 출력 채널의 12×9 위치를 펼치면 관절별 108차원 벡터가 된다.
그렇다고 이때의 각 채널이 이미 정답 관절 좌표를 뜻하는 것은 아니다. 뒤의 좌표 예측 손실을 통해 관절별 표현이 학습되는 구조라고 이해하면 된다.
ScaleNorm과 Linear는 다른 일을 한다
ScaleNorm은 벡터의 크기를 정규화하고, Linear는 학습한 가중치로 특징을 다른 차원으로 옮긴다. ‘정규화해서 512차원이 된다’가 아니라 정규화 후 Linear가 108차원을 512차원으로 바꾸는 것이다.
[코드 기반 재구성: ScaleNorm의 연산 형태]
\[\operatorname{ScaleNorm}(v) =\frac{g\,v}{\max(\lVert v\rVert_2/\sqrt d,\epsilon)}\]여기서 차원 수는 d, 학습되는 크기 파라미터는 g다. 벡터의 성분 사이 비율을 유지하면서 크기를 조절한다. 이어지는 bias 없는 Linear가 관절별 108차원 벡터를 512차원으로 사상한다. ScaleNorm 구현 · RTMCC 구현
GAU는 관절 사이에서 정보를 섞는다
GAU, Gated Attention Unit은 133개의 관절 토큰 사이의 정보를 섞는 단계다. 이 설정에서는 입력과 출력 모두 [B, 133, 512]다.
정규화한 입력을 선형 변환하고 SiLU를 적용한 뒤 세 덩어리로 나눈다. 아래 크기는 [코드 기반 재구성]이다.
| 텐서 | 크기 | 역할 |
|---|---|---|
| U | [B, 133, 1024] |
모은 정보를 조절하는 gate |
| V | [B, 133, 1024] |
다른 토큰에 전달할 특징 |
| R | [B, 133, 256] |
query와 key를 만드는 공통 base |
총 2304차원을 1024, 1024, 256으로 자르는 셈이다. 여기서는 정준 임베딩 테이블과 기호가 겹치지 않도록 코드의 base를 R로 적었다.
[코드 기반 재구성: GAU, 위치 인코딩·상대 위치 편향이 꺼진 설정]
\[Q=R\odot\gamma_Q+\beta_Q,\qquad K_{\mathrm{attn}}=R\odot\gamma_K+\beta_K\] \[A=\operatorname{ReLU}\left(\frac{QK_{\mathrm{attn}}^\top}{\sqrt{256}}\right)^2\] \[F=r\odot F_{\mathrm{in}}+W_o\left(U\odot(AV)\right)\]소문자 r은 512차원의 학습 가능한 residual scale이다. 여기서 A는 [B, 133, 133], AV는 [B, 133, 1024]다. 마지막 투영으로 다시 512차원이 된다.
익숙한 Transformer와 비슷해 보여도 이 구현의 attention kernel은 softmax가 아니라 ReLU를 제곱한 값이다. U와 곱하는 부분은 원소별 gating이다. 또 query·key를 만드는 첫 식은 곱셈뿐 아니라 덧셈까지 포함한 affine transformation이다. 이런 작은 구분을 놓치면 GAU를 그냥 ‘일반 attention’으로 설명하게 된다. RTMCCBlock
Part 3. CIM — 점수를 계산하고, 고르고, 바꾼다
초기 SimCC는 선택용이다
GAU가 만든 관절 특징을 x축과 y축의 초기 선형 head에 각각 넣는다.
[코드 기반 재구성: 초기 예측 head]
\[h^{\mathrm{init}}_{k,x}=W_x f_k+b_x,\qquad h^{\mathrm{init}}_{k,y}=W_y f_k+b_y\]좌표의 split ratio가 2이므로 x축은 288×2=576개, y축은 384×2=768개 bin을 갖는다. 여기서 나오는 값은 logits다. 확률로 사용하려면 각 축에 softmax를 적용한다.
[코드 기반 재구성: x축 정규화, y축도 같은 방식]
\[P_{b,k,x}(i)=\frac{\exp(h^{\mathrm{init}}_{b,k,x,i})} {\sum_{\ell=0}^{575}\exp(h^{\mathrm{init}}_{b,k,x,\ell})}\]b는 배치 안의 사람 crop 번호, k는 관절 번호, i는 x축 좌표 bin이다. y축의 bin index와 혼동하지 말자.
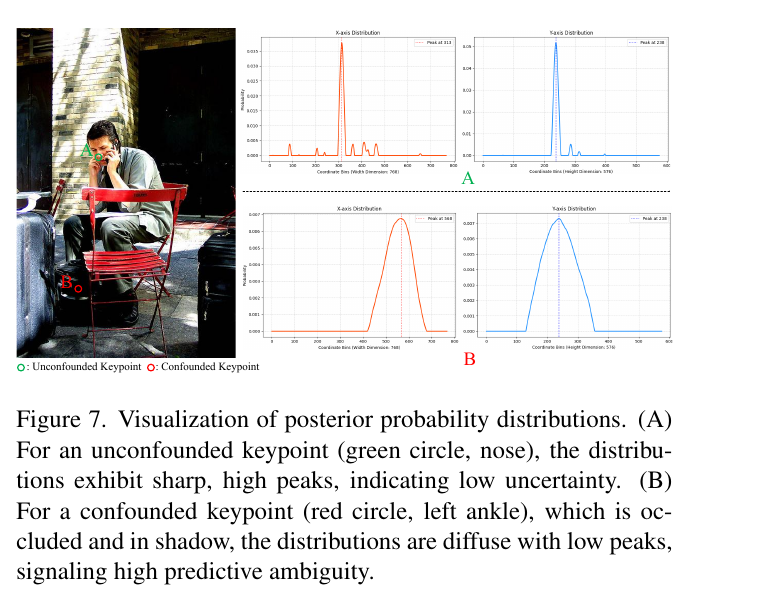 출처: 보충자료 Fig. 7. 저자들은 분포의 퍼짐을 통해 위치 판단의 모호성을 설명한다. 이 그림이 특정 공개 커밋의 초기 head가 어떻게 학습되었는지까지 증명하는 것은 아니다.
Top-k는 배치 전체가 아니라 사람별로 고른다
[논문 원문: 식 (2), 배치 index를 추가한 표기]
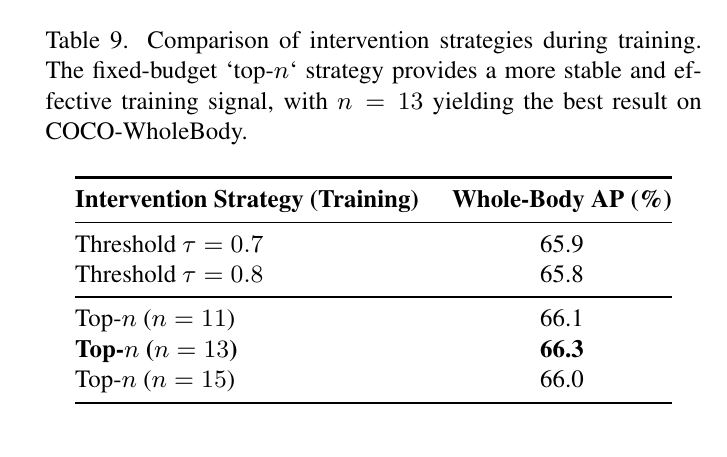
\[s_c(b,k)=1-\frac12\left(\max_i P_{b,k,x}(i)+\max_j P_{b,k,y}(j)\right)\]점수가 큰 관절을 사람마다 선택한다. 검토한 설정은 학습에서 13개, 검증·추론에서 1개를 고른다. torch.topk(..., dim=1)이 관절축에서 실행되는 이유다.
이 설정은 고정 개수를 고르는 방식이다. 모든 관절이 비교적 확실해도 Top-1은 하나를 선택한다. ‘점수가 임계값을 넘은 관절만 바꾼다’는 설명은 별도의 threshold 전략에 해당한다. 보충자료 Table 9도 이 두 전략을 구분해서 비교한다. CIM 구현 · 설정
정준 임베딩은 공유하지만, 선택은 이미지마다 다르다
정준 임베딩 테이블은 nn.Embedding(133, 512)다. 133개 관절 유형마다 512차원 벡터 하나가 있다. 표준편차 0.01의 정규분포로 초기화하고 학습 중 최적화한다.
[보충자료: C절 식 (8)]
\[f'_{b,k}=(1-m_{b,k})f_{b,k}+m_{b,k}z_k\]마스크가 1이면 공유 테이블의 벡터, 0이면 현재 이미지의 원래 특징을 사용한다. 공유 테이블에는 배치축이 없지만, 어떤 행을 가져올지는 이미지별 점수에 따라 달라진다.
코드의 핵심 동작을 줄이면 아래와 같다. 아래 블록은 [코드 기반 재구성]이며 설명용 발췌다.
indices = torch.where(intervened_mask)   # (batch indices, keypoint indices)
canonical = self.canonical_features(indices[1])
f_prime = f_kpts.clone()
f_prime[indices] = canonical
clone() 자체는 gradient를 끊지 않는다. 다만 덮어쓴 위치에서는 값의 출처가 원래 특징에서 정준 임베딩으로 바뀐다. 뒤에서 loss를 계산하면 그 위치의 gradient는 정준 임베딩으로 이어진다.
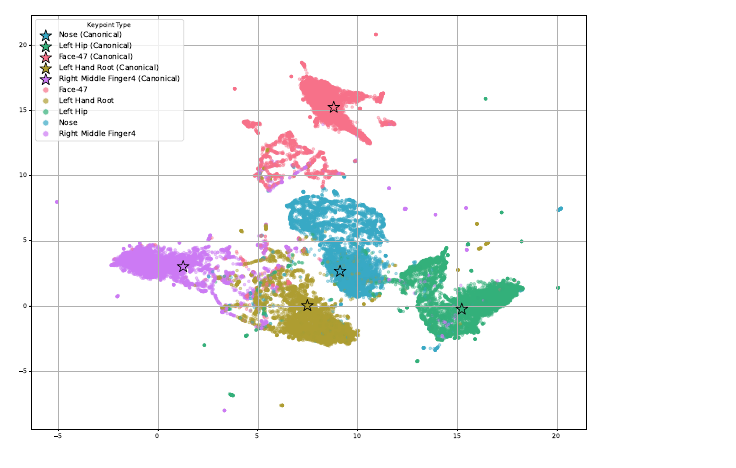 출처: 논문 Fig. 4. 이미지별 특징은 여러 점으로, 관절별 공유 정준 벡터는 하나의 점으로 표현된다. 관절 종류 사이의 구분은 볼 수 있지만, 하나의 공유 벡터가 한 점이라는 사실만으로 모든 문맥 편향이 제거되었다고 결론 내릴 수는 없다.
코드에서 추가로 확인해야 했던 부분
여기에는 그냥 넘어가기 어려운 지점이 있다. 학습 함수는 초기 head에 f_kpts.detach()를 넣고, CIM 안에서는 초기 logits의 softmax·점수·Top-k를 모두 torch.no_grad() 안에서 계산한다.
따라서 검토한 학습 경로에서는 초기 예측 head로 loss gradient가 연결되지 않는다. 초기 x/y head는 최종 x/y head와도 별개다. ‘선택용이므로 인코더만 detach했다’는 말로 끝낼 수 없고, 초기 head 자체를 학습시키는 경로가 따로 있는지도 확인해야 한다.
검토한 CIGHead.loss()와 설정에서는 그 head를 직접 지도하는 별도 손실을 찾지 못했다. 그러므로 이 코드만 근거로 초기 head를 ‘학습된 uncertainty estimator’라고 단정하지 않는다. 실제 공개 체크포인트에서의 상태나 전체 학습 재현은 별도 검증이 필요하다. 학습 함수 · config
Part 4. HGNN — 관절과 부위를 번갈아 본다
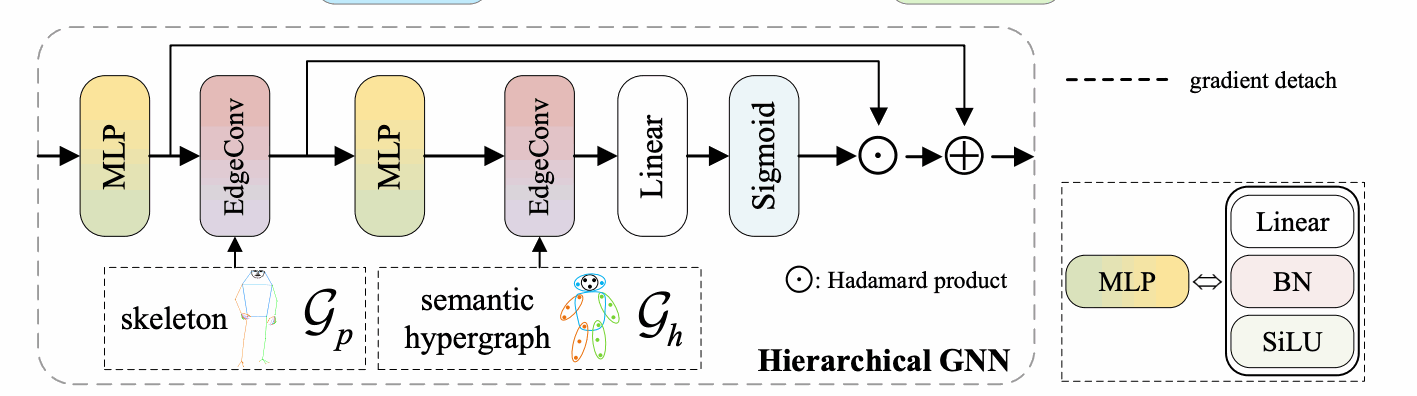 출처: 논문 Fig. 5 하단을 원문에서 추출. 아래 수식은 이 개요 그림을 공개 코드의 실제 연산 순서로 풀어 쓴 것이다.
이제 CIM 출력은 [B, 133, 512]다. HGNN의 최종 출력도 같은 크기다. 크기를 유지한다고 같은 정보인 것은 아니다. 연결된 관절과 부위 정보를 반영해 표현을 바꾼다.
① 입력 투영과 국소 EdgeConv
먼저 입력을 Linear → BatchNorm → SiLU로 처리한다. BatchNorm을 위해 배치와 관절을 합쳐 [B×133, 512]로 다룬다.
[코드 기반 재구성: HGNN 입력 투영]
\[x_i=\operatorname{SiLU}\left(\operatorname{BN}(W_{\mathrm{in}}f'_i+b_{\mathrm{in}})\right)\]선택한 config의 골격 연결 180쌍은 양방향 360개 edge로 바뀐다. 각 edge에서 현재 관절의 특징과 이웃과의 차이를 이어 붙인다.
[코드 기반 재구성: 국소 EdgeConv와 집계]
\[m_{i\leftarrow j}=\operatorname{SiLU}\left( \operatorname{BN}\left(W_p[x_i\,\Vert\,(x_j-x_i)]\right)\right)\] \[v_i=\operatorname{BN}\left(\sum_{j\in\mathcal N(i)}m_{i\leftarrow j}\right)\]512차원 두 개를 이어 붙여 1024차원이 되고, 1×1 Conv가 이를 512차원으로 바꾼다. 여기서 1×1은 이미지의 2차원 이웃을 훑는 필터라고 생각하기보다, edge 특징의 채널을 변환하는 연산으로 보면 된다.
그렇다면 이웃의 정보는 어디에 들어갈까? 이미 concat 입력에 이웃과의 차이가 들어 있고, 연결된 이웃의 메시지를 더하는 단계에서도 관계를 사용한다. 코드의 index_add_는 합 집계다. 이 구현을 max aggregation이라고 설명하면 틀린다. EdgeConv·HGNN 구현
② 관절을 의미 그룹으로 묶기
다음 단계에서는 관절 특징을 512차원에서 128차원으로 줄이고, 그룹 안의 관절을 평균낸다. 선택 config에는 32개 그룹이 있다. 그룹은 서로 겹칠 수 있다. 얼굴 전체 그룹과 눈·코·입 그룹이 함께 있는 식이다.
[코드 기반 재구성: 채널 축소와 그룹 평균]
\[d_i=\operatorname{SiLU}\left(\operatorname{BN}(W_dv_i+b_d)\right),\qquad g_e=\frac1{|e|}\sum_{i\in e}d_i\]이 단계의 크기는 [코드 기반 재구성]으로 [B, 133, 128] → [B, 32, 128]이다. 논문이 semantic hypergraph라고 부르는 관계를 코드에서는 관절의 그룹 소속과 그룹 특징 간 그래프 연산으로 구현한다.
각 그룹은 자기 자신을 제외한 다른 31개 그룹과 연결된다. 따라서 그룹 그래프는 992개의 방향성 edge를 갖는다. 이 그래프에서 다시 EdgeConv를 적용해 전신의 부위 정보를 교환한다.
[코드 기반 재구성: 그룹 간 메시지 집계]
\[u_e=\sum_{q\ne e}\operatorname{SiLU}\left( \operatorname{BN}\left(W_h[g_e\,\Vert\,(g_q-g_e)]\right)\right)\]③ 그룹 gate를 다시 관절로 돌려주기
그룹의 128차원 특징을 Linear로 512차원으로 늘리고 sigmoid를 적용한다. 이렇게 만든 각 성분은 0과 1 사이의 조절 계수다.
[코드 기반 재구성: 그룹 gate와 관절별 평균]
\[a_e=\sigma(W_au_e+b_a),\qquad a_i=\frac1{|\mathcal E_i|}\sum_{e\in\mathcal E_i}a_e\]한 관절이 여러 그룹에 포함되면 그 그룹들의 gate를 평균한다. 어떤 그룹에도 포함되지 않은 관절에는 코드가 gate 1을 유지한다. 선택 config에서 실제로 어떤 그룹에 속하는지는 그룹 정의를 기준으로 확인해야 한다.
이제 처음의 국소 특징과 원소별로 곱한 뒤 residual을 더한다.
[코드 기반 재구성: HGNN 한 층의 출력]
\[x_i^{\mathrm{out}}=\operatorname{SiLU}\left(x_i+v_i\odot a_i\right)\]이 식을 말로 풀면 “연결된 이웃에서 모은 특징을 전신 그룹의 정보로 조절하고, 기본 특징에 더한다”다. 잔차로 더하는 것은 입력 투영 후의 특징이다. 논문 본문의 간략한 gate 식에는 생략된 투영·정규화·잔차까지 공개 코드에는 들어 있으므로, 위 식들은 논문 원문 식과 구분했다.
Part 5. 마지막 SimCC head — 이제 좌표를 만든다
HGNN 출력에 서로 다른 두 선형층 cls_gx, cls_gy를 적용한다. [코드 기반 재구성]으로 x logits는 [B, 133, 576], y logits는 [B, 133, 768]이다. CIM의 초기 head와 이름도, 파라미터도 다르다.
학습에서는 이 logits와 정답 SimCC label을 비교한다. 추론에서는 각 축의 최대 위치를 선택하고 split ratio로 나눈다.
[코드 기반 재구성: SimCC decode의 좌표 선택, split ratio=2]
\[\hat x_k=\frac{\arg\max_i h_{k,x}(i)}2,\qquad \hat y_k=\frac{\arg\max_j h_{k,y}(j)}2\]이 좌표는 변환된 사람 crop의 좌표다. 원본 이미지에 관절을 그리려면 crop을 만들 때의 변환을 되돌리는 과정까지 필요하다. 모델 출력 벡터, crop 내부 좌표, 원영상 좌표를 같은 것으로 취급하면 안 된다. SimCC decoder
Part 6. 두 손실을 실제 학습 경로에 연결하기
Keypoint loss는 교체된 관절에만 걸리지 않는다
먼저 정답 자세를 맞히는 기본 손실이다.
[논문 원문: 식 (5)]
\[\mathcal L_{\mathrm{kpt}}=\sum_{k=1}^{K}w_k D_{\mathrm{KL}}\left(Q_k\parallel P(Y_k\mid do(F))\right)\]정답 분포가 Q, 반사실 경로의 최종 예측이 비교 대상이다. 이 식의 개입 표기는 논문의 표기를 따른다. 실제 코드에서는 특징을 바꾼 경로의 출력을 사용한다.
핵심은 개입하지 않은 관절도 기본 손실에 들어간다는 것이다. 정답 가중치가 유효하면 모두 자세를 맞혀야 한다. 반대로 정답 가중치가 0인 키포인트는 이 손실에 기여하지 않는다. 가중치는 치환 마스크가 아니다.
실제 KLDiscretLoss에는 논문의 간략한 식보다 세부 계산이 더 있다. 선택 설정은 예측 logits에 beta=10을 곱하고, 정답 label에도 softmax를 적용한다. 각 축의 bin에 대해 평균을 구한 뒤 가중치를 곱하고, 배치·관절의 합을 K로 나눈다. 코드의 loss 숫자를 논문 식의 단순 KL 합과 같은 척도로 비교하면 안 된다. KLDiscretLoss
Consistency loss는 멀쩡한 관절의 예측을 기준에 묶는다
[논문 원문: 식 (6)]
\[\mathcal L_{\mathrm{cf}}=\frac1{|S|}\sum_{k\in S} D_{\mathrm{KL}}\left(\operatorname{sg}[P(Y_k\mid F)]\parallel P(Y_k\mid do(F))\right)\]관찰 경로의 예측은 고정된 목표다. 반사실 경로가 그 목표에서 불필요하게 멀어지는 것을 막는다. 코드에서 실제로 선택하는 mask는 다음과 같다.
stable_mask = (~intervened_mask) & (keypoint_weights > 0)
출처: CounterfactualConsistencyLoss. 개입하지 않았다는 조건과 정답 가중치가 유효하다는 조건을 동시에 사용한다.
KL의 방향도 확인해야 한다. PyTorch의 kl_div는 첫 인자로 예측의 log probability, 두 번째 인자로 목표 probability를 받는다. 이 코드가 계산하는 것은 관찰 분포를 기준으로 한 반사실 분포의 KL, 즉 논문 식과 같은 방향이다. 함수의 인자 순서를 수식의 분포 순서로 그대로 옮기면 헷갈린다.
두 좌표축의 KL을 더해 유효한 안정 키포인트 수로 평균하고, loss 내부에서 가중치 0.1을 곱한다. 따라서 설정을 따라 코드를 구현할 때 바깥에서 다시 0.1을 곱하면 중복 적용이다. 안정 키포인트가 하나도 없으면 코드가 이 손실을 0으로 반환한다.
같은 GNN인데 한쪽만 고정할 수 있나?
학습 함수에서 경로를 나누면 다음과 같다. [코드 기반 재구성: 핵심 동작을 줄인 의사코드]
features = encoder(images)

# 초기 logits는 선택용. CIM 내부의 점수·Top-k도 no_grad 안에 있다.
initial = initial_heads(features.detach())
changed, mask = cim(features, initial)
pred_cf = final_heads(hgnn(changed))

# 동일한 가중치를 쓰지만 이 forward에는 autograd graph를 만들지 않는다.
with torch.no_grad():
    pred_obs = final_heads(hgnn(features))

loss_kpt = supervised_loss(pred_cf, target, target_weights)
loss_cf = consistency_loss(pred_obs, pred_cf, mask, target_weights)
loss = loss_kpt + loss_cf   # 0.1은 consistency_loss 내부에 반영됨
같은 파라미터를 공유해도 어떤 forward 계산의 gradient를 추적하는지는 경로마다 정할 수 있다. 관찰 경로로는 gradient가 돌아가지 않고, 반사실 경로로는 GNN과 최종 head를 학습한다. CIGHead.loss
여기서 no_grad()는 eval()과도 다르다. 전자는 autograd 기록을 끄고, 후자는 BatchNorm·Dropout 등의 동작 모드를 바꾼다. 이 학습 함수는 관찰 경로를 eval()로 전환하지 않는다. 따라서 ‘고정 목표’는 역전파 기준으로 고정이라는 의미이지, BatchNorm 통계까지 모두 고정한다는 뜻이 아니다.
결국 어느 파라미터까지 gradient가 가는가?
아래 표는 [코드 기반 재구성: 검토한 학습 경로의 도달 가능성]이다. reachable은 그래프상 연결될 수 있다는 뜻이며, 매 샘플에서 반드시 0이 아닌 gradient가 생긴다는 보장은 아니다.
| 파라미터 또는 경로 | Keypoint loss | Consistency loss |
|---|---|---|
| Backbone · 7×7 Conv · 투영 · GAU | reachable — 유지된 특징을 통해 | reachable — 반사실 경로의 유지된 특징을 통해 |
| 선택된 정준 임베딩 행 | reachable | reachable — GNN의 특징 혼합 등을 통해 안정 관절에도 영향을 줄 수 있음 |
| 해당 배치에서 선택되지 않은 정준 임베딩 행 | not involved — lookup되지 않음 | not involved — lookup되지 않음 |
| HGNN | reachable — 반사실 경로 | reachable — 반사실 경로 |
| 최종 x/y head | reachable | reachable |
| 초기 x/y head | blocked by no_grad — 선택 경로만 사용 | blocked by no_grad — 선택 경로만 사용 |
부모 RTMCCHead에서 생성됐으나 대체된 mlp, cls_x, cls_y |
not involved — CIGHead의 이 학습 경로에서는 호출하지 않음 | not involved — 이 학습 경로에서는 호출하지 않음 |
| 관찰 경로의 forward | not involved | blocked by no_grad / detach — 목표만 제공 |
| Top-k 선택 자체 | blocked by no_grad — 이산 선택 | blocked by no_grad — 이산 선택 |
두 가지를 더 구분하자.
첫째, 원래 관절 특징을 덮어쓴 그 위치의 직접 경로는 끊기지만, Encoder 전체가 학습되지 않는 것은 아니다. 유지된 다른 관절 특징으로 gradient가 갈 수 있고, GAU 앞쪽에서는 토큰 사이의 관계도 이미 섞여 있다.
둘째, Consistency loss는 바꾸지 않은 관절의 출력에서 계산되지만, 그 출력은 GNN을 통해 바꾼 관절의 특징에도 의존할 수 있다. 그래서 이 손실도 선택된 정준 임베딩을 학습시킬 수 있다. ‘loss를 계산한 관절’과 ‘gradient를 받는 모든 파라미터’는 같은 범위가 아니다.
[보충자료: C절 식 (9), 치환 마스크를 고정했을 때]
\[\frac{\partial\mathcal L}{\partial z_k} =\sum_{b=1}^{B}m_{b,k}\frac{\partial\mathcal L}{\partial f'_{b,k}}\]선택된 이미지들에서 같은 관절의 정준 벡터로 gradient가 모인다. 선택되지 않은 행은 이 loss의 gradient를 받지 않지만, 그것을 곧바로 ‘optimizer step 후 파라미터 값이 절대 안 바뀐다’로 확대하면 안 된다. optimizer의 상태나 weight decay에 따른 갱신은 loss gradient와 구분해야 한다.
Part 7. 코드까지 읽고 나면 설명이 조금 달라진다
처음에는 “불확실한 관절을 기준 벡터로 바꾸고 GNN으로 보완한다”로 이해했다. 코드를 읽고 나니 그 문장에 조건들이 붙었다.
- 바꾸는 대상은 좌표가 아니라 특징 벡터다.
- 기준 벡터는 이미지마다 새로 만드는 것이 아니라 관절 유형별 공유 파라미터다.
- 선택한 config는 학습 Top-13, 추론 Top-1을 사용한다.
- 초기 선택용 head와 최종 좌표 head는 별개이며, 검토한 학습 코드에서 초기 head로 이어지는 loss gradient는 확인되지 않는다.
- 기본 손실은 유효한 모든 관절, 일관성 손실은 개입하지 않은 유효 관절의 출력에서 계산한다.
- 관찰 경로는 gradient를 막지만, 같은 HGNN과 최종 head는 반사실 경로에서 학습된다.
내가 이 구현에서 가장 오래 헷갈렸던 것은 ‘어디를 바꿨는가’, ‘어디에서 loss를 계산하는가’, ‘어디까지 gradient가 흐르는가’가 모두 다른 질문이라는 점이었다. 세 개를 나눠 보고 나니, 정준 임베딩이 어떻게 학습되는지도 훨씬 선명해졌다.
인과적 목표와 특징 치환의 관계는 여전히 따져볼 부분이 남는다. 하지만 적어도 모델이 실제로 하는 계산을 분리해서 설명할 수는 있다. 논문의 이름에 담긴 해석과 코드의 연산을 함께 보되, 한쪽을 다른 쪽의 증명으로 대신하지 않는 것이 이 리뷰에서 가져가고 싶은 읽기 방식이다.