3. OcclusionGateNet 개발기 3 — ORFormer는 가려진 얼굴을 어떻게 추정할까?
해설글
작성 · 5분 읽기 · 조회수 —
들어가며
얼굴의 한쪽 눈이 가려져 있다고 하자. 가려진 위치의 픽셀만 보면 그 뒤에 눈이 어디 있는지 알기 어렵다. 그래도 다른 눈, 코, 얼굴 윤곽까지 함께 보면 얼굴 구조상 그럴듯한 위치를 추정할 수는 있다.
내가 맡은 복원 파트는 이 아이디어를 모델로 구현하는 일이었다. 기반으로 사용한 것은 ORFormer(Occlusion-Robust Transformer) 다. 프로젝트 전체를 우리가 처음부터 제안한 landmark detector로 소개하는 것은 정확하지 않다. 기존 ORFormer의 구조를 가져와 DMD 얼굴과 478개 landmark를 다루도록 적용하고, HGNet 및 최종 DMS와 연결했다.
이 편에서 말하는 복원은 얼굴 사진 복원이 아니다. ORFormer가 구조 heatmap을 만들고, HGNet이 최종 랜드마크 좌표를 예측한다.
Part 1. 먼저 codebook부터 이해해보자
얼굴 구조를 벡터 사전으로 표현한다
일반적인 encoder-decoder를 생각하면, encoder가 이미지를 연속 벡터로 바꾸고 decoder가 그 벡터에서 출력을 만든다. Vector Quantization(VQ)은 중간에 학습 가능한 벡터 사전(codebook) 을 둔다.
각 위치의 encoder 출력 $z_i$를 사전 안의 벡터 중 가장 가까운 것에 대응시킨다. 프로젝트의 transformer 없는 quantization 경로는 다음처럼 쓸 수 있다.
[코드 기반 재구성 — quantizer.py의 nearest-code 경로]
- $z_i$: encoder가 만든 한 위치의 연속 표현.
- $e_k$: codebook의 $k$번째 벡터.
- $k_i$: 그 위치에 사용할 code의 번호.
현재 구성의 codebook은 2,048개 벡터, 각 벡터는 256차원이다. 이것을 ‘눈 code, 코 code, 입 code가 사람이 정한 번호로 들어 있다’고 이해하면 곤란하다. 각 항목은 학습으로 얻은 latent 표현이며, 해부학적 부위와 일대일로 이름 붙인 사전은 아니다.
이산 번호를 거치면 decoder가 임의의 벡터 대신 학습 중 익힌 code 조합을 입력받는다. ORFormer는 이 구조를 이용해, 가림이 있는 영상에서도 얼굴 구조를 설명할 code를 예측한다. 원 논문의 배경과 전체 구조는 공식 프로젝트 페이지에서 확인할 수 있다.
argmin은 미분이 안 되는데 어떻게 학습할까?
가장 가까운 번호를 고르는 연산은 일반적인 연속 미분으로 통과할 수 없다. 프로젝트 코드에서는 straight-through estimator(STE) 를 사용한다.
[코드 기반 재구성]
\[z_{\mathrm{ST}} = z + \operatorname{sg}(z_q-z)\]$\operatorname{sg}$는 stop-gradient다. forward에서는 두 $z$가 상쇄되어 codebook 벡터 $z_q$가 전달된다. backward에서는 괄호 안을 미분하지 않으므로 $z$로 gradient가 흐른다.
‘번호 선택 자체를 미분했다’는 뜻은 아니다. forward에서 사용한 값과 backward에서 사용하는 미분 경로를 다르게 둔 근사다. codebook과 encoder를 서로 가깝게 유지하는 손실도 별도로 필요하다. 학습이 여기서 무너진 기록은 다음 편에서 다룬다.
Part 2. regular와 messenger, 같은 위치를 두 번 표현하기
직접 본 표현과 주변에서 얻은 표현
ORFormer에서 흥미로웠던 부분은 한 위치에 대해 regular 표현과 messenger 표현을 함께 만든다는 점이었다.
regular 경로는 입력 feature에서 attention을 수행한다. messenger 경로는 학습 가능한 query를 사용해 입력 feature의 key/value에서 정보를 모은다. 가림으로 직접 관측이 손상된 위치에서도 다른 얼굴 부위의 관계를 이용하려는 경로다.
직관적으로는 이렇게 생각할 수 있다.
regular: “이 위치의 입력을 처리하면 이런 표현이 나온다.”
messenger: “얼굴의 다른 단서까지 이용하면 이 위치는 이런 표현이 그럴듯하다.”
둘 다 추정 결과다. messenger가 가려진 눈의 실제 상태를 알고 있는 것은 아니다. 주변 구조로 설명 가능한 부분과, 가려져서 구별할 수 없는 부분은 여전히 남는다.
두 표현의 차이에서 alpha를 만든다
프로젝트의 simple_vit.py는 두 표현을 정규화한 뒤 원소별 차이의 제곱을 만들고, 이를 학습 가능한 linear layer와 sigmoid에 통과시킨다.
[코드 기반 재구성 — 논문 수식의 직접 인용이 아님]
\[\alpha_i = \sigma\!\left( W_\alpha \left[\operatorname{LN}(h_i)-\operatorname{LN}(m_i)\right]^{\odot 2} +b_\alpha\right)\]$h_i$는 regular, $m_i$는 messenger 표현이다. $\odot 2$는 각 성분을 제곱한다는 뜻이다. 단순히 거리의 제곱에 sigmoid를 씌운 식이 아니다. 중간에 학습 가능한 선형 변환과 bias가 있으므로, 두 표현의 차이 패턴을 이용해 alpha를 학습할 수 있다.
그다음 두 경로가 예측한 codebook 표현을 alpha로 혼합한다.
[코드 기반 재구성]
\[\tilde z_i=(1-\alpha_i)z^{\mathrm{regular}}_{q,i} +\alpha_i z^{\mathrm{messenger}}_{q,i}\]alpha가 커지면 messenger 쪽 code 표현이 더 많이 들어간다. 이 alpha는 뒤의 DMS에 전달하는 외부 visibility CNN 출력과 별개다. 학습 loss와 보조 정답이 없다면 이름만으로 ‘잘 보정된 가림 확률’이라고 간주할 수도 없다.
여기서 patch는 원본 이미지의 16×16 조각이 아니다
코드의 ORFormer 설정에는 image_size=16, patch_size=1, channels=256이 들어간다. 이것만 보고 원본 얼굴을 16×16 픽셀 patch로 자른다고 생각하기 쉽다.
하지만 transformer가 받는 것은 encoder의 16×16 latent map이다. 그 격자의 한 위치를 token으로 다룬다. 원본 crop의 해상도, latent map의 해상도, codebook의 차원은 서로 다른 숫자다. 이 구분은 다음 편의 ‘478개 landmark 가림 라벨을 256개 token으로 어떻게 옮기는가?’라는 문제와 연결된다.
Part 3. ORFormer의 출력이 곧 최종 좌표일까?
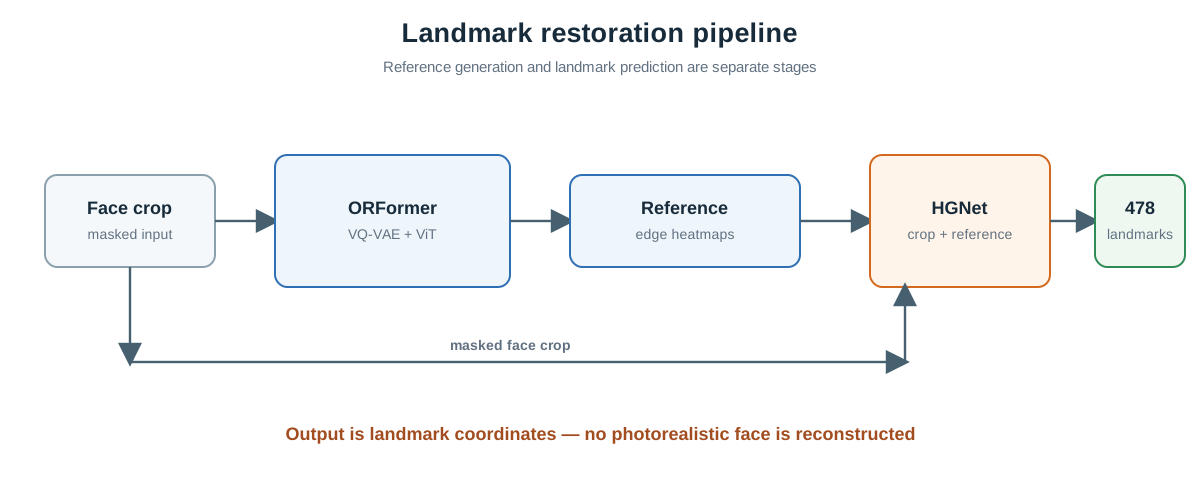
현재 런타임에서는 얼굴 crop을 두 크기로 준비한다. ORFormer 쪽은 64×64, HGNet 쪽은 256×256 입력을 받는다. 흑백 NIR crop을 채널 방향으로 복제하고 정규화하는 전처리도 포함된다.
ORFormer의 decoder 출력은 reference edge heatmap이다. 얼굴의 구조를 공간적인 응답으로 표현해 HGNet에 전달한다. HGNet은 이 reference와 더 높은 해상도의 얼굴 입력을 함께 받아 최종 좌표를 예측한다.
| 단계 | 입력 | 출력 |
|---|---|---|
| ORFormer를 포함한 VQ 모델 | 작은 얼굴 crop | reference edge heatmap |
| HGNet | 얼굴 crop + reference heatmap | 478개 landmark의 2D 위치 |
| 런타임 좌표 변환 | crop 기준 예측 | 원본 프레임 좌표계의 위치 |
런타임 wrapper는 최종 배열 형태를 맞추기 위해 z 채널에 0을 붙인다. 따라서 출력이 (478, 3) 형태라고 해서 복원 모델이 얼굴의 3D 깊이까지 복원한 것은 아니다. 형태와 의미를 따로 확인해야 하는 지점이다.
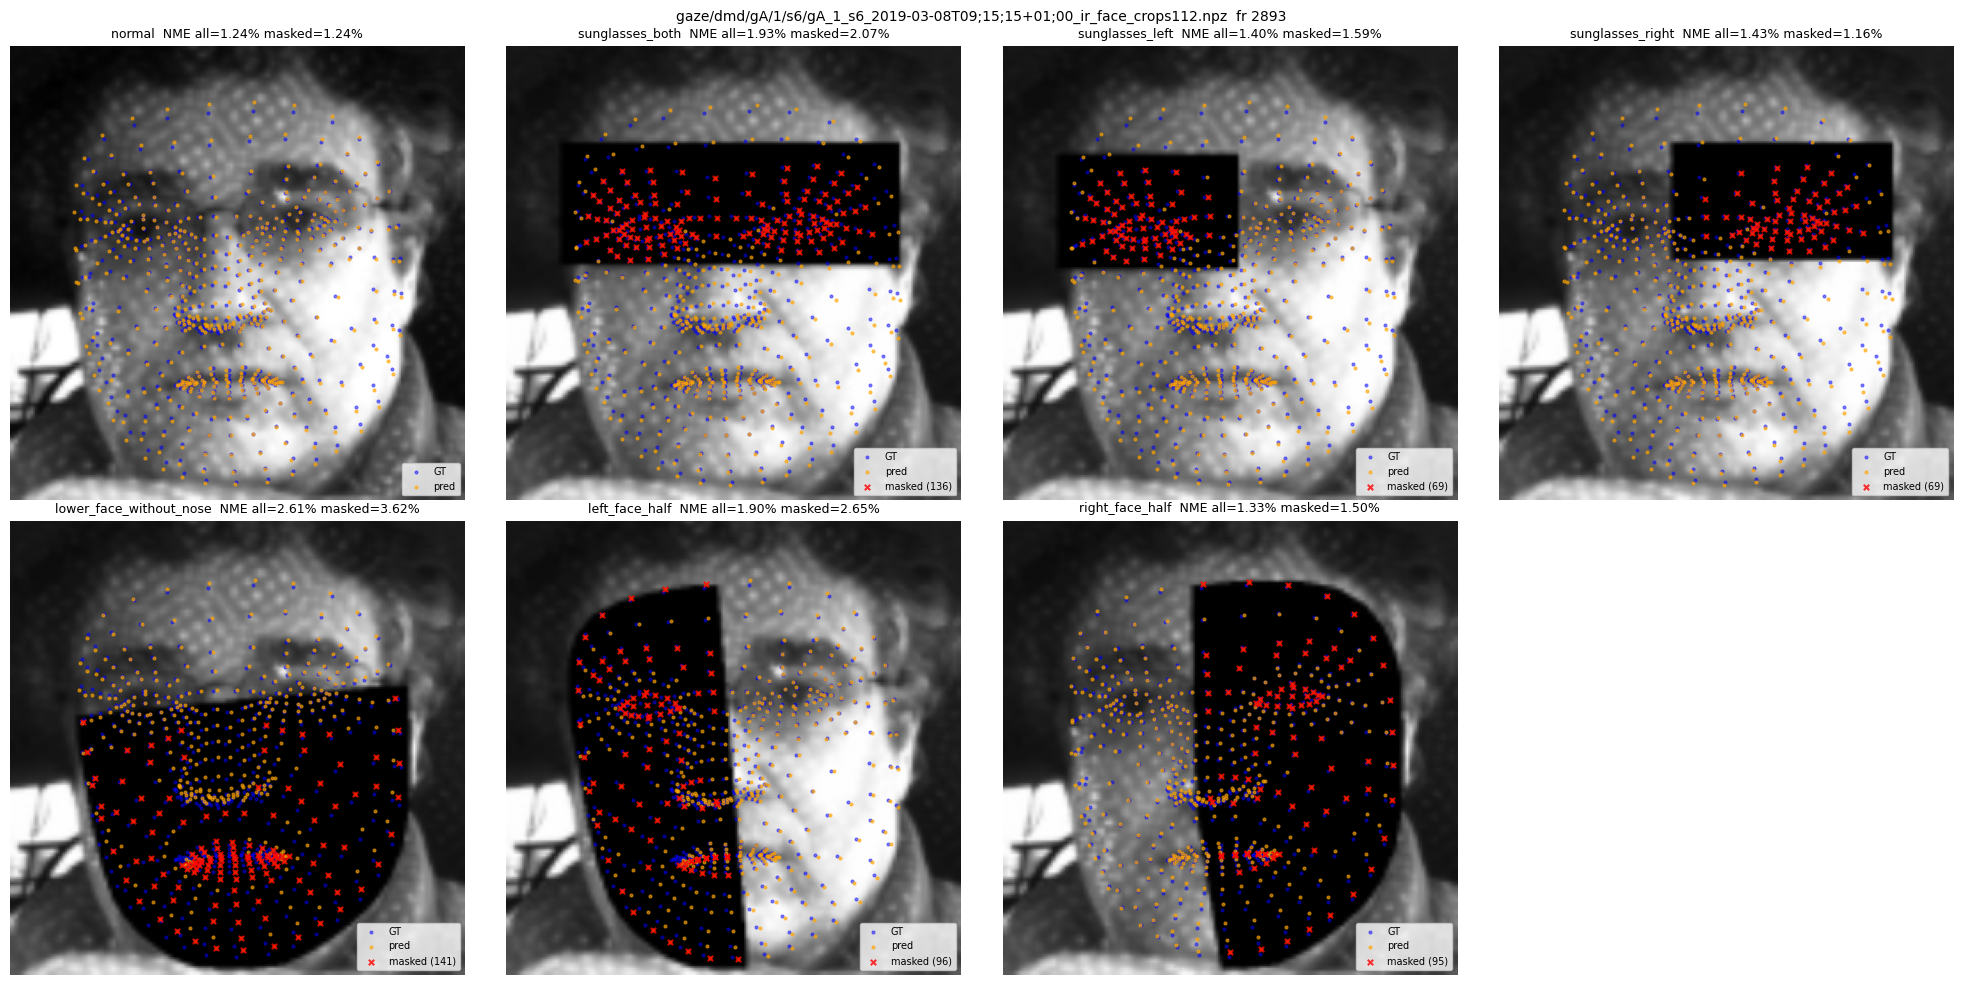
저장소의 정성적 복원 예시. 가려진 영역에서도 얼굴 형태를 추정하는 모습을 보여주지만, 이 그림만으로 전체 데이터의 오차나 gaze 분류 성능을 알 수는 없다.
Part 4. 논문의 아이디어와 이 저장소의 구현 사이
논문을 읽을 때는 ‘가려진 token을 제외하고 다른 token에서 정보를 모은다’는 개념으로 이해할 수 있다. 그런데 실제 적용 코드를 설명할 때는 그 말이 어떤 연산인지 확인해야 한다.
예를 들어 이 저장소의 messenger attention은 대각 성분의 logit을 0으로 설정한다. softmax 이전의 값을 0으로 만드는 것은 해당 attention 확률을 반드시 0으로 만드는 것과 다르다. 엄격히 배제하려면 보통 softmax에서 확률이 0이 되는 마스킹이 필요하다. 따라서 이 글에서는 ‘자기 위치 정보를 완전히 제거한다’고 단정하지 않는다.
또한 code 선택에는 argmax가 들어간다. STE가 있다고 해서 그 선택을 만든 모든 logit에 reconstruction loss가 그대로 흐르는 것은 아니다. codebook 조회, encoder의 STE 경로, alpha의 혼합 경로를 각각 확인해야 한다. 원 논문의 학습 절차를 그대로 재현했다는 주장과, 이 저장소의 loss로 학습했다는 주장은 구분했다.
이런 차이는 아이디어를 부정하려는 이야기가 아니다. 모델 이름이 같아도 이식 과정에서 입력·출력·loss·마스킹 구현이 달라질 수 있다는 뜻이다. 이번 프로젝트에서는 478개 landmark로 확장하고 DMS에 연결하는 과정 자체가 중요한 작업이었다.
다음 편에서는 실제 학습 기록을 펼쳐본다. 구조는 그럴듯한데 codebook이 거의 같은 번호만 사용한다면, 어디부터 확인해야 할까?