6. OcclusionGateNet 개발기 6 — 복원과 gate는 실제로 도움이 되었을까?
해설글
작성 · 7분 읽기 · 조회수 —
들어가며
앞선 글에서는 가림을 복원하고, 가시성에 따라 얼굴과 자세를 섞는 구조를 설명했다. 이제 남은 질문은 하나다. 그래서 실제로 도움이 되었을까?
여기서는 저장소의 결과 CSV를 기준으로 비교한다. 보기 좋은 결과만 뽑기보다, 어느 과제에서 도움이 되었고 어느 과제에서는 그렇지 않았는지 함께 보려고 한다. 발표 자료를 다시 읽으면서 발견한 단위 표기도 바로잡았다.
먼저 결론의 범위를 정하면 이렇다. 기록된 고정 분할 실험에서 full 모델의 masked gaze 점수가 주요 ablation보다 높았다. 그러나 모든 과제에서 full이 최고는 아니며, ablation 이름만으로 각 모듈의 순수한 인과 효과를 확정할 수도 없다.
Part 1. 무엇을 어떤 단위로 평가했나?
Macro-F1은 accuracy와 다르다
이 글의 주 지표는 clip 단위 macro-F1이다. 클래스마다 F1을 계산한 뒤 같은 비중으로 평균한다.
[설명용 유도 — 평가 지표의 정의]
\[\operatorname{MacroF1}=\frac{1}{K}\sum_{k=1}^{K} \frac{2\operatorname{Precision}_k\operatorname{Recall}_k} {\operatorname{Precision}_k+\operatorname{Recall}_k}\]예를 들어 action의 흔한 클래스에서 많이 맞혔다고, 드문 클래스의 실패가 표본 수만큼 작게 반영되는 방식은 아니다. 그렇다고 클래스별 성능이 전부 같은 것도 아니다. 평균 하나로는 어떤 동작이나 시선 구역을 혼동했는지 알 수 없으므로 뒤에서 confusion도 함께 본다.
주 결과와 재학습 ablation은 같은 CSV의 값을 사용한다. split은 fixed manifest, seed는 42다. fusion·외부 비교 표는 별도의 요약 CSV에서 가져왔다. 이름이 비슷한 실험이 많아서 어느 표의 baseline인지를 붙여 읽는 것이 중요하다.
Part 2. clean에서 masked로 바뀌면
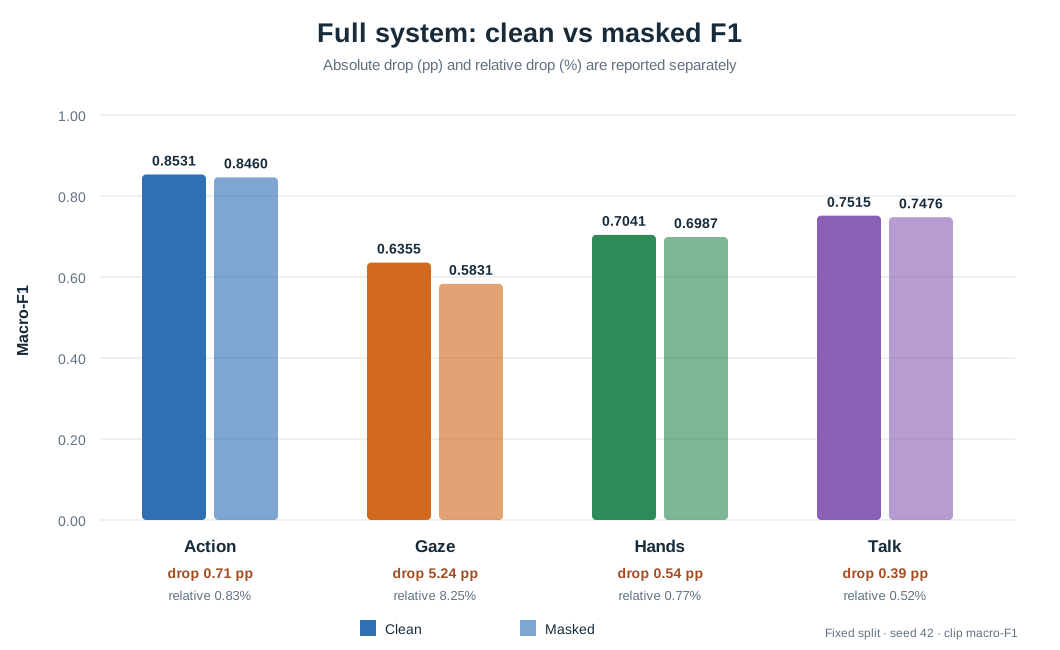
원시 CSV의 full 행으로 다시 그린 그래프. pp는 절대 차이, %는 clean 대비 상대 감소율이다.
| Task | Clean F1 | Masked F1 | 절대 감소 | 상대 감소 |
|---|---|---|---|---|
| Action | 0.8531 | 0.8460 | 0.71pp | 0.83% |
| Gaze | 0.6355 | 0.5831 | 5.24pp | 8.25% |
| Hands | 0.7041 | 0.6987 | 0.54pp | 0.77% |
| Talk | 0.7515 | 0.7476 | 0.39pp | 0.52% |
가장 큰 감소는 gaze다. 얼굴 가림을 다루는 프로젝트에서 가장 직접적인 영향을 기대할 수 있는 과제이기도 하다. action·hands·talk의 변화는 이 표에서 상대적으로 작았다. 다만 과제마다 baseline 수준과 라벨 분포가 다르므로, 감소량만으로 난이도를 순위 매길 수는 없다.
8.3%와 8.3%p는 다르다
기존 보고서의 gaze 감소 설명에는 약 8.3%p라는 표현이 있다. 원시 값으로 계산하면 다음과 같다.
[설명용 유도 — CSV의 gaze 값으로 계산]
\[\text{절대 감소}=100(0.6355-0.5831)=5.24\ \mathrm{pp}\] \[\text{상대 감소}=100\frac{0.6355-0.5831}{0.6355}\approx8.25\%\]즉 약 8.3%는 상대 감소율이다. 블로그에서는 이를 5.24pp 또는 상대 8.25%로 구분해서 표기한다. 반올림 차이가 아니라 분모가 있는 계산과 없는 계산의 차이다.
Part 3. 모듈을 바꾸고 다시 학습하면
추론 중 입력을 끄는 실험과 재학습은 다르다
full 모델을 학습한 뒤 추론할 때만 입력을 0으로 만들면, 모델이 익숙하지 않은 입력 조합에 반응하는 결과를 보게 된다. 여기의 ablation은 변경된 입력·융합 조건으로 각각 다시 학습한 결과다.
다만 no_body, no_face는 코드 구조를 물리적으로 삭제하는 것이 아니라, 해당 입력을 zero 처리하는 설정으로 학습한다. 이름을 줄여 쓰더라도 실제 조작은 구분해둘 필요가 있다.
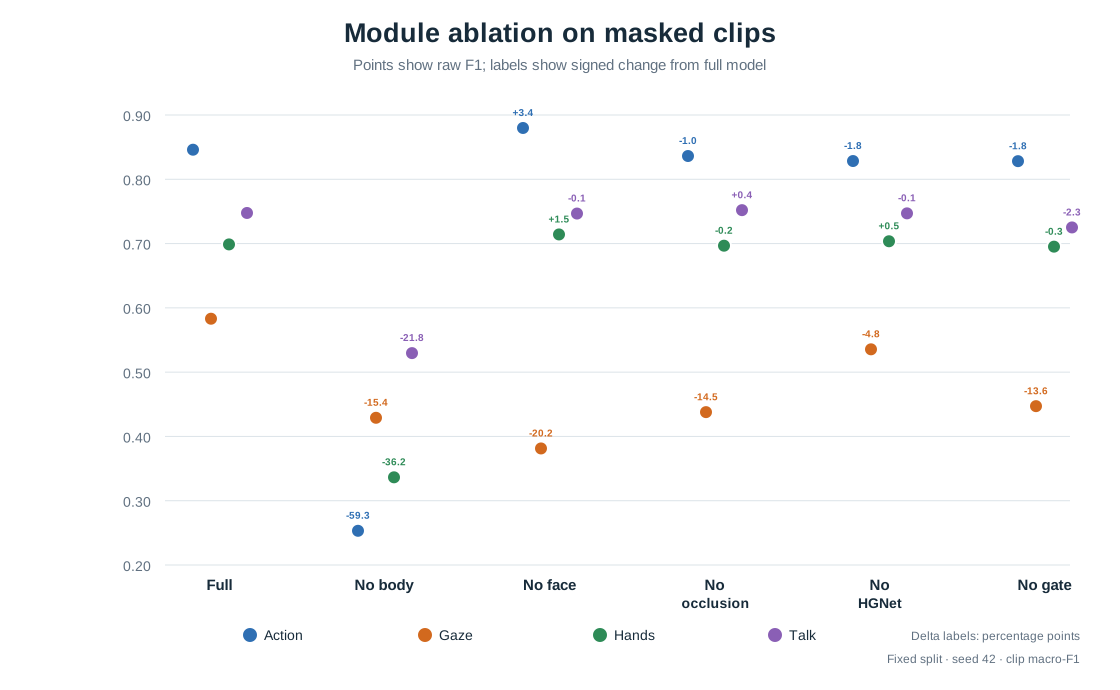
원시 masked F1을 그대로 표시했다. full보다 높은 ablation도 숨기지 않는다. no_occ는 아래에서 설명하는 gate conditioning 변경이며, 모든 가시성 경로의 제거를 뜻하지 않는다.
| 재학습 조건 | Action | Gaze | Hands | Talk |
|---|---|---|---|---|
| Full | 0.8460 | 0.5831 | 0.6987 | 0.7476 |
no_body |
0.2532 | 0.4290 | 0.3364 | 0.5296 |
no_face |
0.8798 | 0.3813 | 0.7142 | 0.7467 |
no_occ |
0.8362 | 0.4378 | 0.6967 | 0.7520 |
no_hgnet |
0.8284 | 0.5355 | 0.7036 | 0.7470 |
no_gate |
0.8282 | 0.4471 | 0.6952 | 0.7251 |
얼굴이 모든 과제에 도움이 된 것은 아니다
body 입력을 zero로 학습한 조건은 action과 hands에서 크게 낮아졌다. 이 두 과제에서 몸의 움직임이 중요한 단서라는 해석과 맞는다.
반면 face landmark 입력을 zero로 학습한 조건은 gaze가 0.3813으로 내려갔지만, action은 0.8798로 full보다 3.38pp 높았다. hands도 full보다 높았다.
그래서 이 표에서 읽을 수 있는 것은 ‘얼굴을 넣으면 무조건 좋아진다’가 아니다. 얼굴 정보의 이득이 특히 gaze에 나타났고, 다른 과제에는 trade-off가 있었다. 얼굴 feature의 잡음, multi-task 공유 방식, loss 가중치, 학습 변동 중 무엇이 원인인지는 이 표 하나로 분리할 수 없다.
no_face에도 occ 입력 등 다른 얼굴 유래 정보가 남을 수 있다는 점도 기억해야 한다. 이것을 완전한 body-only 시스템과 동일시하지 않았다.
HGNet을 사용한 조건의 차이
no_hgnet은 복원 좌표 cache로 바꾸는 설정을 끄고 raw MediaPipe를 사용한다. gaze는 0.5355, full은 0.5831로 차이는 4.76pp다. 기록된 이 조건에서는 복원 좌표를 사용하는 구성이 더 높은 gaze 점수를 냈다.
그렇다고 복원 모델 하나가 다른 모든 조건과 독립적으로 정확히 4.76pp를 만들어냈다고 보지는 않는다. 변경된 입력으로 분류기도 재학습되었고, 단일 seed 결과이기 때문이다. 표현을 조금 좁히면 결과 자체는 더 명확해진다.
no_occ라는 이름에서 멈추면 안 되는 이유
generate_configs.py에서 이 조건은 region_gate_condition_occ와 scalar_gate_condition_occ를 false로 바꾼다. 즉 학습된 gate 네트워크에 occ를 조건 입력으로 주는 부분을 끈다.
하지만 현재 공개된 explicit fusion 구현에는 region gate에 visibility reliability를 곱하는 별도 경로가 남아 있다. 그 경로는 위 두 flag로 꺼지지 않는다. occ.enabled와 복원 cache 설정도 그대로다.
따라서 full과 no_occ의 gaze 차이 14.53pp를 ‘가시성 정보 전체의 기여도’로 소개하면 과하다. 이 글에서는 공개 config가 정의한 conditioning ablation의 관측 차이로만 사용한다. 완전한 Occ 제거를 평가하려면 명시적 reliability와 복원 좌표 선택 등 남은 경로도 함께 정의하고 다시 실험해야 한다. 설정 생성 코드와 fusion 구현을 같이 읽어 확인한 부분이다.
no_gate도 마찬가지다. 이 조건은 task별 mask fusion을 concat_condition으로 교체한다. ‘어떤 조건 정보도 없는 단순 모델’로 자동 해석하기보다는, 융합 방식을 교체한 비교라고 부르는 편이 정확하다.
Part 4. 다른 fusion과의 비교
아래는 재학습 ablation 표와 다른 실험 묶음의 masked gaze 결과다.
| Fusion 구성 | Masked gaze F1 |
|---|---|
| HGNet + explicit region·scalar mask gate | 0.5831 |
| Task region·scalar gate | 0.5550 |
| HGNet + task region·scalar gate | 0.5540 |
| Task gated late fusion | 0.5367 |
| Explicit region·scalar mask gate, HGNet 없는 구성 | 0.5164 |
| Attention bias | 0.5099 |
이 비교 묶음의 NoOcc |
0.4868 |
여기서 NoOcc는 앞의 no_occ=0.4378과 다른 실험 항목이다. 이름만 같다고 baseline 숫자를 서로 교체하면 안 된다.
최상단 구성과 이 표의 NoOcc 차이는 9.63pp다. 그러나 두 행은 복원과 융합 조건 등 여러 차이를 포함한다. 이를 ‘gate 하나로 9.63pp 향상’이라고 쓰지 않는다. 오히려 HGNet을 붙인 task region·scalar 구성이 HGNet 없는 구성보다 조금 낮다는 점을 보면, 복원과 fusion의 조합에 따라 결과가 달라졌다고 읽는 편이 자연스럽다.
Part 5. 외부 비교 모델과 통계는 어디까지 말해줄까?
별도 비교 묶음의 masked gaze 점수에는 다음 결과가 있다.
| 프로젝트 내 비교 구현명 | Masked gaze F1 |
|---|---|
| HGNet + explicit region·scalar mask gate | 0.5831 |
| DriveAct | 0.5262 |
| pose_guided | 0.4828 |
| spatiotemporal | 0.4685 |
| dfs | 0.4617 |
| skateformer | 0.4385 |
| dmd_original | 0.3985 |
이 결과는 해당 논문이 원래 발표한 benchmark 표가 아니다. 프로젝트의 입력·분할·과제·평가 환경으로 맞춘 비교 구현의 결과다. 특히 비교 README는 SkateFormer·spatiotemporal·pose-guided 계열을 공통 학습 코드에서 fusion을 교체한 controlled comparison으로 설명한다. 원 논문의 모든 구성과 학습 recipe를 그대로 재현한 공식 SOTA 대결처럼 소개하면 안 된다.
DriveAct 비교 구현과의 차이는 약 5.68pp, 상대적으로는 약 10.8%다. 이것도 이 실험에서의 masked gaze 결과다. 네 과제 전체의 동일한 향상률로 확대하지 않는다.
Bootstrap 5,000회는 학습 5,000회가 아니다
저장소에는 모델끼리 공통 sample_id를 맞춘 뒤 같은 샘플을 재추출하는 paired bootstrap 도구와 결과가 있다. 두 모델을 서로 다른 clip으로 비교하지 않도록 짝을 유지하는 방식이다.
여기서 5,000회는 저장된 예측을 재표집한 횟수다. 서로 다른 seed로 모델을 5,000번 학습한 것이 아니다. 학습 seed에 따른 변동, 같은 운전자의 여러 clip 사이 상관, 다른 촬영 환경으로의 이동까지 이 절차 하나가 해결하지는 않는다.
또한 clean/masked를 짝지으면 교집합에 포함되는 샘플이 바뀔 수 있다. 같은 모델이라도 전체 평가 표와 paired subset의 F1이 정확히 같지 않을 수 있는 이유다. 이 글에서는 단일 결과표의 점수 순서를 보고 모든 차이가 통계적으로 유의하다고 결론내리지 않는다.
Part 6. 평균 점수 다음에는 틀린 사례를 본다
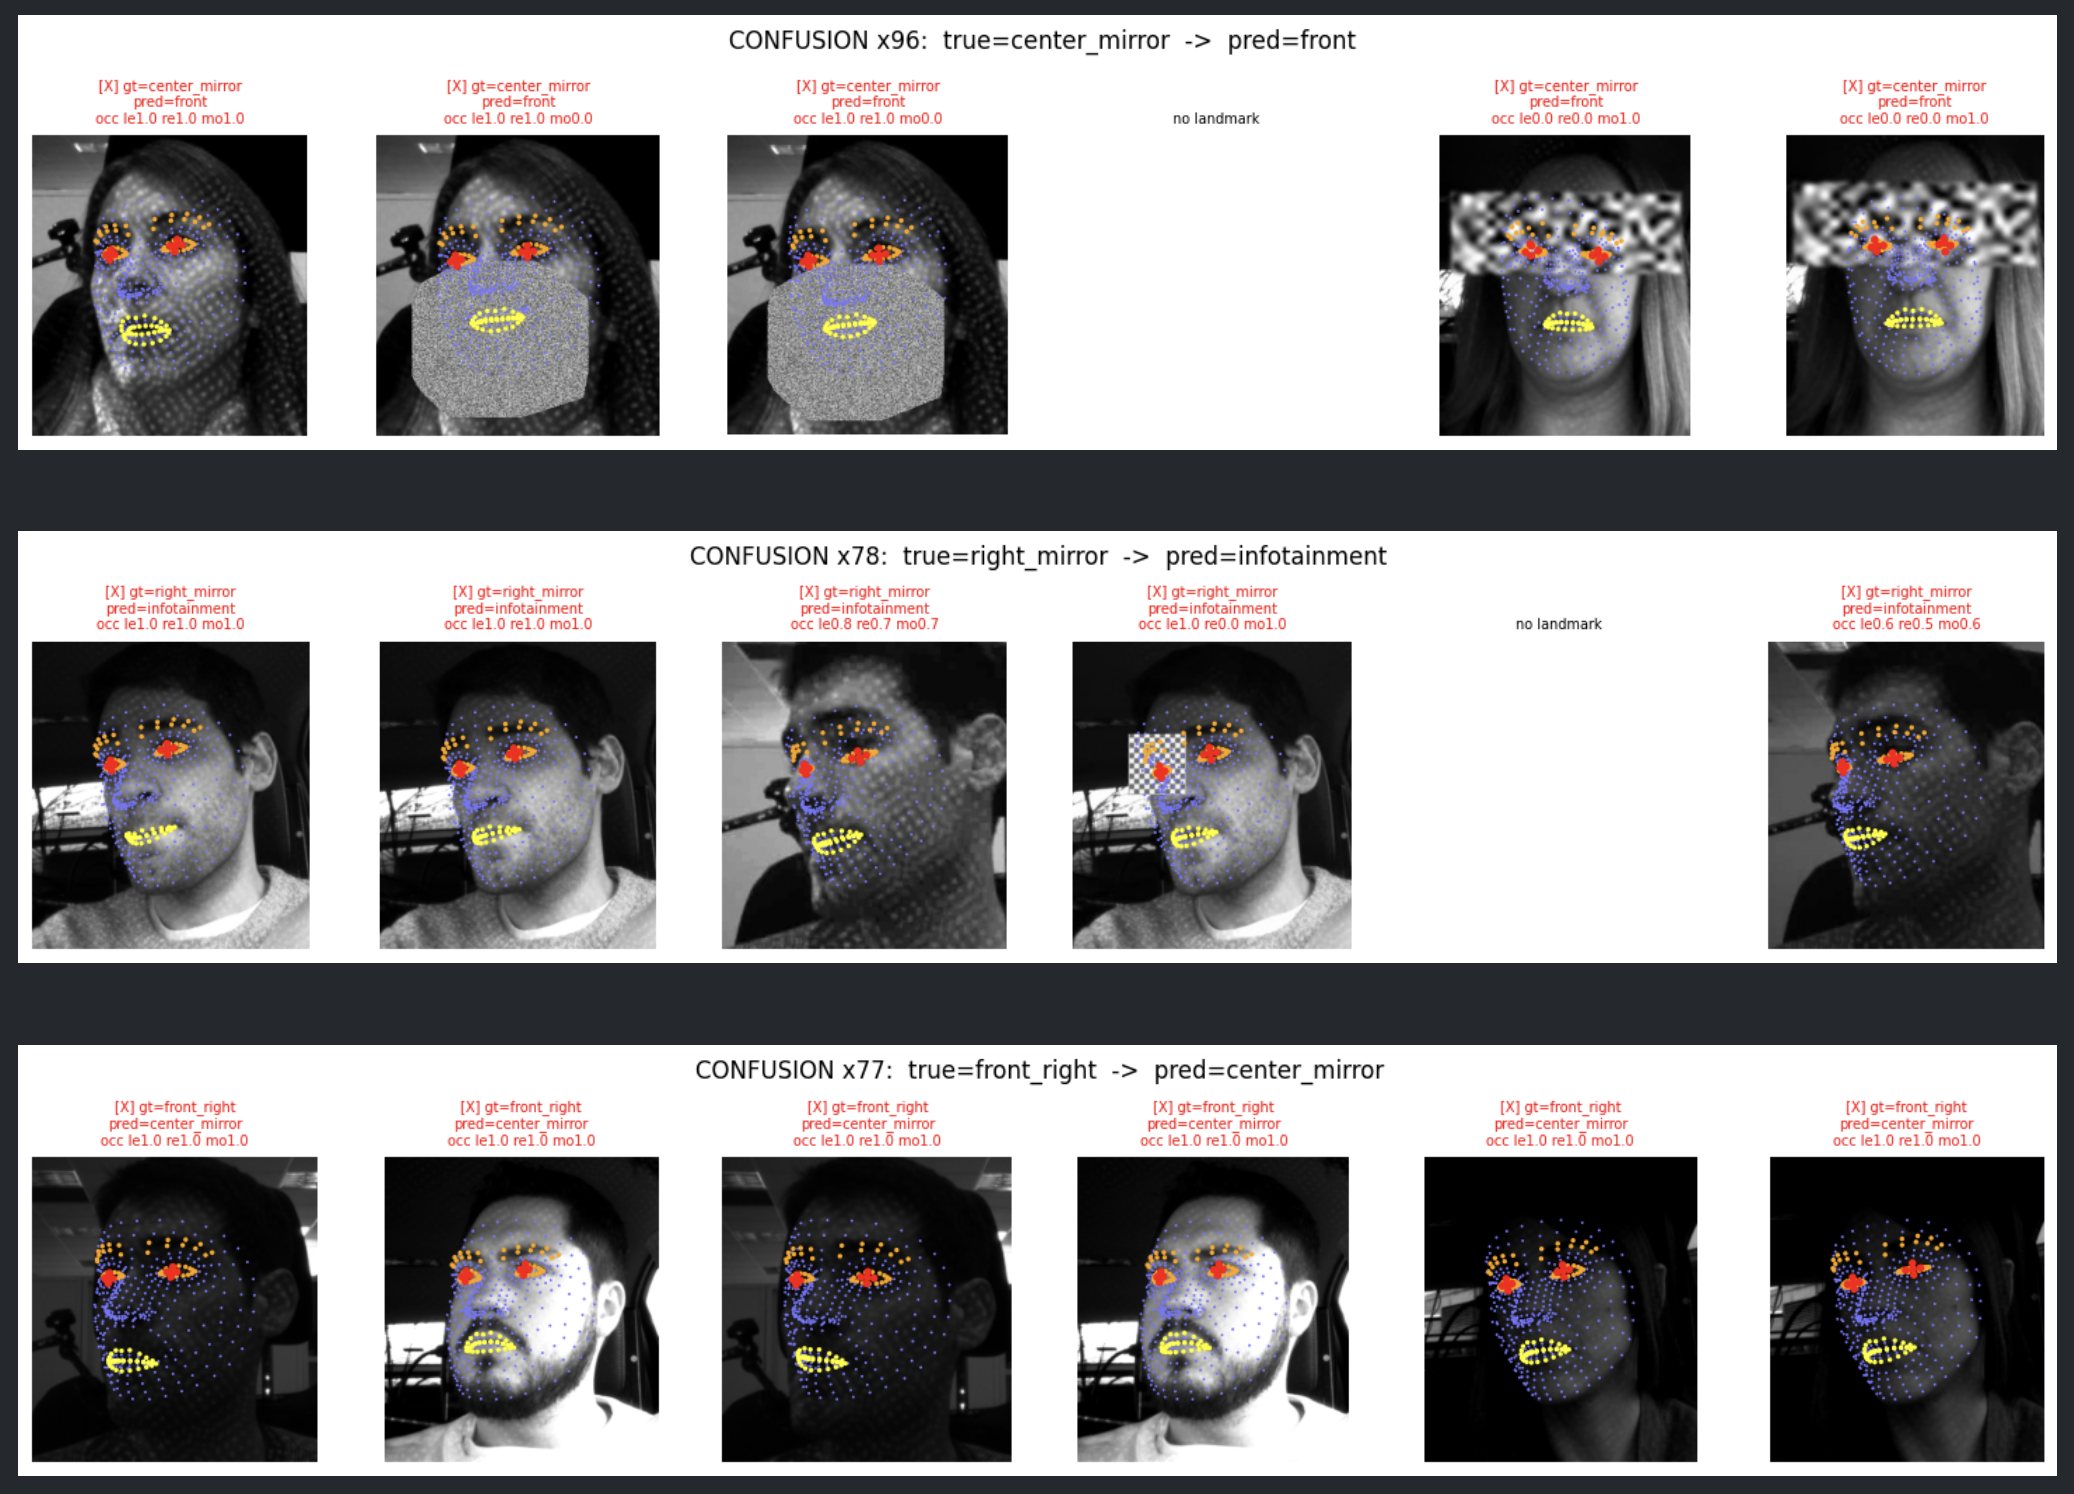
저장소의 confusion 시각화. action 11개와 gaze 9개 클래스 사이에서 어떤 혼동이 남는지 살펴보는 자료다.
좌표 기반 입력에서는 비슷한 자세를 공유하는 행동이나, 얼굴 형태 변화가 작은 시선 구역을 나누는 일이 어려울 수 있다. 다만 구체적인 오분류 원인을 확인하려면 해당 clip, 추출된 좌표, 가시성 예측, 복원 여부를 함께 봐야 한다. confusion matrix는 어디를 더 볼지 알려주는 출발점이지 원인을 자동으로 설명해주는 그림은 아니다.
이 실험에서 얻은 이야기는 하나의 최고 점수보다 조금 더 구체적이다. 얼굴 가림은 특히 gaze에 영향을 주었고, 복원과 가시성을 사용하는 구성에서 그 과제의 점수가 높았다. 동시에 얼굴 정보가 다른 과제에 항상 이득은 아니었고, 남은 코드 경로 때문에 더 엄밀히 다시 정의해야 할 ablation도 있었다.
마지막 편에서는 이 모델들을 영상 처리 시스템으로 연결한 과정과 데모, 그리고 다음에 손볼 부분을 정리한다.