2. OcclusionGateNet 개발기 2 — 가려진 얼굴의 정답은 어디서 얻을까?
해설글
작성 · 6분 읽기 · 조회수 —
들어가며
가려진 얼굴을 복원하는 모델을 만들려면 무엇이 필요할까? 입력은 가려진 얼굴이고, 정답은 가려지기 전 얼굴의 구조다. 문장으로 쓰면 간단한데, 실제 운전자 영상에는 같은 순간의 가린 얼굴과 안 가린 얼굴이 동시에 존재하지 않는다.
그래서 이 프로젝트의 데이터는 ‘영상 모으고 라벨 붙이기’에서 끝나지 않았다. 운전자 행동을 분류하는 데이터, 가시성을 판정하는 데이터, 랜드마크를 복원하는 데이터가 서로 다른 정답을 요구했다. 이름에 occlusion이 들어간다고 전부 같은 데이터셋은 아니다.
이번 편의 한 줄 요약은 이렇다.
clean 영상에서 얻은 구조를 정답으로 두고 입력에만 가림을 합성한다. 다만 그 구조도 MediaPipe가 만든 pseudo-label이라는 한계를 가진다.
Part 1. 영상의 라벨을 모델의 정답으로 바꾸기
DMD와 OpenLABEL
기본 운전자 영상은 DMD(Driver Monitoring Dataset) 를 사용했다. 프로젝트에서 다루는 정보는 얼굴과 몸 영상, 그리고 행동·시선·손·대화에 대한 annotation이다.
영상 라벨은 이미지 분류 폴더처럼 ‘이 파일은 drinking’으로 끝나지 않는다. OpenLABEL annotation에 담긴 시간 구간을 실제 프레임과 연결해야 한다. 어느 구간에서 행동이 시작되고 끝나는지, 각 과제의 라벨이 무엇인지가 학습용 clip으로 내려와야 한다.
최종 보고서에서도 이 전처리가 일정상 병목 중 하나로 기록되어 있다. 모델 입력 크기만 맞춘다고 데이터 준비가 끝나는 것이 아니다. 잘못된 구간의 정답을 붙이면, 모델은 정상적으로 loss를 계산하면서 잘못된 대응 관계를 배울 수 있다.
발표용 범주와 실제 클래스는 다르다
실제 clip 생성 코드는 행동을 다음 11개로 정리한다.
| 클래스 | 의미 |
|---|---|
safe_drive |
정상 운전; 정차·대기, 기어 변경 라벨도 이 범주로 병합 |
texting_right, texting_left |
오른손·왼손 문자 입력 |
phonecall_right, phonecall_left |
오른쪽·왼쪽 통화 |
radio |
라디오 조작 |
drinking |
물 마시기 |
reach_side, reach_backseat |
옆쪽·뒷좌석으로 손 뻗기 |
hair_and_makeup |
머리·화장 정리 |
talking_to_passenger |
동승자와 대화 |
unclassified는 학습 클래스에 추가하지 않고 제외한다. gaze는 left_mirror, left, front, center_mirror, front_right, right_mirror, right, infotainment, steering_wheel의 9개 구역이며, not_valid는 유효 gaze 정답에서 제외된다.
전방을 보는지 여부로 묶은 약한 이진 라벨도 코드에 존재한다. 하지만 최종 설정에서 이 보조 loss의 가중치는 0이다. 따라서 9개 시선 구역의 macro-F1을 ‘전방 주시 여부 정확도’라고 바꾸어 부르면 안 된다. 클립 생성 코드와 시선 클래스 정의를 함께 확인해야 하는 이유다.
Clip 길이와 모델 window 길이
최종 설정에는 clip 길이 50프레임, clip 생성 stride 25, 모델 window 48프레임, window stride 24가 등장한다. 숫자만 보면 서로 모순처럼 보이지만, 역할이 다르다. 앞의 clip은 라벨과 데이터 구간을 묶는 단위이고, window는 모델이 한 번에 읽는 시간 축의 길이다.
평가도 프레임마다 낸 예측 하나만 비교하는 것으로 이해하면 안 된다. 여러 window를 clip 예측으로 집계하는 설정이 포함되어 있다. 6편에서 사용할 점수는 이 설정 아래의 clip 단위 macro-F1이다.
Part 2. 라벨링 작업도 목적별로 나뉜다
발표 자료에는 NIR pose 모델 조정을 위한 1,000프레임 수작업 annotation과, 가시성 CNN용으로 FaceOcc·ROF·DMD·RWMF에서 모아 라벨링한 9,000장이 기록되어 있다. 각각 자세와 얼굴 가시성을 위한 작업이다. 이것을 ‘복원 정답 9,000장’이라고 읽으면 안 된다.
저장소 안의 합성 데이터 도구는 또 다른 경로다.
| 데이터·도구 | 예측하거나 학습하는 대상 | 구분해야 할 점 |
|---|---|---|
| NIR pose annotation | 몸 관절점 | 얼굴 가시성 라벨과 다름 |
| 수작업 얼굴 가시성 annotation | 부위가 보이는지 | 랜드마크 좌표 정답과 다름 |
| 합성 region crop 데이터 | 눈·입 가림 분류 등 | 예제 학습기는 3-label TinyRegionCNN |
| clean/masked 영상 쌍 | 가림 조건에서의 DMS 분류 | 원본 clip의 행동 라벨을 공유 |
| 복원 fine-tuning 중 생성한 mask | 가린 입력에서 clean 좌표 예측 | ORFormer를 고정하고 HGNet을 학습 |
특히 런타임에 쓰는 가시성 모델은 4-label VisibilityResNet18이다. data/occlusion_subset의 3-label TinyRegionCNN과 같은 모델이 아니다. 해당 폴더의 README도 배포 CNN의 정확한 학습 데이터는 그 폴더 범위 밖이라고 명시한다. 따라서 합성 데이터 생성기를 설명하면서 그대로 배포 모델의 전체 학습 이력이라고 연결하지 않았다.
Part 3. 가림을 합성하면 무엇을 통제할 수 있을까?
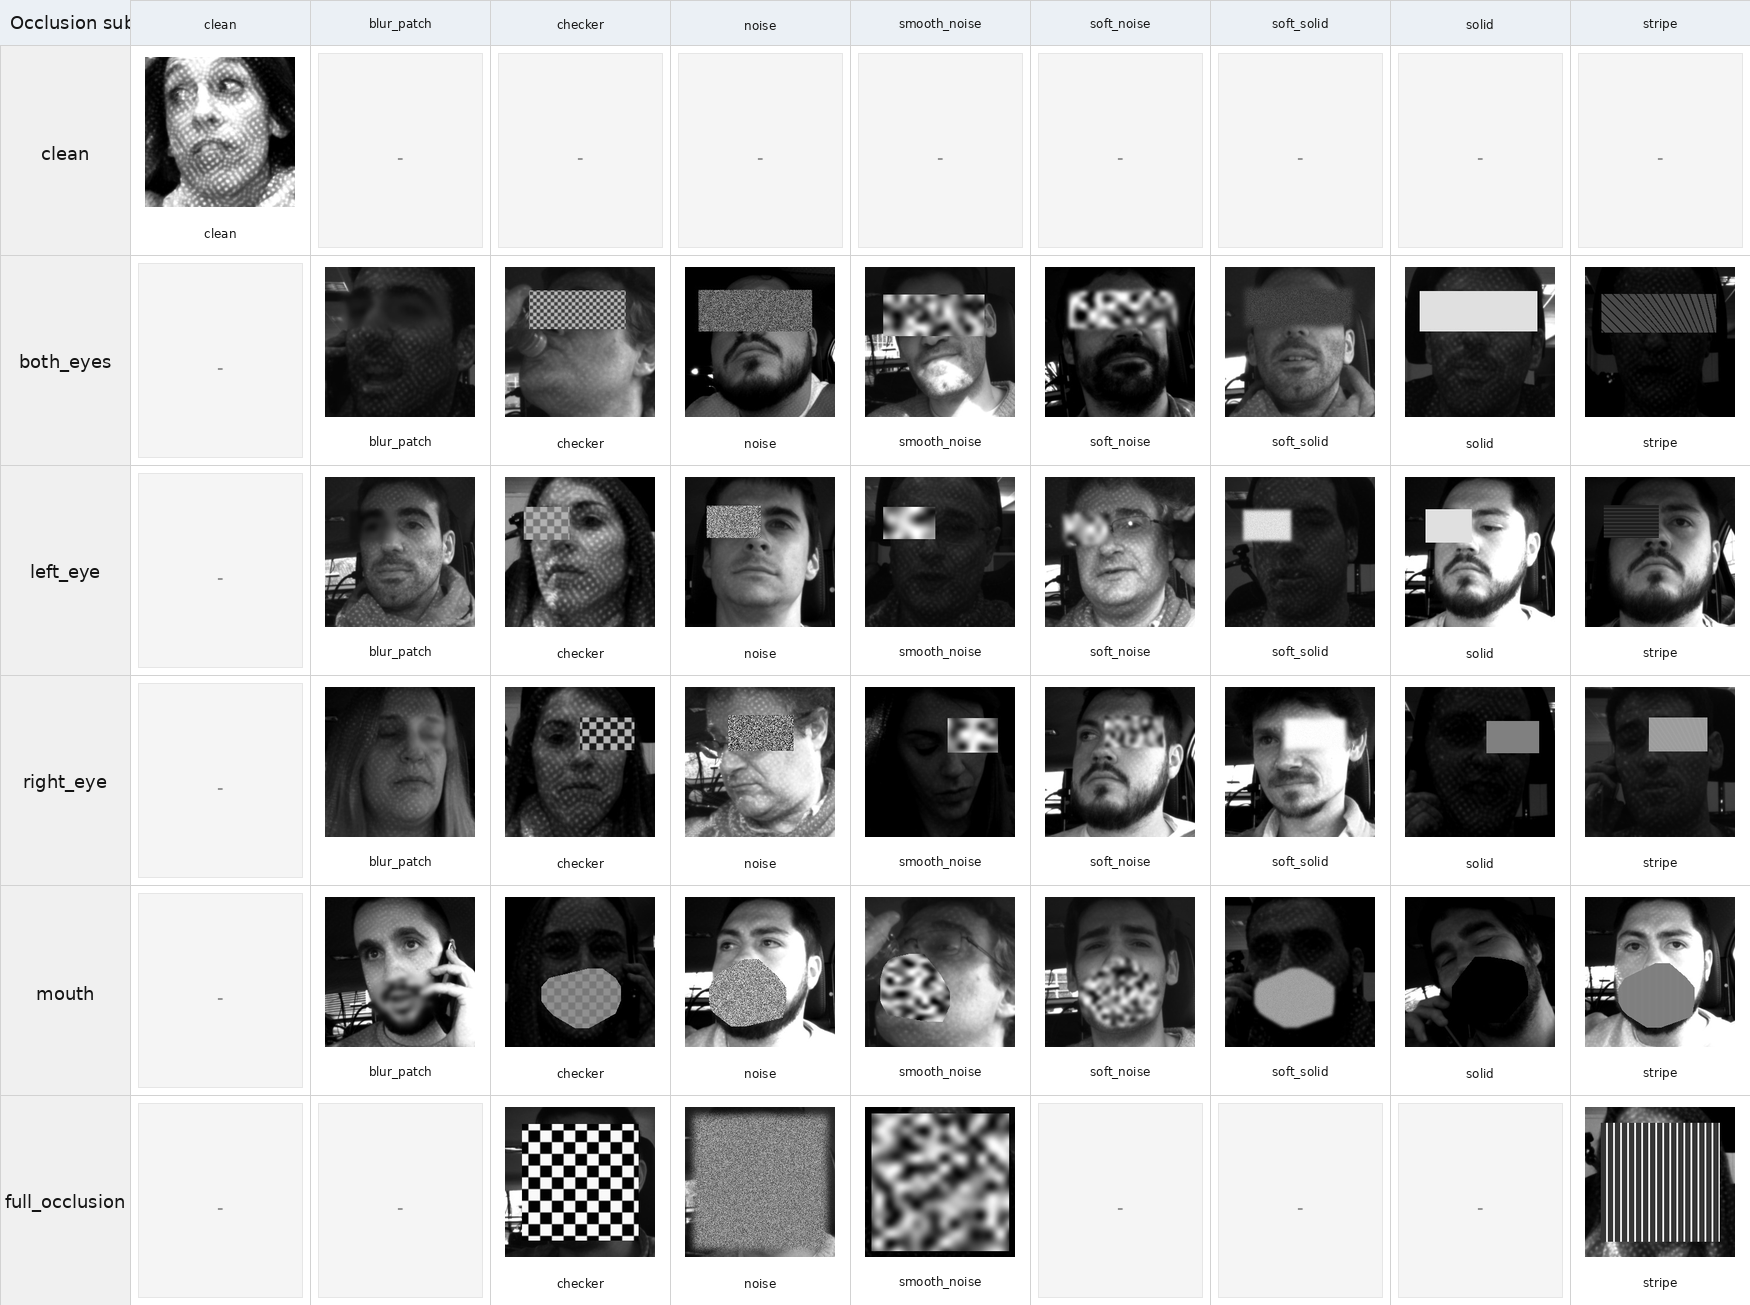
행은 clean·양쪽 눈·한쪽 눈·입·전체 가림 등의 영역이고, 열은 blur·checker·noise·stripe 등의 appearance다. 원본 샘플 그리드.
가리는 위치와 모양은 별개다
눈을 가린다는 조건이 같아도 검은 사각형, 체크무늬, 줄무늬, 노이즈 패치가 모델에 주는 입력은 다르다. 생성기는 얼굴 랜드마크로 부위를 잡고, 해당 영역에 여러 appearance를 렌더링한다.
복원 fine-tuning에서 재사용하는 패턴은 solid, soft_solid, blur_patch, smooth_noise, soft_noise, noise, checker, stripe의 8종이다. 저장된 crop을 읽기만 하는 방식이 아니라, 학습 중 생성기의 make_pattern을 호출해 입력을 바꾼다.
이렇게 하면 같은 얼굴, 같은 정답을 유지한 채 가림의 위치와 appearance를 바꾸는 실험을 만들 수 있다. 단, blur는 내부 정보가 일부 남을 수 있고, 패턴마다 가림의 강도도 다르다. 8종이라는 숫자만으로 모든 실제 가림을 대표한다고 볼 수는 없다.
정답까지 가려버리면 복원을 배울 수 없다
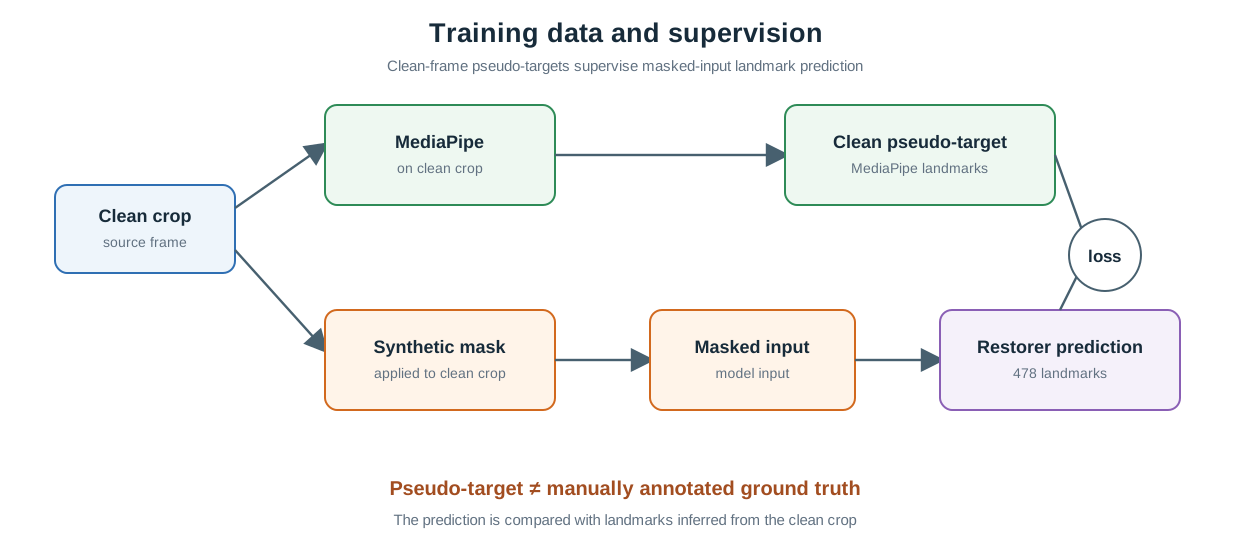
clean crop을 $x$, 가림 변환을 $M$, clean crop에서 얻은 랜드마크를 $p_{\mathrm{clean}}$이라고 두자. 복원 학습의 관계는 다음과 같다.
[코드 기반 재구성]
\[\hat p = f_\theta(M(x)), \qquad \mathcal L = d(\hat p, p_{\mathrm{clean}})\]$d$는 예측 좌표와 목표 좌표의 차이를 재는 함수다. 입력에는 $M(x)$를 주지만, 비교 대상은 마스킹 후 다시 검출한 좌표가 아니라 clean 좌표다. 그래야 가린 영역에서도 원래 구조를 추정하는 방향으로 학습 신호가 생긴다.
여기서 한 번 더 질문해야 한다. $p_{\mathrm{clean}}$이 정말 정답일까?
이 프로젝트에서는 대규모 얼굴 좌표를 모두 사람이 직접 표시하지 않았다. clean 영상의 MediaPipe FaceMesh 출력을 정답처럼 사용한다. 그래서 정확한 표현은 ground truth를 대신하는 pseudo-label이다. 이를 학습한 모델의 좌표 오차가 줄었다는 것은 우선 MediaPipe가 만든 목표에 가까워졌다는 뜻이다. 실제 가려진 눈의 움직임까지 정확히 복원했다는 보증은 아니다.
입력을 가리는 방식은 통제할 수 있다. 하지만 정답으로 삼은 검출기의 오차까지 사라지는 것은 아니다.
Part 4. 0과 1의 뜻부터 확인하기
가시성 데이터에서 특히 조심할 부분은 같은 1이 반대 뜻을 가질 수 있다는 것이다.
합성 crop의 labels.jsonl에서는 가려진 부위를 1로 표시한다. 예를 들어 [1, 0, 0]이면 왼쪽 눈만 가린 표기다. 반면 최종 분류기에 전달하는 벡터는 다음 순서의 visibility다.
[left_eye_visible, right_eye_visible, nose_visible,
 mouth_visible, crop_valid]
앞의 네 값은 클수록 잘 보인다는 방향이고, 마지막 값은 crop 유효성이다. 복원 모델 내부의 occlusion score인 alpha도 별도의 값이다. 이름에 occ가 붙었다는 이유로 전부 ‘1이면 가림’이라고 가정하면 gate를 반대로 연결할 수 있다.
| 값 | 큰 값의 의미 |
|---|---|
| 합성 crop의 occlusion label | 가린 부위 |
| ORFormer 내부 alpha | messenger 쪽 표현에 더 큰 혼합 가중치 |
| 최종 분류기의 visibility | 잘 보이는 부위 |
| 융합 scalar gate | 최종 구현에서는 pose 쪽 혼합 비율 |
마지막 줄은 5편에서 다시 만나게 된다. 데이터의 의미를 따라가면 모델의 수식에서 어느 항에 값을 곱해야 하는지도 명확해진다.
Part 5. clean/masked 짝을 나눌 때의 주의점
같은 원본 영상에서 만든 clean과 masked clip은 독립적인 영상 두 개가 아니다. 따라서 원본이 거의 같은 샘플을 한쪽은 train, 다른 쪽은 test에 넣으면 평가가 낙관적으로 나올 수 있다. 시간상 겹치는 window도 마찬가지다.
최종 실험은 고정 manifest split을 사용한다. 다만 fixed split이라는 이름만으로 운전자 단위 완전 분리까지 증명되는 것은 아니다. 이번 글에서는 해당 결과를 ‘동일한 고정 분할에서 비교한 결과’라고 표현한다. 새로운 운전자에 대한 일반화를 주장하려면 원본 영상·운전자 ID 단위로 분할을 추가 감사하고, 그 기준을 명시해야 한다.
합성 mask 역시 학습과 평가에서 같은 생성 규칙을 쓰면 그 규칙에 익숙해진 효과가 포함될 수 있다. 실제 선글라스의 반사나 손의 움직임까지 포함한 일반화는 별도 실험이 필요하다. 데이터가 무엇을 통제해주는지와 무엇을 아직 검증하지 못했는지를 함께 적어두는 편이 결과를 읽기 쉽다.
이제 입력과 정답을 준비했다. 다음 편에서는 ORFormer가 이 입력으로 얼굴 구조를 만드는 방법을 codebook부터 따라가 본다.