TabPFN 논문 리뷰 - 학습 없이 1초 만에 테이블 데이터를 분류하다
해설글
작성 · 23분 읽기 · 조회수 —수정
VI와 데이터 분할 수식의 표시 오류 수정
들어가며
이 블로그의 다른 논문 리뷰들은 학부 연구실 세미나에서 차근차근 발표한 글이지만, 이번 TabPFN은 결이 좀 다르다. 뉴로클이라는 머신비전 AI 회사의 리서치 인턴에 지원하면서, 면접 과제로 논문 4편 중 하나를 골라 리뷰 발표를 해야 했다. 그중 제일 만만해 보이는 걸 고를 법도 한데 하필 가장 어려워 보이는 논문을 골랐다. 그게 TabPFN이었다.
캡스톤 마감기간이랑 겹쳐서 1시간밖에 잠을 못 잤고 결국 대차게 망했다. (그래도 캡스톤 프로젝트는 우수상을 수상했다 ✌️) 다행히 면접관님들이 매우 친절하게 면접을 봐주셔서 마음이 편했고, 내가 생각하기 어려운 깊은 질문을 하셔서 대답을 잘 못했지만 논문을 보는 시각이 좀 깊어진 느낌을 받았다. 응원도 해주셔서 무슨 면접이 아니라 멘토링 시간인 줄 알았다. 면접관님들 감사합니다 ㅎㅎ
transformer 인코더를 사용해서 PPD 근사를 모델로 구현한다는 부분이 매우 놀라웠다. 테이블 데이터를 머신러닝으로만 다뤄본 나로서는 매우 신박한 논문이 아닐 수 없다.
TabPFN: A Transformer That Solves Small Tabular Classification Problems in a Second — Noah Hollmann, Samuel Müller, Katharina Eggensperger, Frank Hutter (2022, ICLR 2023)
발표를 준비하며 정리한 흐름을 그대로 옮겨놓았다.
한 줄 요약을 하자면 이렇다. TabPFN은 “베이지안 추론을 하는 방법” 자체를 합성 데이터로 미리 학습해둔 트랜스포머다. 그래서 새 데이터셋이 와도 학습·튜닝 없이, train set 전체를 프롬프트처럼 입력에 넣고 test의 답을 한 번에 출력한다. 이 한 문장을 제대로 이해하기 위해 베이지안 추론부터 PPD, PPD 근사법, 모델 구조, 추론과 학습방법까지 담기 위해 글이 길어졌다.
Part 1. Why TabPFN? — 테이블 데이터에서 딥러닝이 약했던 이유
테이블 데이터와 딥러닝의 차이
이미지·텍스트에서는 딥러닝이 사실상 표준이 됐지만, 유독 테이블 데이터(tabular data) 에서는 여전히 부스팅 트리가 가장 성능이 좋다. 데이터와 모델의 성질이 근본적으로 어긋나기 때문이다.
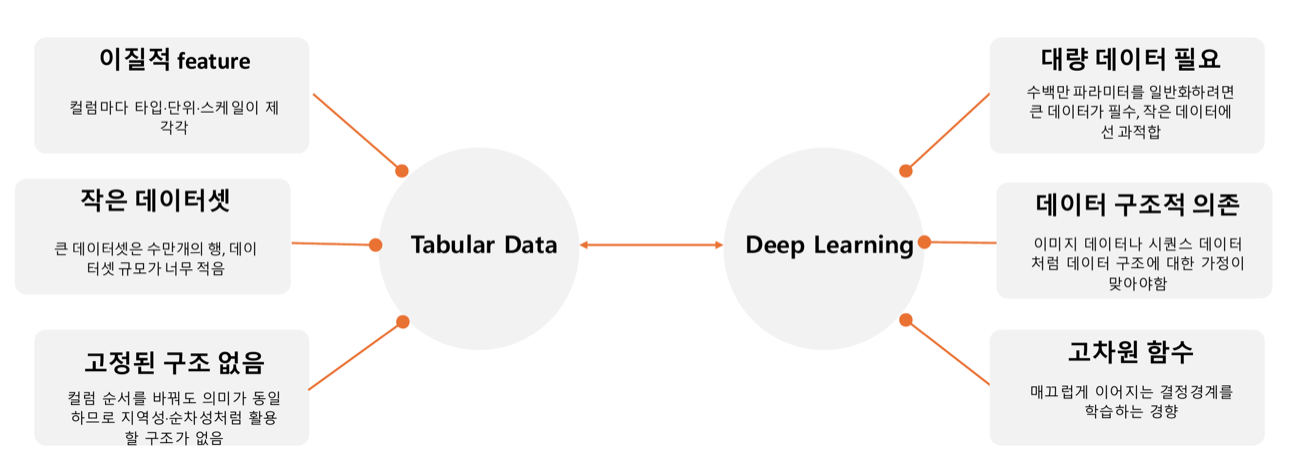
| 테이블 데이터의 특성 | 딥러닝이 잘하려면 |
|---|---|
| 이질적 feature — 컬럼마다 타입·단위·스케일이 제각각 | 대량 데이터 필요 — 수백만 파라미터를 일반화하려면 큰 데이터가 필수 |
| 작은 데이터셋 — 행이 수십~수천 개로 너무 적음 | 구조적 inductive bias 의존 — 이미지·시퀀스처럼 데이터 구조에 대한 가정이 맞아야 함 |
| 고정된 구조 없음 — 컬럼 순서를 바꿔도 의미가 같아, 지역성·순차성처럼 활용할 구조가 없음 | 매끄러운 함수 선호 — 부드럽게 이어지는 결정 경계를 학습하는 경향 |
정리하면, 테이블 데이터는 작고, 구조가 없고, 컬럼마다 이질적인데, 딥러닝은 크고 구조 있는 데이터를 좋아한다. 반면 부스팅 트리의 축에 정렬된(axis-aligned) 결정 경계는 테이블 데이터의 불규칙한 경계와 오히려 잘 맞는다.
모델 계보
테이블 데이터 모델의 흐름은 크게 세 갈래다.
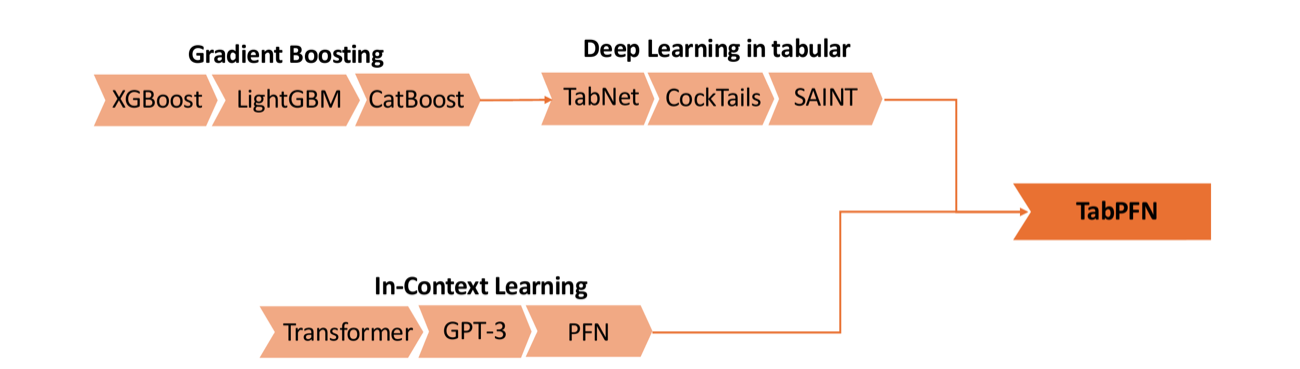
- Gradient Boosting: XGBoost → LightGBM → CatBoost. 작은 데이터에서 빠르고 강력한 현재까지도 널리 쓰이는 모델.
- Deep Learning on Tabular: TabNet → Reg. Cocktails → SAINT. 딥러닝으로 tabular data를 학습한 모델을 만들었지만 큰 의미를 갖지 않음.
- In-Context Learning: Transformer → GPT-3 → PFN. TabPFN으로 직접 이어지는 흐름이다.
① Boosting Tree — tabular 통용 모델
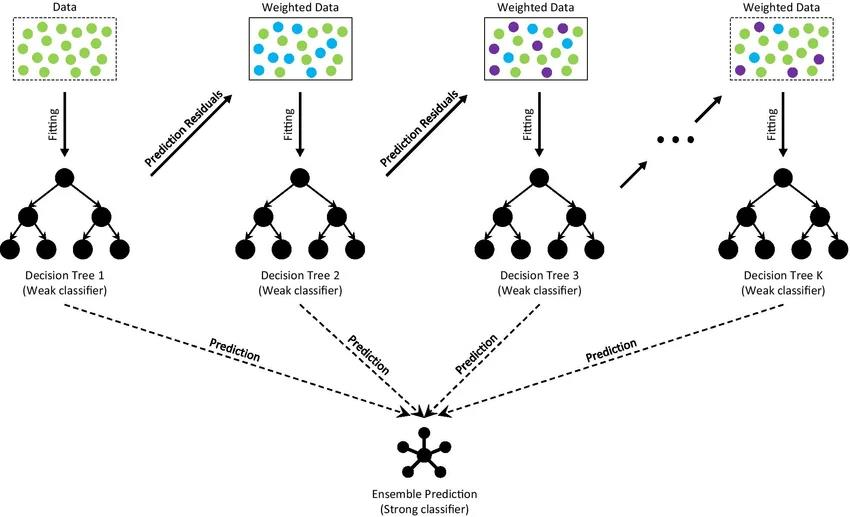
약한 학습기(얕은 트리)를 순차적으로 더해 가는 앙상블이다. 매 단계 $m$에서 현재 모델 $F_{m-1}$이 틀린 부분(잔차)을 타깃으로 새 트리 $h_m$을 학습하고, 학습률 $\gamma_m$을 곱해 더한다. XGBoost·LightGBM·CatBoost는 여기에 정규화·히스토그램 분할·범주형 처리를 더한 구현체들이다.
단점이 하나 있다. 데이터셋마다 처음부터 학습 + 하이퍼파라미터 튜닝이 필요하다는 것. 나중에 TabPFN의 “1초”와 대비되는 지점이다.
② Deep Learning on Tabular — tabular 전용 딥러닝 모델
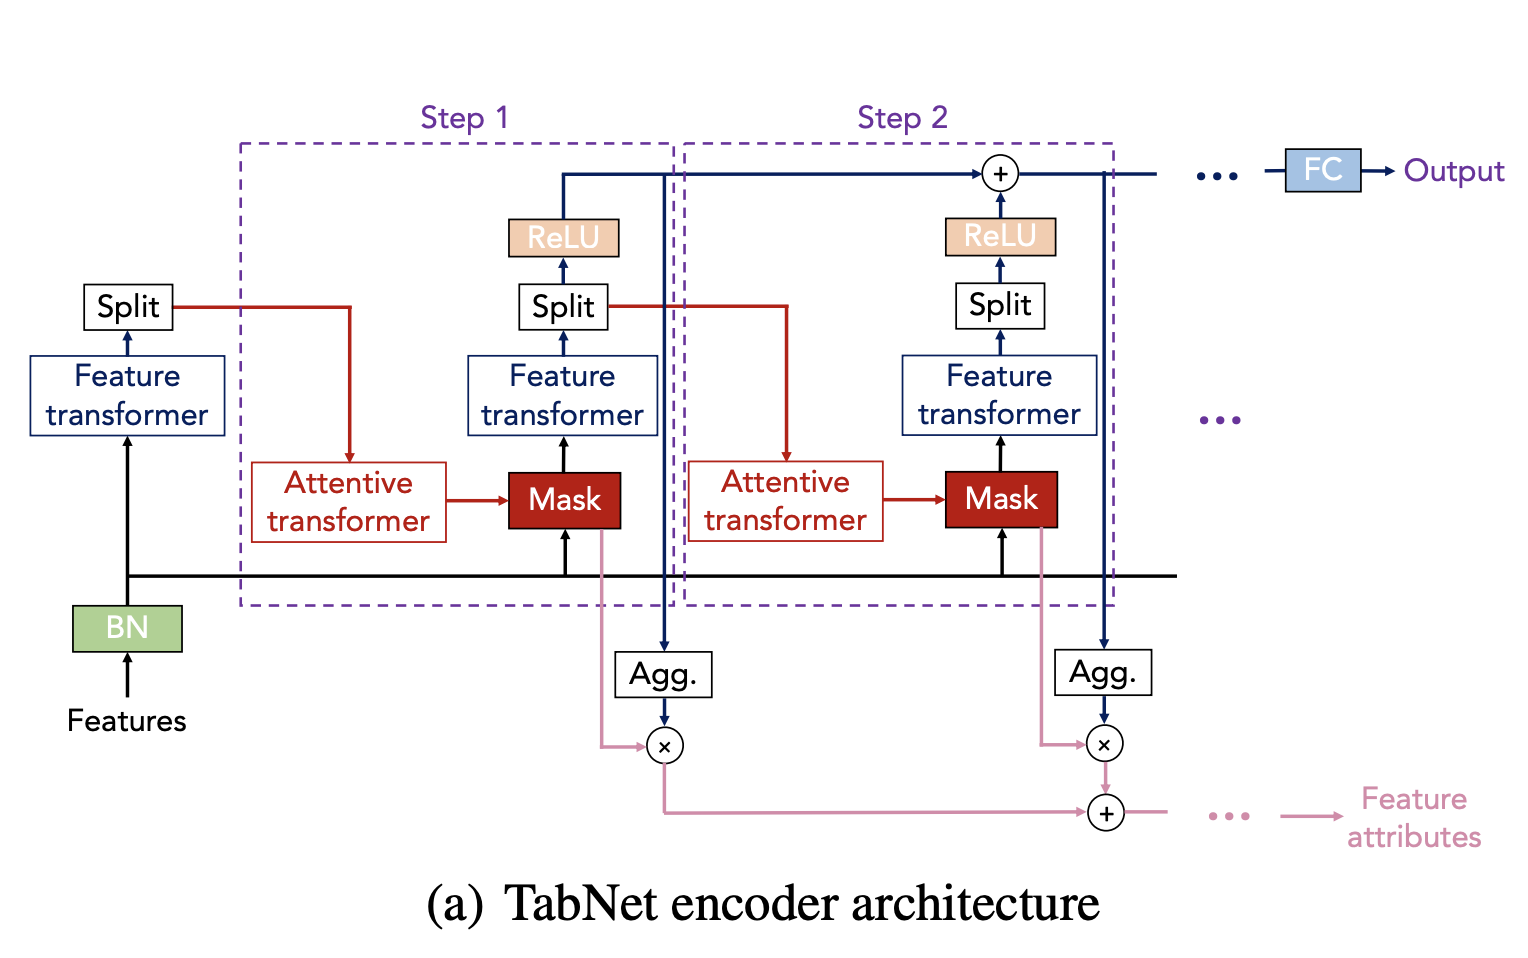
- Regularization Cocktails: 단순 MLP에 드롭아웃·weight decay·데이터 증강 등 10여 가지 규제를 데이터셋마다 최적화 — 구조가 아니라 규제로 XGBoost를 넘어섰다.
- TabNet: 매 의사결정 단계에서 sparse attention으로 중요한 feature 일부만 골라 쓴다. feature 선택이 학습에 내장돼 해석 가능성도 확보.
- SAINT: 행(샘플) 간 어텐션 + 열(feature) 간 어텐션을 모두 걸고 contrastive 사전학습 추가 — BERT 스타일을 테이블에 이식.
셋의 공통 한계는 같다. “새 데이터셋 → 새로 학습 + 튜닝”이라는 패러다임 안에 있다는 것.
③ In-Context Learning — 가중치 업데이트 없는 예측
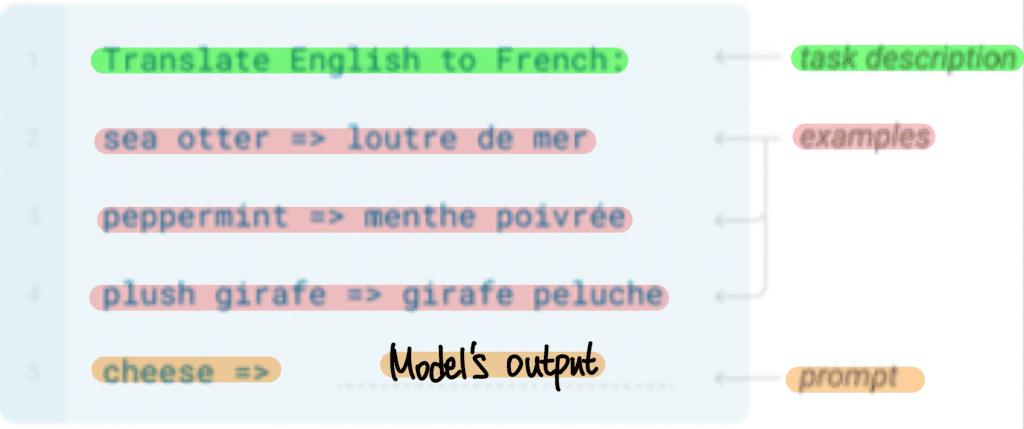
GPT-3에서 발견된 현상이다. 가중치는 고정한 채, 프롬프트에 (입력→출력) 예시 몇 개를 넣으면 새 입력의 답을 출력한다. zero-shot, one-shot, few-shot을 통칭해 In-Context Learning(ICL) 이라 부르고, 핵심은 가중치 업데이트가 전혀 없다는 점이다. “학습”이 gradient descent가 아니라 forward pass 안의 attention 연산으로 일어난다.
TabPFN은 이걸 테이블에 그대로 옮긴다. train set 전체가 프롬프트, test의 $x$가 질문, 출력이 답이다.
\[q_\theta(y_{test} \mid x_{test}, \; D_{train})\]그러면 이런 질문이 남는다. “학습 없이 예측이 어떻게 가능한가? 이 forward pass는 수학적으로 뭘 하고 있는 건가?” 답은 베이지안 추론이고, Part 2에서 다룬다.
Part 2. 베이지안 추론 기초 — 동전 던지기로 Likelihood부터 PPD까지
뒤에서 TabPFN이 근사하는 대상이 PPD(Posterior Predictive Distribution) 다. 이 파트에서는 동전 던지기 예시로 Likelihood → Prior → Posterior → PPD 순서로 개념을 정리하였다.
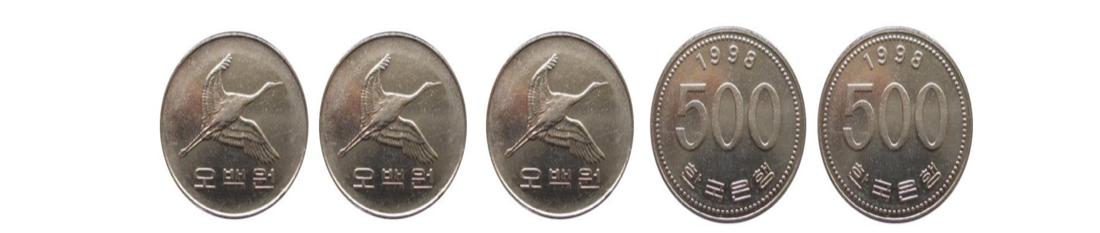
셋업: 동전을 5번 던졌더니 앞면 3번, 뒷면 2번이 나왔다. 이 동전이 앞면이 나올 확률 $\theta$를 추론하고 싶다.
1. Likelihood (우도)
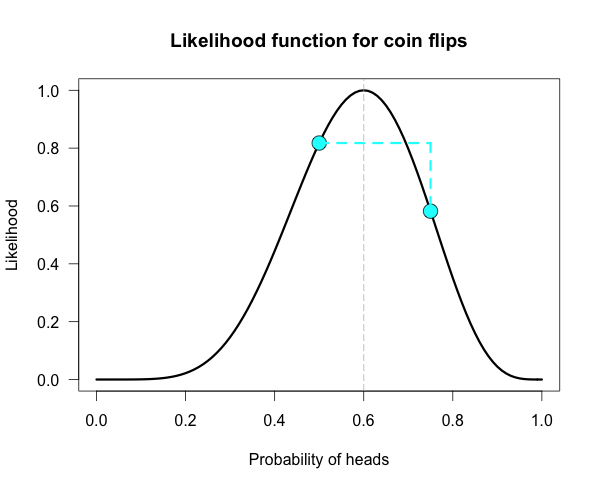
앞면 확률을 $\theta$로 두면, 각 던지기가 독립이므로 우도는 이렇게 쓰인다.
\[L(\theta) = P(D \mid \theta) = \theta^{3}(1-\theta)^{2}\]여기서 확률과 우도의 차이가 헷갈리기 쉽다.
- 확률: $\theta$를 고정하고 데이터가 변수 — “$\theta=0.5$일 때 앞 3번 나올 확률은?”
- 우도: 데이터를 고정하고 $\theta$가 변수 — “앞 3·뒤 2가 나왔는데, $\theta=0.5$와 $\theta=0.6$ 중 누가 더 그럴듯한가?”
$L(0.5) = 0.03125$, $L(0.6) = 0.6^3 \times 0.4^2 = 0.03456$ → 0.6이 더 그럴듯하다. 주의할 점은 $L(\theta)$가 확률분포가 아니라는 것이다($\theta$에 대해 적분해도 1이 안 됨). $\theta$가 데이터를 얼마나 잘 설명하는지를 나타내는 함수일 뿐이다.
2. Prior (사전분포)
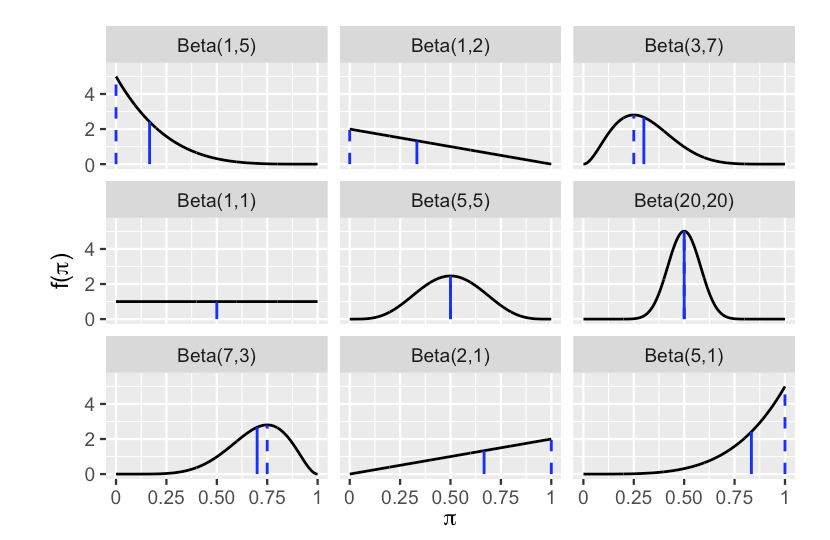
데이터를 보기 전에 가정하는 믿음의 분포가 prior다. 확률 $\theta$는 $[0,1]$ 구간 값이므로, 같은 구간에 정의된 Beta 분포가 자연스러운 선택이다.
\[P(\theta) = \mathrm{Beta}(2, 2) \;\propto\; \theta(1-\theta)\]$\mathrm{Beta}(2,2)$는 0.5에서 최대인 종 모양 = “동전이니까 아마 공정하겠지”라는 약한 믿음이다. 비교하자면 $\mathrm{Beta}(1,1)$은 균등분포(아무 믿음 없음), $\mathrm{Beta}(20,20)$은 0.5에 뾰족한 강한 믿음이다.
prior의 뾰족함(강도)이 “데이터와 사전 믿음을 어느 비율로 절충할지”를 결정한다. 데이터가 적을수록 prior가 결과를 많이 끌고 간다. 테이블 데이터가 작다는 사실(Part 1)과 연결되는 지점이다.
3. Posterior (사후분포)
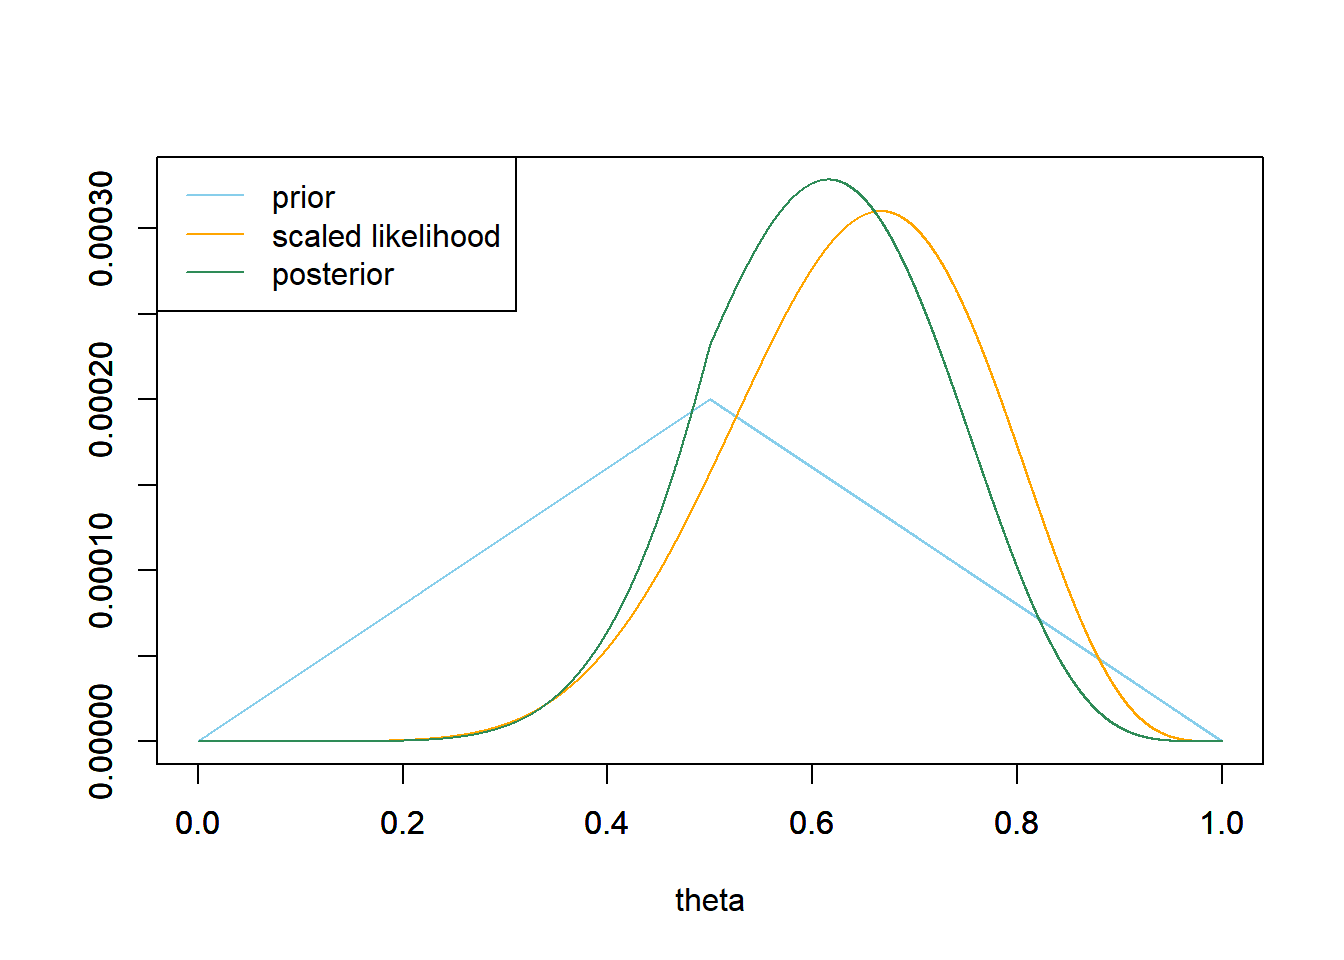
데이터를 본 후 갱신된 믿음이 posterior다. 베이즈 정리로 쓰면:
\[P(\theta \mid D) = \frac{P(D \mid \theta)\, P(\theta)}{P(D)} \;\propto\; \underbrace{\theta^{3}(1-\theta)^{2}}_{likelihood} \times \underbrace{\theta(1-\theta)}_{prior} = \theta^{4}(1-\theta)^{3}\]분모 $P(D)$는 $\theta$와 무관한 정규화 상수라 모양만 볼 땐 $\propto$로 생략된다. 그래서 실전 형태는 “posterior ∝ likelihood × prior” 다. 곱하면 지수가 그냥 더해진다: $\theta^{3+1}(1-\theta)^{2+1}$. 이건 $\mathrm{Beta}(5,4)$ 모양인데, Beta prior × 이항 likelihood = Beta posterior인 켤레(conjugate) 관계라 계산이 닫힌 형태로 떨어진다.
직관적으로 prior의 $(2,2)$는 “가상의 동전 앞 1번·뒤 1번을 미리 본 것”과 같다. 실제 관측(앞3·뒤2)과 합쳐 앞4·뒤3이 된 셈이다. 데이터가 쌓일수록 posterior는 점점 뾰족해지고 likelihood 쪽으로 이동하며, prior의 영향은 소멸한다.
4. MLE vs Posterior — 점 추정과 분포 추정
\[\hat{\theta}_{MLE} = \underset{\theta}{\arg\max}\; L(\theta) = 0.6 \qquad vs \qquad \hat{\theta}_{posterior\ mode} = \frac{4}{7} \approx 0.571\]- MLE($\frac{dL}{d\theta}=0$ 풀면 $\frac{3}{5}=0.6$): 데이터만 보고 $\theta$를 한 점으로 확정한다. 5번 관측의 불확실성이 버려진다.
- Posterior mode($\theta^4(1-\theta)^3$ 미분하면 $\frac{4}{7}\approx0.571$): prior(0.5)가 데이터(0.6)를 0.571로 살짝 당긴다. “관측이 5번뿐이라 아직 0.6이라 확신하긴 이르다”는 보수적 추정이다.
더 중요한 차이는 이것이다. MLE의 결과물은 값 하나, 베이지안의 결과물은 분포 전체다. 분포가 있어야 다음의 “모든 가설을 가중평균한 예측”이 가능해진다.
5. PPD — 모든 가설을 가중평균한 이상적 예측
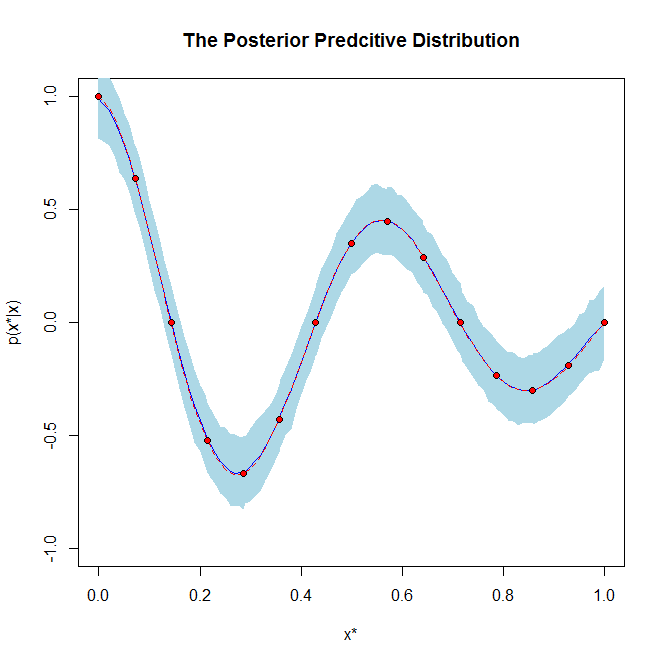
앞의 posterior를 예측에 쓰는 단계다. $\theta$ 하나를 골라 쓰지 않고(≠MLE), 모든 $\theta$의 예측을 posterior 무게로 가중평균한다.
\[p(y \mid x, D) = \int_{\Theta} p(y \mid x, \theta) \; p(\theta \mid D) \; d\theta\]적분 안의 두 항을 읽으면:
- $p(y \mid x, \theta)$ = “$\theta$라는 가설이 맞다면 $y$는 이럴 것”
- $p(\theta \mid D)$ = “그 가설이 맞을 확률”
둘을 곱해 모든 $\theta$에 대해 적분 = 모든 가설의 예측을, 그 가설이 맞을 확률로 가중평균한 것이다. 동전 예시에서 다음 던지기가 앞면일 확률을 계산하면:
\[\int \theta \cdot p(\theta \mid D)\, d\theta = \mathbb{E}[\theta \mid D] = \frac{5}{9} \approx 0.556 \quad (\mathrm{Beta}(5,4)\text{의 평균})\]MLE라면 그냥 0.6이라고 답했을 것이다. PPD는 “모델 선택”이라는 행위 자체를 우회한다 — 어떤 $\theta$도 버리지 않고 전부 쓴다. 그래서 데이터가 적을 때 과신하지 않고, 분류 문제라면 클래스별 확률(불확실성)이 자연스럽게 나온다.
6. PPD는 왜 직접 계산할 수 없는가
동전은 $\theta$가 스칼라 1개인 데다 Beta 켤레성이 성립해 적분이 손으로 풀리는 특수한 경우였다. 일반적인 머신러닝에서는 가설 $\phi$가 동전의 $\theta$보다 훨씬 거대하다. TabPFN 논문은 PPD를 likelihood × prior로 분해된 형태로 쓴다(논문 식 1).
\[p(y \mid x, D) \;\propto\; \int_{\Phi} p(y \mid x, \phi) \; p(D \mid \phi) \; p(\phi) \; d\phi\]- 가설 $\phi$가 신경망이면: 가중치 수백만 개 → 수백만 차원 적분. 닫힌 해 없음, 수치적분은 차원의 저주로 불가능.
- 가설 $\phi$가 SCM이면: 그래프 구조(이산적 조합 폭발) × 각 함수의 모양(연속) — 만들 수 있는 SCM의 경우의 수가 거의 무한하다. SCM마다 PPD를 계산해야 하는데, 그 SCM이 사실상 무한 종류다.
그래서 통계학·ML은 PPD를 직접 계산하는 대신 근사하는 방법들을 발전시켜 왔다. 다음 파트의 MCMC / VI / GP다.
Part 3. 기존 PPD 근사법 — MCMC · VI · GP
① MCMC — 샘플링 기반 근사
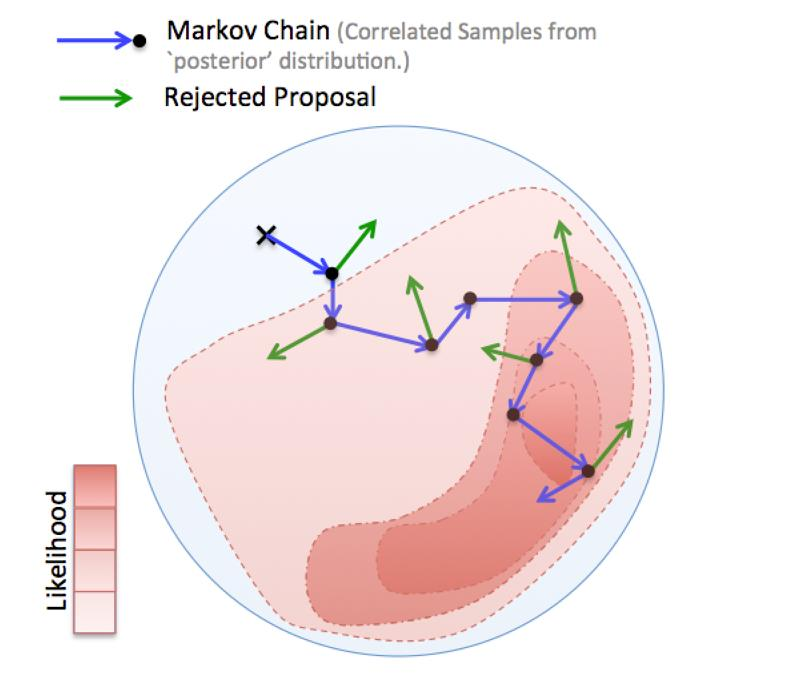
핵심 아이디어는 “적분을 못 풀면 샘플을 뽑아 평균내자”(몬테카를로)다. 그런데 posterior에서 직접 샘플을 뽑을 수도 없어서, 마르코프 체인을 설계해 체인이 오래 돌아다닌 후의 방문 분포(정상분포)가 posterior와 같아지게 만든다.
- 장점: 비정규화 posterior(분자 = likelihood × prior)만 있으면 작동. 분모 $P(D)$를 몰라도 됨. $M \to \infty$면 이론적으로 정확.
- 단점: ① 수렴(burn-in)까지 오래 걸리고 수렴 판정도 어려움 ② 샘플끼리 상관이 있어 유효 샘플 수가 적음 ③ 데이터셋 $D$가 바뀌면 체인을 처음부터 다시 — 데이터셋마다 비용 반복.
② Variational Inference — 최적화 기반 근사
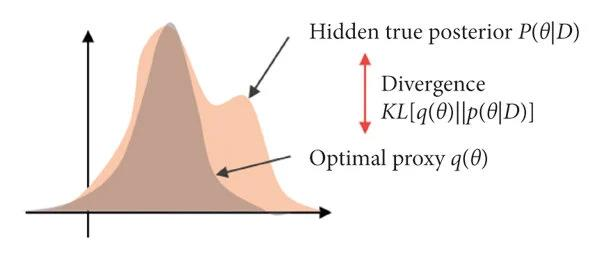
핵심 아이디어는 “샘플링은 느리니, posterior를 다루기 쉬운 분포로 흉내내자”다. 분포족 $\mathcal{Q}$(예: 가중치마다 독립인 가우시안)를 정해두고, 그 안에서 진짜 posterior와 KL divergence가 최소인 $q^{\ast}$를 찾는다. KL을 직접 계산할 순 없지만, KL 최소화 = ELBO 최대화와 동치라 gradient descent로 풀린다. 즉 “적분 문제”가 “최적화 문제”로 바뀐다.
- 단점: $\mathcal{Q}$가 단순하면(독립 가우시안 등) 진짜 posterior의 다봉성이나 가중치 간 상관을 원리적으로 못 잡는다 → 아무리 오래 학습해도 남는 체계적 오차.
정리하면 MCMC는 정확하지만 느리고, VI는 빠르지만 부정확하다. 그리고 둘 다 데이터셋이 바뀌면 처음부터 다시 계산해야 한다.
③ (특수 케이스) Gaussian Process
prior가 GP인 특수한 경우엔 PPD가 닫힌 형태로 정확히 풀린다. GP는 함수 자체에 가우시안 prior를 두는 방법인데, “정규분포의 조건부 분포는 또 정규분포”라는 성질 덕분에 적분을 우회하지 않고도 정확히 계산된다. 단 이건 prior가 GP일 때만 가능하고, 신경망·SCM prior에서는 불가능하다.
PFN 원논문(Müller et al., 2022)의 검증 논리가 여기서 나온다. 정답(정확한 PPD)이 존재하는 GP에서 PFN을 학습시켜 보니 정답을 거의 완벽히 재현했다 → “트랜스포머는 베이지안 추론을 학습할 수 있다” 는 증거를 확보 → 그렇다면 정답을 못 구하는 prior(SCM·BNN)에서도 믿고 쓸 수 있다는 논리다.
Part 4. TabPFN — 베이지안 추론의 사전학습
이 글에서 가장 중요한 파트다. 발표 슬라이드에선 아키텍처를 한 장으로 욱여넣었지만, 사실 손실함수·학습 과정·추론 과정·그 안에 함의된 PPD 근사까지 풀면 분량이 훌쩍 늘어난다.
적분을 푸는 대신, 푸는 법을 학습한다
MCMC와 VI의 공통 약점은 “데이터셋마다 비싼 계산을 반복”하는 것이었다. PFN(Prior-Data Fitted Networks)은 이 비용 구조를 뒤집는다.
매번 적분을 다시 푸는 대신, “적분 푸는 법” 자체를 미리 한 번 학습해 둔다.
- 기존(MCMC/VI): 데이터셋마다 중간 비용 반복
- PFN: 비싼 사전학습 1번(offline) + 거의 공짜인 추론 무한 번(online)
전체 파이프라인
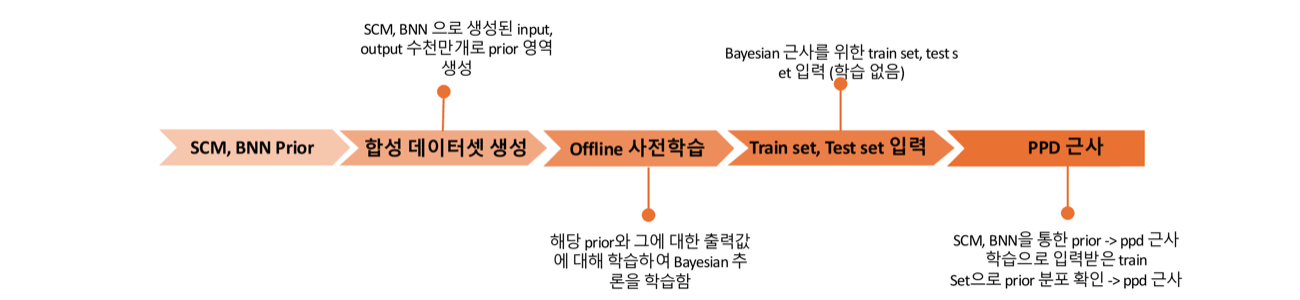
흐름은 다음과 같다.
- SCM·BNN Prior: 데이터를 만들어내는 “생성 규칙”의 분포.
- 합성 데이터셋 생성: prior에서 가설을 뽑아 input/output 쌍을 수천만 개 만든다.
- Offline 사전학습: 이 합성 데이터로 Bayesian 추론하는 법을 학습. (실데이터는 한 번도 안 봄)
- Train/Test 입력: 추론 시점에 실제 train set과 test set을 입력으로 넣음 (학습 없음).
- PPD 근사: train으로 prior 분포를 확인하고, test의 답을 PPD 근사값으로 출력.
핵심은 실제 데이터를 한 번도 학습하지 않는다는 것. 실데이터는 추론 시 입력으로만 들어간다. 학습에는 prior에서 뽑은 합성 데이터만 쓴다.
Prior ① SCM — 인과 구조 기반 데이터 생성
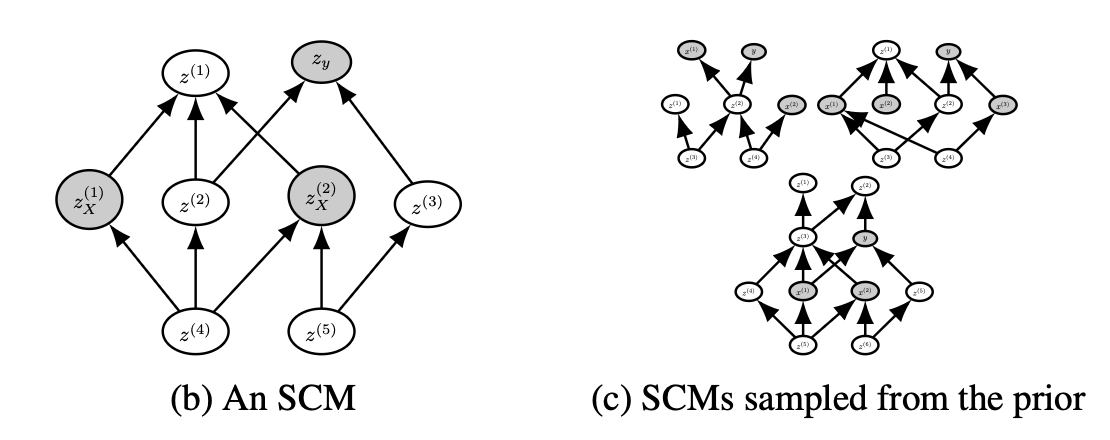
SCM(Structural Causal Model) 은 변수들이 원인→결과로 연결되고, 각 결과가 원인으로부터 어떻게 계산되는지 적어둔 설계도다.
\[z_i = f_i\big( z_{\mathrm{PA}_{\mathcal{G}}(i)}, \; \epsilon_i \big)\]노드 $z_i$의 값 = 부모 노드들($\mathrm{PA}_{\mathcal{G}}(i)$, 직접 원인들)을 함수 $f_i$에 넣고 노이즈 $\epsilon_i$를 더한 것. DAG + 이 구조방정식들의 묶음이 SCM이다. 예를 들어 비(R) → 잔디 젖음(W) → 미끄러움(S) 그래프라면:
\(R = (\text{그냥 랜덤하게 비가 옴})\) \(W = f(R) + noise \quad (\text{비의 양으로 젖음 정도 계산})\) \(S = g(W) + noise \quad (\text{젖음 정도로 미끄러움 계산})\)
$f, g$가 선형이면 단순한 SCM, 비선형·고차원이면 복잡한 SCM이다. 관찰 데이터의 상관관계 뒤에 있는 생성 메커니즘을 명시한다는 점이 단순 확률분포와의 차이고, 테이블 컬럼들(나이→소득→지출)이 전형적으로 이런 구조다.
실제 데이터 생성 절차는 다음과 같다.
- 그래프 크기·층수·활성화함수·노이즈 종류를 전부 분포에서 샘플해 SCM 하나 생성. 구현상으로는 랜덤한 MLP(선형결합 + 활성화함수 + noise)를 하나 만드는 것과 같다.
- 그 MLP의 노드 중 일부를 feature($z_X$), 하나를 label($z_y$)로 균등하게 지정. 위 그림에서 회색 노드들이 그렇게 지정된 것이다.
- 노이즈를 $n$번 흘려보내 $n$행짜리 데이터셋 완성.
feature 노드와 label 노드는 그 사이에 낀 hidden layer를 통해 자연스럽게 현실적인 인과 구조로 엮인다. SCM 하나 = 가설 하나 = 데이터셋 하나다.
Occam bias: 노드·파라미터 수가 적은 단순한 그래프에 높은 확률을 부여한다. “경쟁하는 가설 중 단순한 쪽을 선호”(오컴의 면도날)를 prior에 주입한 것 — 작은 데이터에서의 과적합을 막는 장치다. 또 label 노드가 feature보다 그래프 상류일 수도(label이 원인), 하류일 수도(label이 결과) 있어 양방향 인과를 모두 포괄한다.
한 가지 디테일. TabPFN의 손실함수는 cross-entropy(분류)인데, SCM이 만든 출력 $z_y$는 연속값이다. 그래서 클래스 개수를 랜덤하게 정하고, 클래스 경계도 랜덤하게 정한 뒤, 연속 $y$값들을 그 구간에 맞춰 라벨링해 분류 문제로 바꾼다.
Prior ② BNN — 가중치가 분포인 신경망
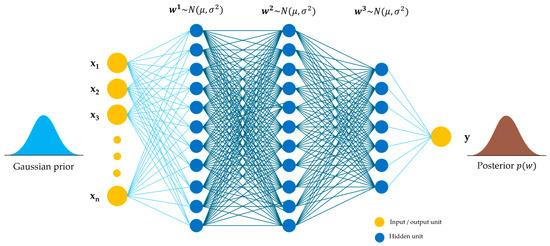
또 다른 prior는 BNN(Bayesian Neural Network) 이다. 가중치 $\xi$를 정규분포 $\mathcal{N}(0,\sigma^2)$에서 뽑은 MLP에, 단순 분포에서 뽑은 입력 $X$를 넣어 출력을 만든다. 가중치가 점이 아니라 분포라서 MLP 함수 자체가 랜덤 → 결국 함수 공간에 대한 prior가 된다.
TabPFN은 SCM prior와 BNN prior를 혼합해 쓴다(데이터셋 생성 시 둘 중 하나를 선택). 실험 결과 SCM prior가 더 강력하고, 혼합이 가장 안정적이었다. 한 단계 더 나아가, 층수·너비·$\sigma$ 같은 하이퍼파라미터도 고정하지 않고 분포에서 샘플한다 → 모델 구조까지 적분에 포함하는 “fully Bayesian”이고, 사람이 하던 하이퍼파라미터 튜닝이 prior 안으로 흡수된다.
손실함수 — 왜 이 손실이 PPD 근사가 되는가
가장 중요한 식이다(논문 식 2). 한 항씩 나누어 설명한다.
\[\mathcal{L}_{PFN} = \underset{(\{(x_{test},\, y_{test})\} \cup D_{train}) \sim p(D)}{\mathbb{E}} \Big[ -\log q_\theta(y_{test} \mid x_{test}, D_{train}) \Big]\]말로 풀면: 입력으로 $x_{test}$와 $D_{train}$이 주어졌을 때 정답 $y_{test}$에 대한 손실을, 모든 test 쌍에 대해 평균내고, 다시 모든 가설(데이터셋)에 대해 평균낸 값이다. 기호부터 정리하면,
- $D_{train}$ = 라벨 있는 train set ${(x_1,y_1),\dots,(x_n,y_n)}$ — SCM·BNN이 만든 합성 train set
- $x_{test}$ = test의 feature, 즉 “문제”
- $y_{test}$ = test의 정답
$q$ 항 — 모델이 출력하는 확률
$q_\theta(y_{test} \mid x_{test}, D_{train})$는 train 데이터셋 전체와 test의 $x$ 하나를 줬을 때, 정답 $y_{test}$에 대해 모델이 추론한 확률값이다. 모델 출력이 클래스별 softmax라면(클래스 $c=1,\dots,C$):
\[q_\theta(y=c \mid x_{test}, D_{train}) = \mathrm{softmax}(logit_c) = \frac{e^{logit_c}}{\sum_{c'=1}^{C} e^{logit_{c'}}}\]이 중 우리가 쓰는 것은 정답 클래스 $y_{test}$ 자리의 값 하나 $\rightarrow p_{정답} := q_\theta(y_{test}\mid x_{test},D_{train}) \in (0,1)$.
$\log$ 항 — cross-entropy
샘플 하나의 손실값은 $-\log q_\theta(y_{test}\mid x_{test}, D_{train})$이다. 정답 확률이 1에 가까우면 손실 0, 0에 가까우면 손실 $\infty$. 이진 분류라면 익숙한 형태가 된다:
\[\ell = -\big[\, y_{test}\ln f + (1-y_{test})\ln(1-f)\,\big]\]$\mathbb{E}$ 항 — 가설·데이터셋에 대한 평균
기댓값 $\mathbb{E}_{(\cdots)\sim p(D)}$는 다음 절차를 무한 반복한다는 뜻이다.
- prior에서 가설 하나 추출: $\phi^{(k)} \sim p(\phi)$ — SCM이면 MLP 안의 인과 노드 관계 하나, BNN이면 MLP 하나.
- 그 가설로 데이터셋 생성: $D^{(k)} \sim p(D \mid \phi^{(k)})$ — 입력값은 표준정규분포에서 뽑아 가설 MLP에 통과시킨 입출력 쌍.
-
데이터셋을 train/test로 분할한다. [설명용 유도]
\[D^{(k)} = D^{(k)}_{train} \cup \{(x^{(k)}_{test}, y^{(k)}_{test})\}\] - 모든 test 입출력 쌍에 대해 손실 계산 후 평균.
이를 식으로 모으면, 실제 학습에서 최소화하는 것은 다음의 유한 근사다.
\[\mathcal{L}_{PFN} \approx \frac{1}{K}\sum_{k=1}^{K} \frac{1}{m}\sum_{j=1}^{m} \Big[ -\log q_\theta\big(y^{(k)}_{test,j} \mid x^{(k)}_{test,j}, D^{(k)}_{train}\big) \Big]\]왜 “근사(approx)”인가? 이상적으로는 무한개의 가설에 대해 학습해야 모델이 모든 가설을 본 것이 된다. 하지만 무한은 불가능하므로, 현실에서는 한 step마다 512개의 가설(데이터셋)을 하나의 batch로 묶어 이상적 학습에 근사한다. 이 손실을 최소화한 결과가 곧 PPD의 근사값이다.
왜 이 손실이 PPD에 수렴하는가
여기가 이 논문에서 내가 가장 오래 붙잡았던 부분이다. PPD를 다시 적으면:
\[PPD = \int p(y \mid x, \phi)\, p(\phi \mid D_{train})\, d\phi\]즉 모든 가설 $\phi$를 posterior로 가중평균한 값이다. 그런데 위 손실로 학습한 모델이 왜 이것과 같아질까?
하나의 prior에서 가설을 하나씩 뽑아 데이터셋을 만들고 train/test로 나눈다. 모델은 train만 보고 test를 맞춘다. 그런데 하나의 train set은 여러 가설에서 나올 수 있다. 따라서 손실을 줄이려는 모델 입장에서, 이 데이터셋을 “어떤 특정한 하나의 가설에서 나온 것” 이라고 단정하면 (그 단정이 틀린 경우 test 손실이 폭발한다) 손해다. 그래서 모델은 자연스럽게 이 데이터셋을 “여러 가설로 이뤄진 분포에서 나온 것” 으로 취급하게 된다. 바로 이것이 prior × likelihood, 즉 posterior로 가중평균한 답 — PPD와 일치한다.
Müller et al.(2022)은 이 직관을 엄밀히 증명했다. cross-entropy 손실의 기대값을 최소화하는 $q_\theta$는 진짜 PPD와의 KL divergence를 최소화한다. 즉 “라벨 맞추기 게임”을 무한히 시키면 모델이 베이지안 추론기로 수렴한다.
Transformer 아키텍처 — train은 프롬프트, test는 질문
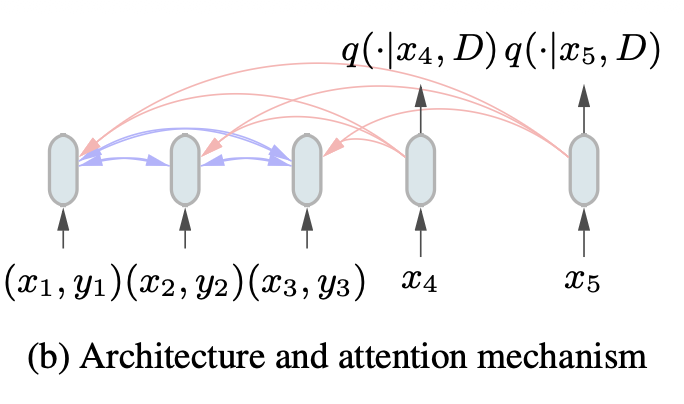
이 $q_\theta$는 트랜스포머로 구현된다. 표준 트랜스포머에서 positional encoding을 제거한 것이 가장 큰 변경점이다.
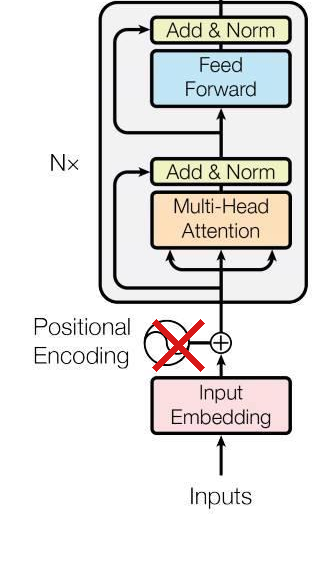
- 토큰화: train 샘플 $(x_i, y_i)$는 x 인코딩 + y 인코딩을 합쳐 토큰 1개. test 샘플은 x만으로 토큰. feature 수가 다른 데이터셋은 zero-padding으로 100차원에 맞춘다.
- 마스킹: train 토큰끼리는 자유롭게 attend, test 토큰은 train 토큰만 attend(test끼리는 못 봄 → 정보 누설 없음, 각 test가 독립적으로 예측됨).
- 출력: 각 test 토큰의 출력에 softmax → 클래스별 확률 = PPD 근사값.
- PE 없음: 행 순서를 바꿔도 결과가 같다(데이터셋은 순서 없는 집합이라는 성질을 구조로 반영).
추론 과정 5단계
트랜스포머 내부에서 추론은 5단계로 진행된다. 예시로 train 3개 $(x_1,y_1),(x_2,y_2),(x_3,y_3)$ + test 2개 $x_4, x_5$를 넣는다고 하자.
1단계 — Tokenizer. train·test 행 하나가 벡터 하나로 변환된다.
\[z_i^{train} = W_x x_i + w_y y_i, \qquad z_j^{test} = W_x x_j\]여기서 $x_i \in \mathbb{R}^{100}$(feature + zero-padding으로 100), $W_x \in \mathbb{R}^{512\times100}$(feature를 512차원으로 보내는 투영), $y_i$는 클래스 번호이고 $w_y \in \mathbb{R}^{512\times1}$로 투영된다.
2단계 — 시퀀스로 결합. 모든 토큰(모든 행)을 하나의 시퀀스에 넣는다. 이래서 1000개 샘플 제약이 생긴다.
\[Z^{(0)} = [\,z_1^{tr}, z_2^{tr}, z_3^{tr}, z_4^{te}, z_5^{te}\,] \in \mathbb{R}^{5 \times 512}\]3단계 — 어텐션 블록 × 12. 모든 토큰이 Query·Key·Value로 투영된다.
\(Q = ZW_Q, \quad K = ZW_K, \quad V = ZW_V\) \(A = \mathrm{softmax}\!\Big(\frac{QK^{\top}}{\sqrt{d_k}} + M\Big)\)
마스킹 $M$은 어떤 토큰이 어떤 토큰을 볼지 정하는 행렬이다. 가릴 자리에 $-\infty$를 줘서 softmax 후 어텐션 스코어가 0이 되게 한다.
- train 토큰: train 토큰만 볼 수 있음 (test 토큰은 못 봄)
- test 토큰: 모든 train 토큰 + 자기 자신만 볼 수 있음 (다른 test 토큰은 못 봄)
어텐션 스코어 $A$는 $z^{test}$ 행에 대해 feature가 비슷한 train 행에 높은 가중치를 부여하고, 그들의 Value를 가중합으로 끌어온다. (이미 학습돼 있어서, $z_{test}$가 어떤 가설들의 분포로부터 나온 feature인지를 추론한다.) 각 텐서의 역할에 굳이 의미를 부여하자면:
| 텐서 | 학습하는 것 |
|---|---|
| Query | train 행과 test 행이 얼마나 비슷한지 |
| Key | train/test 쌍의 유사도를 측정하는 기준점 (feature 매칭에 집중) |
| Value | 그 토큰의 어떤 내용을 끌어올지 (라벨 값에 집중) |
head별 가중합 $o = \sum_{i \in train} A_i v_i$를 토큰에 residual로 더하고($x + o$), LayerNorm + FFN을 거쳐 다음 블록으로 간다.
12개 블록을 거치며 $z_{test}$ 토큰은 여러 가설과 train 데이터에서 끌어온 정답 라벨 정보를 자신의 512차원 벡터에 누적한다.
4단계 — 출력 추출. 시퀀스 $Z$에서 $z_{test}$ 토큰만 뽑아 MLP Head에 통과시킨 뒤 softmax → 클래스별 확률.
5단계 — PPD 근사값 출력. 이 클래스별 확률 분포가 Part 2에서 직접 계산할 수 없었던 PPD의 근사값이다. 샘플링 없이 forward pass 1번으로 끝난다.
학습 과정 & 스펙 — 단 한 번만 학습한다
추론과 학습은 같은 5단계를 공유한다. 다른 건 앞뒤에 데이터 생성과 역전파가 붙는다는 것뿐이다.
- 매 step마다 prior에서 가설 추출 → 입출력 쌍 1024행 생성 → 연속 출력을 클래스 라벨로 변환 → train/test 분할.
- 추론과 똑같이 5단계를 거쳐 예측.
- 예측한 정답 라벨의 확률값에 $-\log$를 씌우고, 데이터셋 내 평균 → 데이터셋끼리 평균 → 손실값 → 역전파.
- 한 step마다 데이터셋 512개(= 512개 가설)를 쓰고, 각 데이터셋마다 1024행을 생성하며, 이런 step을 18,000번 수행.
| 항목 | 스펙 |
|---|---|
| 한 step | 512 데이터셋 × 1024 행 |
| 총 step | 18,000 |
| 누적 규모 | 약 920만 개 데이터셋, 94억 개 행 |
| 하드웨어 | 12-layer Transformer, 8 GPU × 20시간 |
| 횟수 | 단 한 번만 학습 — 논문의 모든 실험이 이 모델 하나 |
한 번의 비싼 offline 사전학습이 끝나면, 이후 어떤 실데이터가 와도 추론은 forward pass 1번으로 끝난다. Boosting(데이터셋마다 학습+튜닝)과 정반대 지점이다. 추론 시 feature 컬럼 순서 회전·라벨 회전·power transform 적용 여부 등으로 변형한 입력 32개의 forward pass를 평균하는 앙상블 옵션도 있다.
Part 5. 실험 결과
Toy Problems — 결정 경계와 불확실성
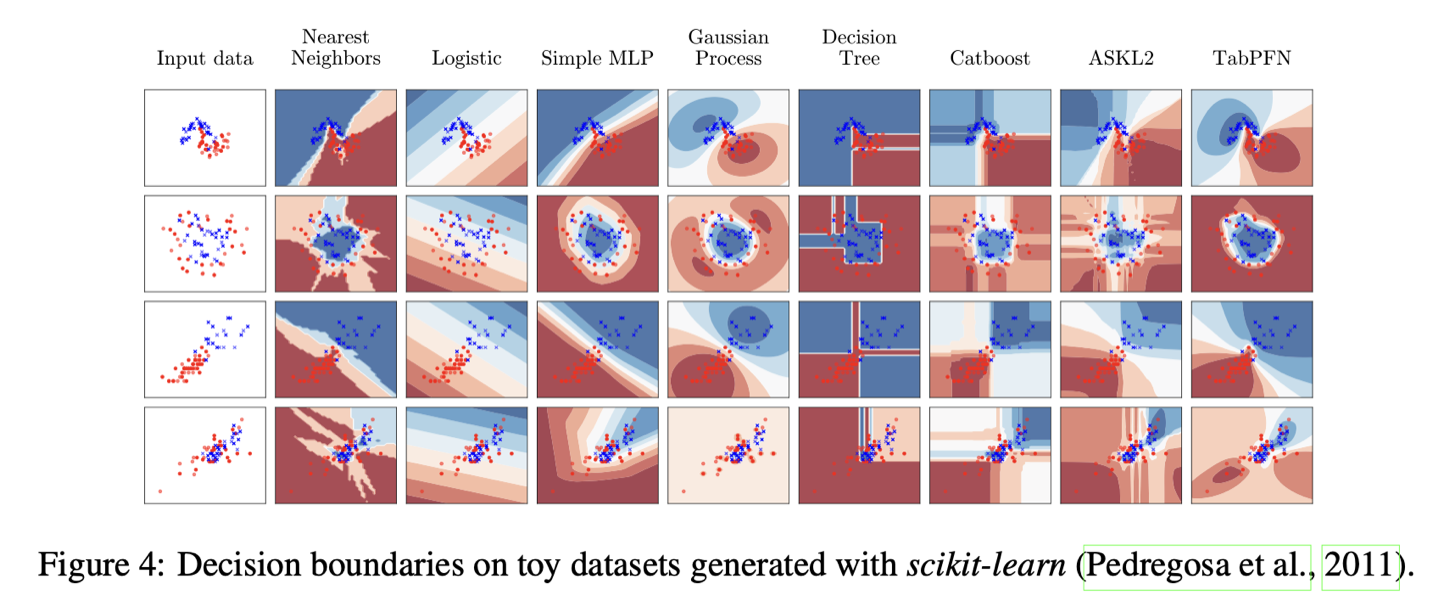
2D toy 데이터에서 결정 경계와 확률 지도를 비교한다. 트리 계열(Decision Tree)은 계단형 경계 + 데이터 없는 곳에서도 과신하는 반면, TabPFN은 매끄러운 경계 + 데이터에서 멀어지면 확률이 0.5 쪽으로 풀린다.
데이터가 없는 영역 = 가설들의 예측이 갈리는 영역 = 가중평균하면 불확실해지는 영역. Part 2에서 정리한 “모든 가설의 가중평균”이라는 PPD의 성질이 그림으로 드러난다.
Tabular ML Tasks — 1초 만에 SOTA급
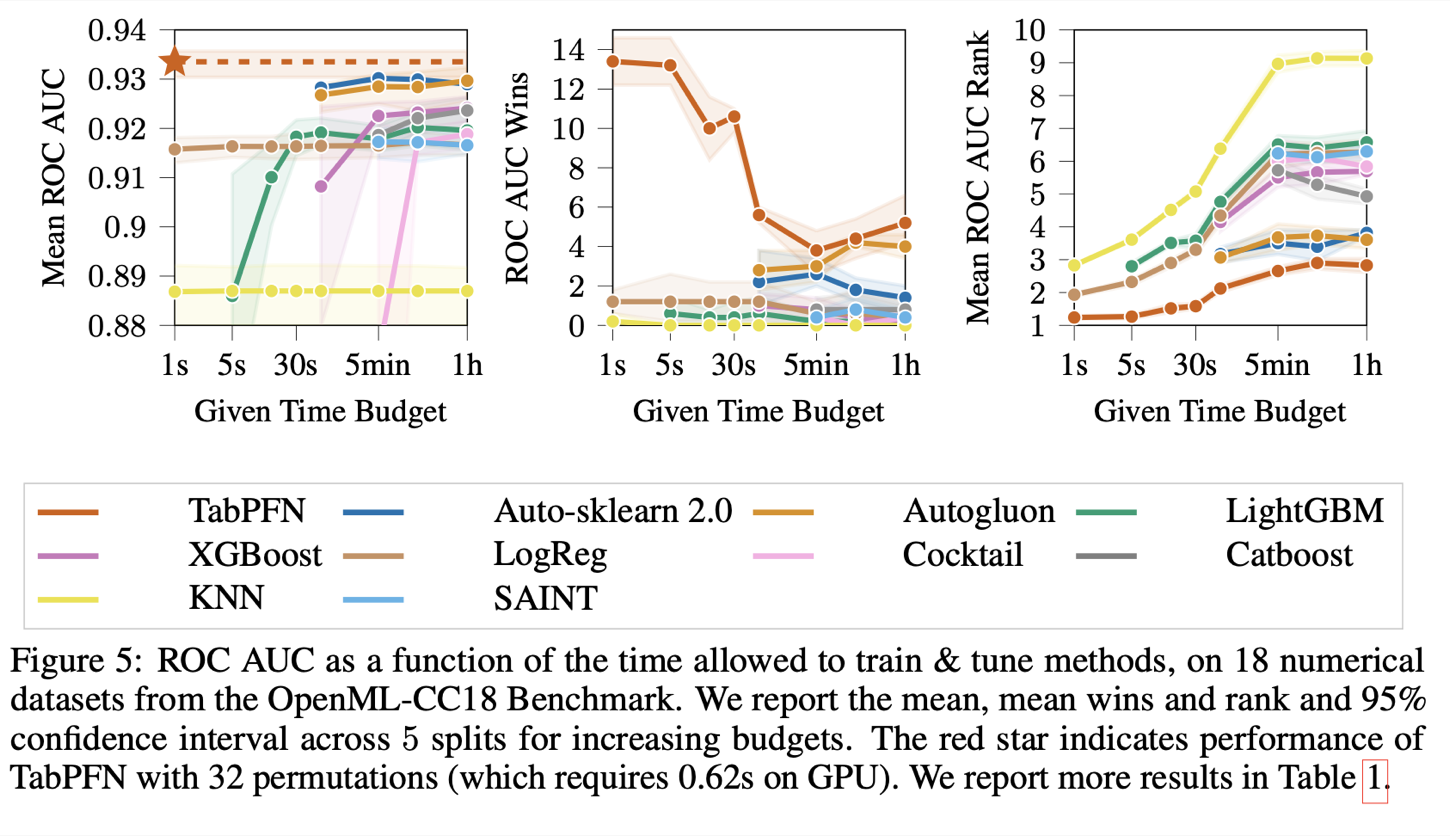
OpenML-CC18 중 소규모 조건(≤1,000 샘플, ≤100 수치형 feature, ≤10 클래스)을 만족하는 18개 데이터셋에서, 튜닝된 XGBoost·LightGBM·CatBoost와 AutoML(AutoGluon, Auto-sklearn 2.0)을 비교한다. 가로축은 학습·튜닝에 쓴 시간이다. 그런데 TabPFN은 시간이 사실상 0인 한 점(forward pass)일 뿐인데, 그 점이 다른 방법들의 곡선보다 위에 있다.
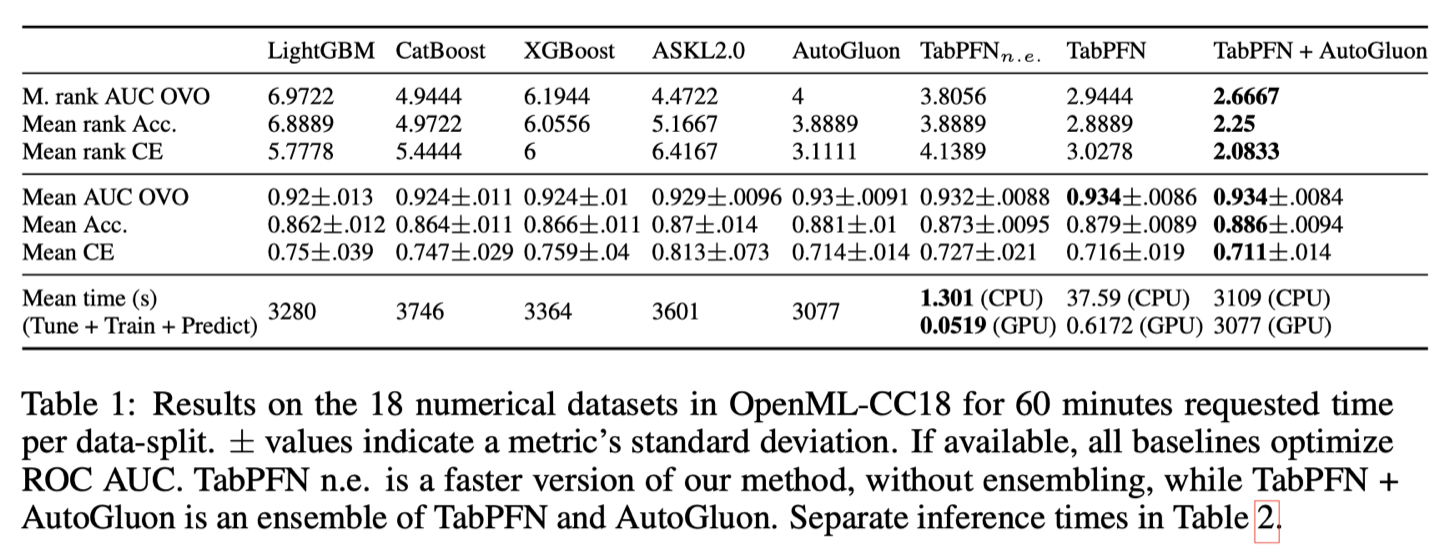
종합하면, 1시간 돌린 AutoML과 동급 성능을 1초 미만에 낸다(CPU 230×, GPU 5,700× speedup). 제목의 “in a Second”가 여기서 확인된다. 게다가 TabPFN의 오답 패턴이 기존 방법들과 상관이 낮아, 기존 모델과 앙상블하면 추가 향상 여지(표의 TabPFN + AutoGluon)가 있다.
Part 6. 한계 & 결론
Limitations
| 제약 | 값 |
|---|---|
| train 샘플 수 | ≤ 1,000개 |
| feature 수 | ≤ 100개 (수치형, 결측치 없음) |
| 클래스 수 | ≤ 10개 |
근본 원인은 트랜스포머 attention이 시퀀스 길이의 제곱으로 비싸다는 것이다. train set 전체가 입력이므로 행 수가 곧 시퀀스 길이라, 대규모 확장이 어렵다. 범주형·결측치는 prior에 그 패턴이 부족해 약하다. (이후 TabPFN v2가 이 한계 다수를 해소했다.)
Conclusion
- 테이블 데이터는 여전히 부스팅 계열이 우세 — 딥러닝은 데이터셋마다 학습하는 패러다임의 한계.
- 이상적 예측은 PPD지만 적분 불가 — MCMC는 느리고 VI는 부정확, 둘 다 매번 다시 풀어야 함.
- SCM(+Occam bias)과 BNN prior의 합성 데이터로 트랜스포머가 베이지안 추론 자체를 사전학습.
- 실데이터 학습 없이 forward pass 1번, 1초 미만에 SOTA급 — in-context learning의 가능성.
- 단, 소규모 데이터셋(≤1,000행 등)에 한정된다는 한계 존재.
헷갈리기 쉬운 포인트
발표를 준비하면서, 그리고 면접에서 막혔던(…) 질문들을 정리해놓았다. 특히 7~9번은 실제 면접에서 받았던, 기억에 남는 질문들이다.
1. “합성 데이터로만 배웠는데 왜 실데이터에서 되나?”
prior가 충분히 넓고 실데이터가 그 안에 있으면 PPD 근사가 일반화된다. 반대로 실데이터가 prior 밖이면(심한 범주형·결측치 등) 실제로 약해진다 — 한계와 일관된 답이다. 핵심은 prior(SCM의 인과 구조 + Occam bias)가 실제 테이블 데이터의 생성 방식과 닮았다는 가정이다.
2. “분류만 되나? 회귀는 안 되나?”
이 논문(2022)의 TabPFN은 분류 전용이다. 손실이 cross-entropy이고 출력이 클래스별 softmax라, SCM이 만든 연속 $y$도 굳이 구간을 나눠 라벨로 바꿔 학습했다. 회귀를 하려면 타깃을 이산화(bar distribution)하거나 별도 헤드가 필요한데, 이는 후속 연구(TabPFN v2)에서 다뤄진다.
3. “왜 BatchNorm이 아니라 LayerNorm인가?”
BatchNorm은 배치 통계에 의존하는데, 여기선 매 step마다 분포가 전혀 다른 데이터셋이 들어오고 train/test가 한 시퀀스에 섞여 있어 배치 통계가 불안정하다. 게다가 데이터셋은 순서 없는 집합이라 샘플별로 독립 정규화하는 LayerNorm이 자연스럽다. LayerNorm은 각 토큰(샘플)의 512차원 임베딩 분포를 정규화하므로 배치 크기·행 순서와 무관하다.
4. “왜 데이터셋 규모가 저렇게 한정되나?”
train set 전체가 트랜스포머의 입력 시퀀스이기 때문이다. attention 비용이 시퀀스 길이의 제곱($O(n^2)$)이라, 행이 늘면 비용이 폭증한다. 그래서 ≤1,000행 제약이 생긴다.
5. “Q·K·V가 각각 무슨 의미를 담나?”
엄밀히는 학습으로 정해지는 투영이라 사후 해석이지만, 직관적으로 Query는 “test가 어떤 train과 비슷한가”, Key는 “유사도를 재는 기준(feature 매칭)”, Value는 “끌어올 내용(주로 라벨)”에 대응한다. attention이 feature가 비슷한 train의 라벨을 가중합하는 구조라고 보면 된다.
6. “attention이 베이지안 추론을 한다는 게 무슨 뜻인가?”
증명된 것은 ‘손실 최소화 = PPD와의 KL 최소화’ 라는 목적함수 수준의 동치다(Müller et al., 2022). 즉 학습된 모델의 출력이 PPD에 수렴한다는 것이지, attention의 내부 메커니즘이 베이즈 정리를 명시적으로 계산한다는 뜻은 아니다. 그 내부 해석은 아직 열린 문제다.
7. “Occam bias를 주면 결정 경계가 어떻게 형성되나?” (실제 면접 질문)
Occam bias는 결정 경계가 그려지기 이전 단계, 즉 prior에서 작동한다. TabPFN의 prior는 랜덤 MLP(SCM)로 합성 데이터셋을 무수히 뽑는데, Occam bias는 “노드·파라미터가 적은 단순한 SCM이 더 자주 뽑히도록” 확률을 기울여 놓는 장치다. 그래서 사전학습 동안 모델이 보는 세계의 대부분은 소수의 매끄러운 인과 관계로 설명되는 단순한 데이터셋이다.
이게 결정 경계로 번역되는 통로가 PPD다. 베이즈 규칙 $posterior \propto likelihood \times prior$에서, 같은 train 데이터를 똑같이 잘 설명하는 가설이 여럿일 때(likelihood가 비슷할 때) 이들을 가르는 것은 prior다. Occam bias 덕분에 단순한 가설이 더 큰 posterior 무게를 가져가고, 그 가중평균이 곧 매끄럽고 일반화 잘 되는 경계가 된다. 앞의 decision boundary 그림에서 TabPFN의 경계가 들쭉날쭉하지 않고 부드러운 곡선인 이유다.
한 가지 구분이 중요하다. “데이터 없는 영역에서 확률이 0.5 쪽으로 풀리는” 효과는 사실 Occam bias 고유의 것이 아니라 베이지안 평균(PPD 주변화) 자체의 성질이다 — 단순성 prior가 없어도 가설들을 평균내면 외삽 영역은 회색지대가 된다. Occam bias의 역할은 그 평균에서 어떤 가설이 지배하느냐(매끄러운 쪽) 를 정하는 것이다.
결국 Occam bias는 따로 정규화 항이나 튜닝 없이 작동하는 베이지안 정규화다. 작은 데이터에서 노이즈에 맞춰 경계를 비트는 과적합을, prior가 단순한 설명을 선호함으로써 막아준다.
8. “범주형 feature(red/green/blue)에 왜 약한가 — 어차피 라벨로 변환하잖아?” (실제 면접 질문)
이 질문의 함정은 “이산화되는 게 입력 feature $x$가 아니라 출력 타깃 $y$”라는 점을 흐려놓은 데 있다. SCM/BNN이 “라벨로 변환”하는 건 맞지만, 변환 대상은 출력 노드 $z_y$(연속값)를 랜덤한 클래스 경계로 잘라 만든 분류 라벨이다. 즉 이산화는 “회귀처럼 생긴 연속 출력을 분류 문제로 만들기 위한 타깃 처리”일 뿐, 입력 feature가 범주형이 되는 것과는 무관하다.
prior가 만드는 입력 feature는 SCM 그래프 노드에 가우시안 노이즈를 흘려 전파시킨 연속값이고, 그 위의 인과 관계는 매끄럽고 순서·거리 구조가 있는 함수다. 반면 red/green/blue는 순서 없는(nominal) 이산값이라, 0/1/2로 인코딩하면 red < green < blue라는 가짜 순서와 거리($red \leftrightarrow blue = 2$)라는 가짜 구조가 생긴다. 문제는 이런 “순서 없는 이산 입력” 패턴이 prior에서 심하게 과소표현(out-of-prior) 된다는 것이다. 모델은 연속·매끄러운 입력을 기대하도록 사전학습됐는데, 그 분포 밖의 입력이 들어오니 PPD 근사가 prior의 뒷받침을 못 받아 신뢰할 수 없어진다.
결측치는 한 술 더 떠 두 가지가 겹친다. ① TabPFN v1은 완전히 채워진 수치 행렬을 입력 규약으로 가정해 결측을 다룰 메커니즘 자체가 없고(별도 임퓨테이션 필요), ② prior의 SCM도 모든 feature가 채워진 입력을 전제하므로 “빈 값” 패턴이 prior에 없다. 입력 규약 위반 + prior 미커버가 함께 작용한다.
정리하면, 출력 라벨 이산화(타깃 쪽)와 입력 feature의 범주형성(입력 쪽)은 완전히 별개의 사안이다. v1이 범주형·결측에 약한 건 “분류를 못 해서”가 아니라 prior가 연속·매끄러운 입력에 압도적으로 치우쳐 있어서다.
9. “TabPFN v2는 뭘 개선했나?” (실제 면접 질문)
v1은 컨셉을 증명했지만 깨끗한 수치형, 1,000행·100 feature·10 클래스 이하라는 좁은 범위에 갇혀 있었다. TabPFN v2(Hollmann et al., Nature 637:319–326, 2025년 1월) 는 정확히 이 한계들을 해결했다. 네 축으로 요약된다.
- 규모 & 회귀: 약 1만 샘플·500 feature(v1 대비 행 10배, feature 5배)로 확장하고, 분류만 되던 v1과 달리 회귀를 정식 지원한다. 회귀는 점 추정을 직접 뱉지 않고 타깃 구간을 여러 bin으로 나눈 piecewise-constant 분포(Riemann/bar distribution) 로 PPD를 출력해, 거기서 평균·중앙값·분위수를 뽑는다.
- 지저분한 실데이터: v1이 약했던 범주형·결측치·이상치를 네이티브로 처리한다. prior 자체를 더 현실적으로 바꾼 결과로, v2는 결측·불균형·노이즈까지 시뮬레이션한 약 1.3억 개 합성 데이터셋으로 사전학습됐다.
- 2D 어텐션: v1은 샘플(행) 축으로만 어텐션을 걸었지만, v2는 각 셀을 임베딩한 뒤 샘플 축과 feature 축을 번갈아 어텐션한다. 덕분에 행·열 순서 모두에 permutation-invariant해지고, feature를 고정 위치에 욱여넣던 v1의 한계가 풀린다.
- prior 철학은 계승: 입력은 연속·매끄러운 인과, 타깃 $y$만 이산화, Occam bias라는 v1의 골격은 그대로 가져가 확장했다.
그 결과 v2는 튜닝된 그래디언트 부스팅을 표준 벤치마크에서 본격적으로 앞선 첫 tabular foundation model 로 평가받으며(논문 기준 분류 약 5,140×·회귀 약 3,000× 속도 우위) Nature에 실렸다. 이후 2025년 11월 v2.5에서 약 5만 행·2천 feature로 한 번 더 확장됐다.
정리하며
TabPFN의 핵심은 다음 한 문장으로 요약된다.
SCM·BNN prior에서 무한히 합성 데이터를 만들어 “train을 보고 test를 맞추는 게임”을 시키면, 트랜스포머가 베이지안 추론(PPD) 자체를 학습한다 — 그래서 새 테이블 데이터를 학습 없이 forward pass 한 번에 분류한다.
전체 흐름은 다음과 같다.
테이블 데이터의 한계 → 이상적 예측 PPD → 적분 불가(intractable) → MCMC·VI는 매번 다시 → PFN은 적분 푸는 법을 사전학습 → SCM·BNN prior로 합성 데이터 → 손실 최소화 = PPD 근사 → forward pass 1번에 SOTA
돌아보면 느리고 정확한 베이지안 추론을, 트랜스포머라는 빠른 근사기로 옮겨 담은 논문이다. 면접에서 가장 어려운 논문을 고른 객기 덕분에, 우도·prior·posterior·PPD라는 베이지안의 기본기를 다시 제대로 익히게 됐다.
발표는 잘 못 했지만, 그 값은 했다는 생각이 든다. GGWP
참고
- Hollmann, N., Müller, S., Eggensperger, K., & Hutter, F. (2022). TabPFN: A Transformer That Solves Small Tabular Classification Problems in a Second. ICLR 2023. arXiv:2207.01848.
- Müller, S., Hollmann, N., Arango, S. P., Grabocka, J., & Hutter, F. (2022). Transformers Can Do Bayesian Inference. ICLR 2022. — PFN 원논문, 손실=PPD 근사 증명.
« CLIP 논문 리뷰 - 자연어로 이미지를 분류하다
1. FFDP 논문 리뷰 - 가려진 움직임을 주파수로 복원하기 »