1. FFDP 논문 리뷰 - 가려진 움직임을 주파수로 복원하기
해설글
작성 · 13분 읽기 · 조회수 —수정
손필기와 후속 대화를 논문·보충자료와 대조해 정리
논문을 처음 읽었을 때 걸린 표현은 “웨이블릿 계수 선택 문제”였다. 가려진 관절을 복원하는 문제와 주파수 계수를 고르는 문제가 어떻게 같은 문제가 되는지 바로 연결되지 않았다.
작은 좌표 배열로 DWT를 계산해 보니 움직임을 여러 성분으로 나눈다는 것까지는 알 수 있었다. 그다음 질문이 남았다.
결론적으로 이걸 통해서 하나의 장면에서 움직임을 여러가지 성분으로 추출한다는 걸 알았어. 그런데 이걸 왜 하는거야?
계산 방법보다 이 질문이 논문의 설계를 이해하는 데 더 중요했다. DWT가 오류를 알아서 지우는 것이 아니라면, 성분을 나눈 뒤에는 누가 무엇을 판단하는가.
Occluded Human Body Capture with Frequency Domain Denoising Prior
Buzhen Huang, Chongyang Xu, Wentao Tang, Yuan Shu, Jingyi Ju, Binghui Zuo, Yangang Wang · CVPR 2026
논문 페이지 · 공식 PDF · 보충자료
한 문장으로 정리하면, FFDP는 관절 좌표를 시간축과 펼친 관절 좌표축의 주파수 성분으로 바꾸고, 2D 잡음 제거로 배운 사전을 이용해 가려진 구간의 3D 동작을 복원한다.
이 글에서는 DWT를 왜 넣었는지, 전체 파이프라인이 어떻게 이어지는지, 실험이 어느 주장까지 뒷받침하는지를 살펴본다. 필터 인덱스와 확산식, DDIM, 단계별 학습은 2편의 수식과 학습 구조에서 이어서 다룬다.
Part 1. 가려진 한 프레임보다 가려지기 전후의 움직임
관절 검출값을 그대로 믿기 어려운 상황
FFDP는 단안 RGB 영상에서 먼저 2D 관절을 찾고, 그 관측과 이미지 특징을 이용해 3D 자세와 이동을 추정한다. 문제는 팔이나 다리가 물체 뒤로 들어갔을 때 생긴다.
2D detector가 가려진 손목을 엉뚱한 곳에 찍을 수도 있고, 아예 낮은 confidence를 낼 수도 있다. 한 프레임만 보면 어느 위치가 맞는지 판단하기 어렵다. 하지만 영상에는 앞뒤 프레임이 있다. 손목이 가려지기 직전까지 어느 방향으로 움직였는지, 연결된 팔꿈치와 어깨가 어떻게 변했는지는 남아 있을 수 있다.
이 문제의 흐름에는 같은 저자진 일부가 참여한 앞선 연구들이 있다.
| 연구 | 해결 범위 | FFDP와 확인 가능한 연결 |
|---|---|---|
| OOH | 단일 RGB 이미지의 물체 가림 인체를 복원하고 3DOH50K를 구축 | object-occlusion 문제와 데이터의 선행 기반 |
| CHOMP | 가려지지 않은 동작에서 시공간 prior를 학습하고 OcMotion을 제시 | 일부 저자와 OcMotion 데이터 자산을 공유하는 직접 선행 흐름 |
| FFDP | detector 중심의 불확실성, 주파수 영역 확산, 2D prior와 3D decoder 결합 | 같은 문제를 주파수 영역의 잡음 제거로 다시 정식화 |
이를 OOH → CHOMP → FFDP라는 하나의 모델 계보로 단정하면 정확하지 않다.
FFDP 본문은 CHOMP 네트워크를 그대로 가져왔다고 밝히지 않는다.
확인할 수 있는 것은 단일 이미지 가림, 영상의 motion prior, OcMotion으로 문제와 데이터의 흐름이 이어진다는 점이다.
방법론적으로 가까운 비교점은 MotionWavelet이다. MotionWavelet도 3D motion을 wavelet 영역에서 diffusion으로 다룬다. 다만 FFDP의 핵심에는 detector가 제공한 2D 관절을 조건으로 쓰고, reliable 관절을 유지하며, 2D prior를 먼저 학습하는 과정이 더 들어간다.
시간 영역의 부드러움만으로 부족한 부분
동작은 대체로 연속적이지만 항상 천천히 변하지는 않는다. 발을 차거나 팔을 빠르게 휘두르는 동작도 실제 움직임이다. 고주파 성분을 모두 잡음으로 보고 없애면 이런 변화까지 지울 수 있다.
반대로 가림으로 잘못 검출된 좌표가 여러 프레임 동안 같은 위치에 머물면 오류가 저주파 성분에도 섞일 수 있다. 그래서 이 문제는 “고주파를 제거한다”로 단순화할 수 없다.
논문의 선택은 오류의 주파수를 미리 정하는 방식이 아니다. 먼저 신호를 여러 부대역으로 나누고, 다른 프레임과 관절의 관계를 보며 각 계수를 얼마나 사용할지 학습한다.
Part 2. DWT는 답을 고르기 전에 문제를 펼쳐 놓는다
평균과 차이로 변화의 위치를 드러내기
손필기에서 사용한 좌표 예시를 다시 보자. 아래 계산은 DWT의 직관을 위한 단순화이며 FFDP가 사용하는 wavelet filter의 정확한 계수는 아니다.
[설명용 유도: 평균과 반차이를 이용한 1차원 예시]
\[x=[10,12,14,30,31,32,33,34]\] \[L(a,b)=\frac{a+b}{2},\qquad H(a,b)=\frac{a-b}{2}\] \[L_1=[11,22,31.5,33.5],\qquad H_1=[-1,-8,-0.5,-0.5]\]두 번째 묶음의 고주파 계수 -8이 유난히 크다.
원래 좌표에서는 14에서 30으로 튄 구간이다.
이 계산으로 알 수 있는 것은 그 위치에서 짧은 범위의 변화가 컸다는 사실이다.
그 변화가 가림 오류인지 빠른 동작인지는 아직 모른다. DWT에는 의미를 판정하는 기준이 없다. 고정된 low-pass와 high-pass filter로 입력을 다른 좌표계에 표현할 뿐이다.
이 구분이 처음 질문에 대한 답이었다.
- DWT는 변화의 위치와 성격을 부대역으로 드러낸다.
- 신경망은 주변 프레임과 다른 관절을 보며 그 변화가 믿을 만한지 학습한다.
- iDWT는 조절된 계수를 다시 좌표 시퀀스로 돌린다.
일반적인 다중 레벨 DWT에서는 low 성분을 다시 나눠 더 긴 시간 범위를 볼 수 있다. 하지만 FFDP의 보충자료가 밝힌 설정은 decomposition level 1이다. 위 예시를 여러 번 반복해 분해할 수 있다는 일반론과 논문의 실제 설정을 섞으면 안 된다. 사용한 wavelet family와 경계 처리 방식도 논문과 보충자료에는 명시되어 있지 않다.
시간축과 관절 좌표축의 네 부대역
FFDP의 2D 관절 시퀀스는 다음 모양이다.
[논문 원문: 본문 §3.3의 입력 표현]
\[P_t\in\mathbb R^{N\times2J}\]$N$은 프레임 수이고, $2J$는 $J$개 관절의 $x,y$ 좌표를 펼친 축이다.
논문은 이 두 축에 2D DWT를 적용해 LL, LH, HL, HH를 만든다.
보충자료의 시간 창은 36프레임이다.
첫 글자를 시간축, 두 번째 글자를 펼친 관절 좌표축의 필터라고 두면 다음처럼 읽을 수 있다.
| 부대역 | 직접 나타내는 성분 | 바로 붙이면 안 되는 의미 |
|---|---|---|
| LL | 두 축에서 완만한 변화 | 걷기나 전역 이동이라는 동작 이름 |
| LH | 시간축은 완만하고 좌표 배열축은 빠른 변화 | 특정 팔만 움직였다는 결론 |
| HL | 시간축은 빠르고 좌표 배열축은 완만한 변화 | 몸 전체의 빠른 이동이라는 결론 |
| HH | 두 축에서 빠른 변화 | 잡음 또는 특정 관절 동작이라는 결론 |
여기서 두 번째 축은 이미지의 가로·세로 공간이 아니다. 관절 좌표를 펼친 배열의 축이다. 배열에서 이웃한 값과 실제 뼈대에서 이웃한 관절이 언제나 일치하는지는 관절 순서와 좌표 배치에 달려 있다. 이 부분은 마지막에 다시 돌아온다.
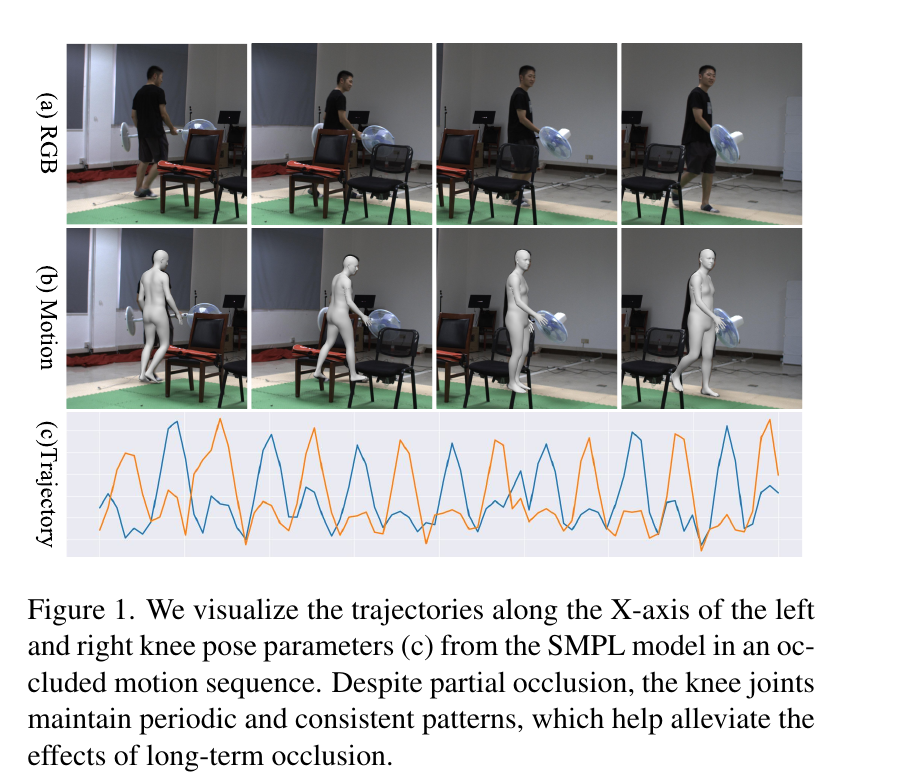 출처: 논문 Fig. 1. RGB 프레임, 복원한 motion, SMPL 무릎 pose parameter의 x축 시간 궤적을 함께 보여 준다. 가림 구간에서도 궤적이 시간에 따라 이어지는 모습을 확인하는 그림이며, DWT 계수를 직접 비교한 그림은 아니다. 이미지를 누르면 크게 볼 수 있다.
계수 선택은 top-k가 아니다
논문은 네 부대역을 이어 붙여 prior encoder와 decoder에 넣는다. 각 부대역에 대해 수정된 계수와 coefficient map을 예측한다.
[논문 원문: 본문 식 (4)]
\[(\hat y_{h,v},m_{h,v})=F_{h,v}(y),\qquad h,v\in\{L,H\}\][논문 원문: 본문 식 (4) 직후의 coefficient selection 정의]
\[\bar y_{h,v}=m_{h,v}\odot\hat y_{h,v}\]논문이 말하는 coefficient selection은 이 원소별 곱셈이다. 가장 큰 계수 몇 개만 남기는 top-k도 아니고, 고주파를 모두 0으로 만드는 고정 필터도 아니다. coefficient map의 범위와 활성함수는 공개 문헌에 적혀 있지 않으므로 binary mask나 0과 1 사이의 gate라고 단정할 수도 없다.
결국 DWT는 문제를 풀기 좋은 표현을 제공한다. 실제 선택은 학습된 네트워크의 출력이 수행한다.
Part 3. 검출 좌표 주변에서 복원을 시작한다
확신할 수 있는 관절과 불확실한 관절
FFDP는 ViTPose++-B가 낸 2D 관절과 confidence를 사용한다. 보충자료의 OcMotion 실험에서 채택한 threshold는 0.7이다. 이 수치는 다른 detector와 데이터셋에도 그대로 맞는 보편적인 기준은 아니다.
confidence가 높은 관절은 forward와 reverse diffusion 동안 원래 검출 좌표를 유지한다. confidence가 낮은 관절만 잡음 제거의 대상이 된다.
이 설계에는 중요한 전제가 있다. detector가 자신 있게 맞힌 좌표는 좋은 조건이 되지만, 자신 있게 틀린 좌표는 고정된 오류가 될 수 있다. confidence는 정답 여부가 아니라 detector의 확신이기 때문이다.
가우시안 분포가 모델에 들어가는 방식
처음에는 “검출 좌표를 평균으로 사용한다”는 말이 모호했다. 그래서 가우시안 분포를 정의한 뒤 실제로 어떤 값이 DWT에 들어가는지 질문했다.
실제로 입력되는 것은 분포가 아니라 그 분포에서 뽑은 좌표 표본이다. 한 관절의 검출 좌표가 $p$라면, 마지막 잡음 단계의 초기값은 detector 좌표 주변의 분포에서 얻는다.
[설명용 유도: 추론 초기 표본의 직관]
\[\epsilon\sim\mathcal N(0,I),\qquad p_T=p+\epsilon\] \[p_T\sim\mathcal N(p,I)\]잡음의 평균은 0이고, 잡음을 더한 좌표의 평균이 detector 좌표 $p$다. 이 표본을 다른 관절의 좌표와 합쳐 $N\times2J$ 배열을 만든 뒤 DWT에 넣는다. 논문의 유한한 forward schedule 끝점이 이 분포에 정확히 도달하는지는 별개이며, 끝점 식은 $\hat\alpha_T$가 충분히 작을 때 이 초기분포에 가까워진다고 설명하는 편이 정확하다.
학습의 중간 단계는 항상 같은 $\mathcal N(p,I)$에서 뽑는 과정이 아니다. 논문의 조건부 forward 식은 정답 좌표에서 detector 중심 분포 쪽으로 점차 이동한다. 그 식과 DDIM 갱신은 2편에서 기호를 하나씩 따라가며 설명한다.
36프레임과 5번의 확산은 다른 축
보충자료는 36프레임의 시간 창, 학습 diffusion timestep 100, 추론 DDIM 5 step을 사용한다고 밝힌다. 여기서 5 step은 다섯 프레임을 차례로 만드는 횟수가 아니다.
36프레임 전체의 noisy 2D pose
    → 모델 평가와 다음 잡음 단계 계산
36프레임 전체의 다음 diffusion 상태
    → 다음 모델 평가
...
36프레임 전체의 복원 결과
영상의 시간축과 diffusion의 잡음 단계축은 서로 다르다. DDIM이 선택하는 정확한 timestep 배열과 세부 schedule은 공개 문헌에 나오지 않는다. 따라서 “100개 중 무작위로 5개를 고른다”거나 특정 숫자 배열을 논문의 실행 순서로 쓰면 근거를 넘는다.
Part 4. 2D 잡음 제거 사전에서 3D 동작까지
전체 구조를 한 번에 보기
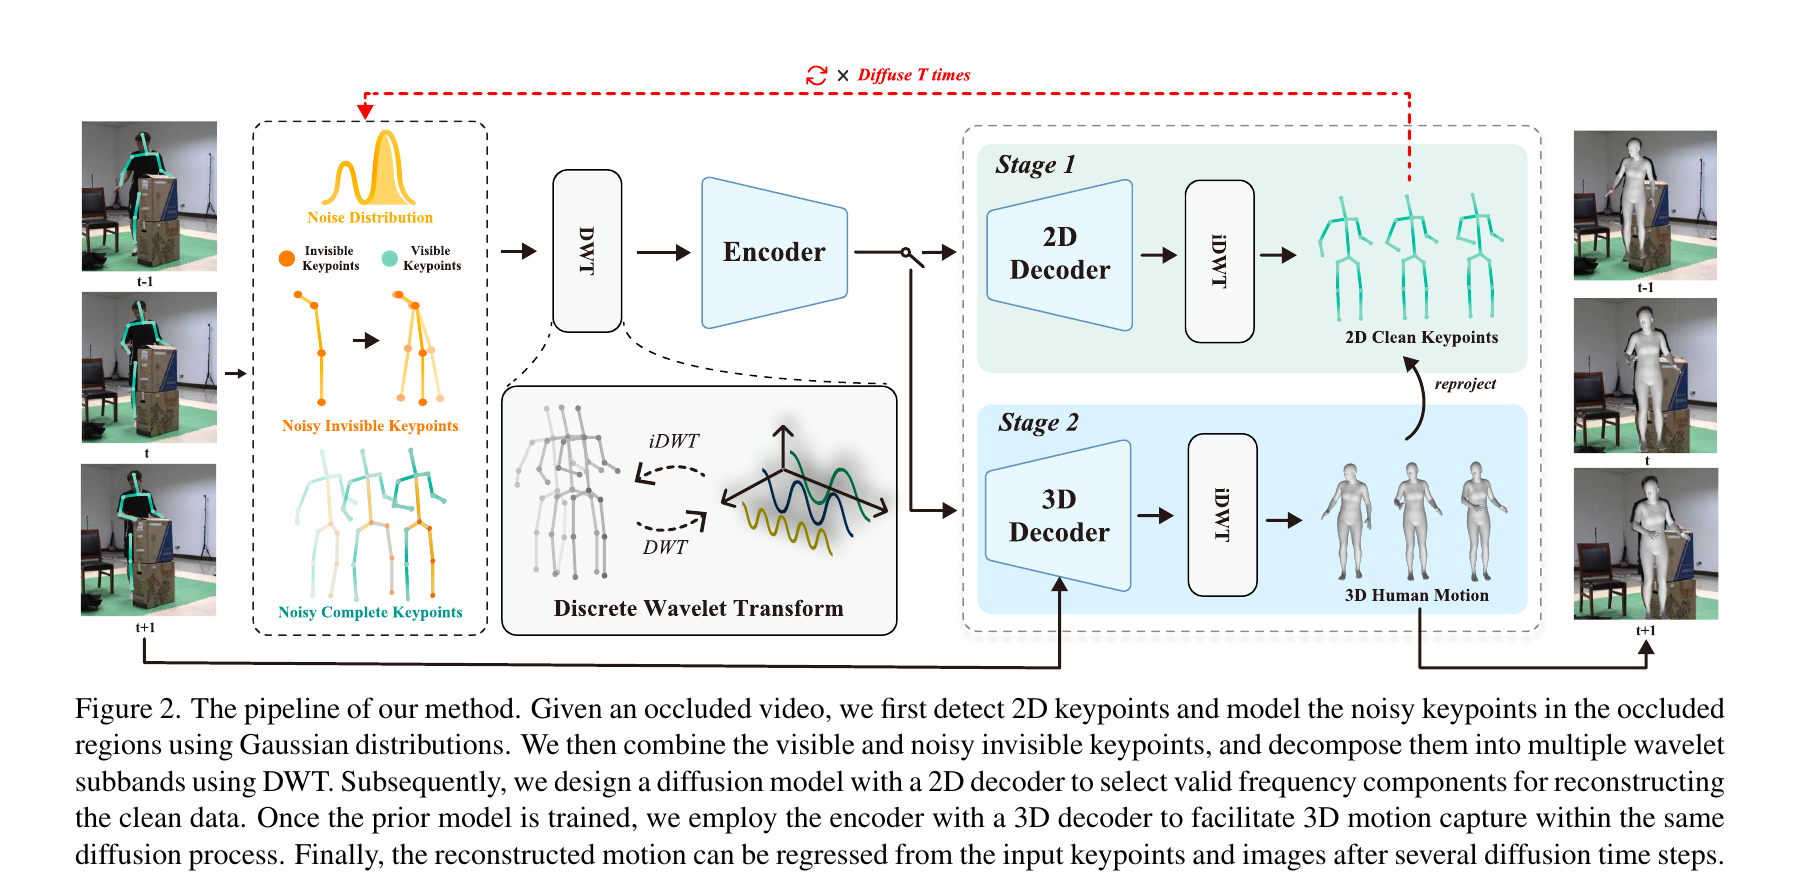 출처: 논문 Fig. 2. 위쪽의 2D diffusion prior와 아래쪽의 3D motion decoder가 두 단계로 학습된다는 점을 중심으로 보면 된다. 이미지를 누르면 크게 볼 수 있다.
FFDP의 구조는 두 학습 단계로 나누어 보는 것이 가장 분명하다.
- noisy 2D 관절 시퀀스를 깨끗한 2D 좌표로 복원하는 prior를 학습한다.
- prior encoder를 고정하고 RGB 특징까지 조건으로 받아 3D motion을 예측하는 decoder를 학습한다.
별도의 “2D Encoder”가 있는 구조로 부르면 혼동이 생긴다. 정확한 구분은 공통 prior encoder + 2D decoder + 3D decoder다.
보충자료에 따르면 prior encoder는 공간 정보와 시간 정보를 처리하는 두 개의 분리된 Transformer를 사용한다. 2D decoder는 LayerNorm과 Linear로 구성되고, 3D decoder는 Transformer다.
Stage 1에서 배우는 2D prior
Stage 1의 흐름은 다음과 같다.
신뢰 관절은 유지하고 불신뢰 관절만 noisy하게 만든 2D 시퀀스
    → 고정 DWT
    → 학습하는 prior encoder
    → 학습하는 2D decoder와 coefficient map
    → 고정 iDWT
    → 깨끗한 2D 좌표 예측
    → GT 2D 좌표와 L1 loss
[논문 원문: 본문 식 (6)의 L1 keypoint loss]
\[\mathcal L_{keyp}=|P-\hat P|\]랜덤한 잡음 표본을 쓰면서도 학습할 수 있는 이유는 난수 자체를 외우는 것이 아니기 때문이다. 여러 잡음 입력에서 관측 가능한 관절과 시간적 관계를 이용해 깨끗한 좌표를 복원하는 네트워크 가중치를 학습한다.
Stage 2에서 예측하는 3D motion
Stage 2에서는 prior encoder를 고정한다. 3D decoder는 분해된 2D subband, prior의 latent embedding, RGB ViT feature를 함께 조건으로 받는다. 출력은 3D motion의 subband와 사람의 shape다.
[논문 원문: 본문 식 (7)–(8)]
\[(Y_{h,v},\beta)=D(y,z,I),\qquad x=\operatorname{iDWT}(Y)\]$I$는 이미지 특징, $z$는 prior의 latent embedding, $\beta$는 사람의 shape다. $x$는 프레임별 SMPL pose $\theta$와 translation $\tau$를 포함한다. 2D 스켈레톤을 시간순으로 나열하면 저절로 3D가 되는 구조가 아니다. 깊이 모호성을 줄이기 위해 2D prior뿐 아니라 RGB 특징과 3D supervision이 함께 필요하다.
3D decoder는 SMPL parameter, 3D joint, vertex, 재투영한 2D keypoint에 대한 손실로 학습된다.
[논문 원문: 본문 식 (9)]
\[\mathcal L=\mathcal L_{smpl}+\mathcal L_{joint}+\mathcal L_{verts}+\mathcal L_{keyp}\]재투영 손실이 있다는 사실은 추론 때 3D 결과를 반복 최적화한다는 뜻이 아니다. 논문은 이를 3D decoder의 학습 신호로 사용한다.
Part 5. 실험은 주파수 변환보다 두 단계 설계를 보여 준다
비교 결과를 읽는 기준
FFDP는 OcMotion, 3DPW, 3DPW-OC, EgoBody 등에서 기존 방법과 비교한다. 본문 Table 2의 주파수 표현 직접 비교 대상에는 PhaseMP가 포함된다. PhaseMP의 비정상 동작과 깊이 모호성에 대한 한계 평가는 FFDP 저자들의 해석으로 읽어야 한다.
RoHM은 본문 Table 2가 아니라 보충자료 Table 5에서 같은 EgoBody sequence를 이용해 비교한 diffusion 기준선이다. GLAMR는 관련 연구에서 time-domain motion prior의 사례로 다루지만 본문 Table 2의 정량 baseline은 아니다. 서로 다른 위치의 비교를 한 표에서 동일한 조건처럼 합치면 안 된다.
논문이 보고한 결과에서 FFDP는 여러 가림 데이터셋의 pose 및 motion 지표에서 강한 성능을 보인다.
Table 2의 Ours (w/o OcMotion training) 행을 보면 다음과 같다.
표의 값은 오차 지표이므로 낮을수록 좋게 읽되, 원문 표에는 아래 화살표와 단위가 따로 적혀 있지 않다.
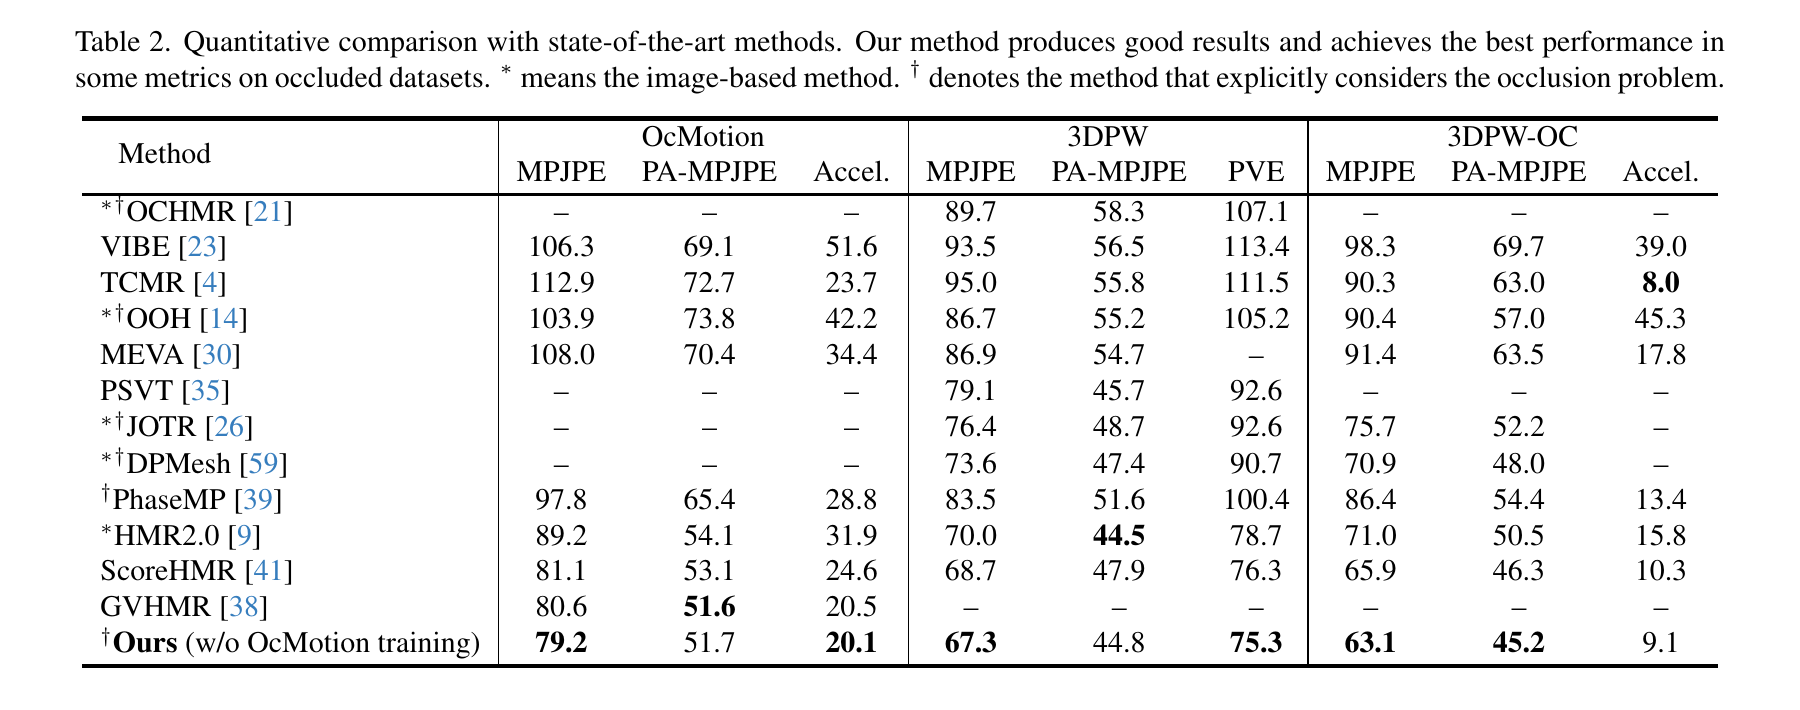 출처: 논문 Table 2. 별표는 image-based method, dagger는 occlusion을 명시적으로 다루는 방법이며, 빈 칸은 보고값이 없다는 뜻이다. 이미지를 누르면 크게 볼 수 있다.
| 평가 데이터 | MPJPE | PA-MPJPE | 세 번째 지표 |
|---|---|---|---|
| OcMotion | 79.2 | 51.7 | Accel 20.1 |
| 3DPW | 67.3 | 44.8 | PVE 75.3 |
| 3DPW-OC | 63.1 | 45.2 | Accel 9.1 |
출처: 논문 Table 2의 Ours (w/o OcMotion training) 행. 수치는 저자 보고값이며 이 글에서 재현한 결과가 아니다.
모든 열에서 1위인 것은 아니다. OcMotion PA-MPJPE는 GVHMR의 51.6, 3DPW PA-MPJPE는 HMR2.0의 44.5, 3DPW-OC Accel은 TCMR의 8.0이 더 낮다. 따라서 “모든 지표에서 가장 좋다”보다, OcMotion으로 추가 학습하지 않은 조건에서도 여러 데이터셋에서 경쟁력 있는 오차를 보였다고 읽는 편이 정확하다.
전체 수치만으로 DWT, 2D prior, RGB 조건 가운데 무엇이 효과를 냈는지는 알 수 없다. 그 질문에는 절제 실험이 더 중요하다.
절제 실험의 핵심
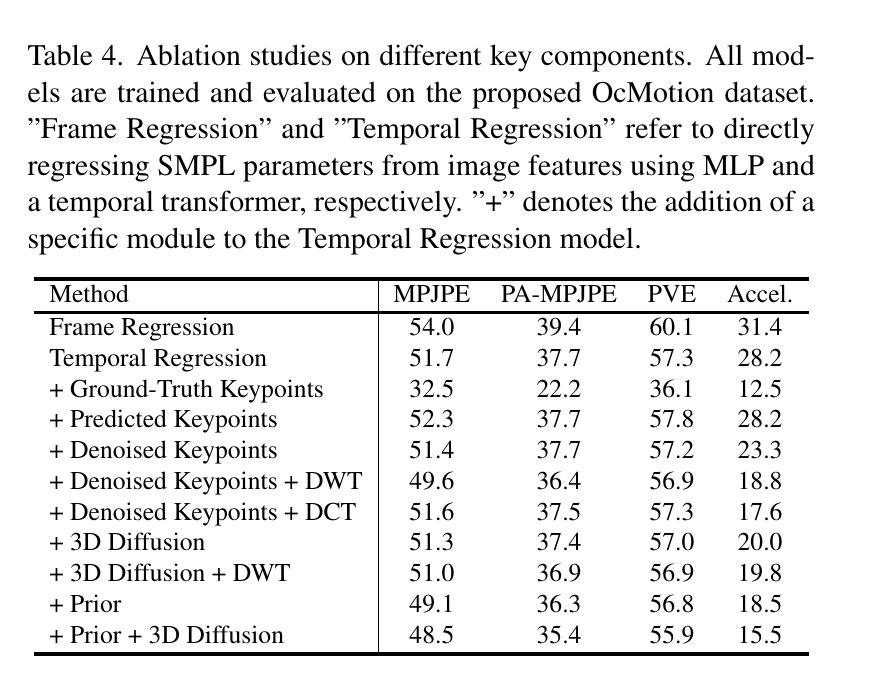 출처: 논문 Table 4. 각 행의 조건과 지표 방향을 함께 확인해야 한다. 수치는 저자 보고값이며 이 글에서 재현한 결과가 아니다. 이미지를 누르면 크게 볼 수 있다.
절제 실험에서 구분해야 할 설계는 다음과 같다.
- frame regression과 temporal regression
- predicted keypoint와 denoised keypoint를 입력한 경우
- denoised keypoint에 DWT 또는 DCT를 적용한 경우
- 3D diffusion, 2D prior, 두 구성을 결합한 경우
OcMotion에서 학습하고 평가한 Table 4 가운데 핵심 행을 옮기면 다음과 같다.
| 구성 | MPJPE | PA-MPJPE | PVE | Accel |
|---|---|---|---|---|
| Denoised Keypoints + DCT | 51.6 | 37.5 | 57.3 | 17.6 |
| Denoised Keypoints + DWT | 49.6 | 36.4 | 56.9 | 18.8 |
| Prior + 3D Diffusion | 48.5 | 35.4 | 55.9 | 15.5 |
| GT Keypoints | 32.5 | 22.2 | 36.1 | 12.5 |
출처: 논문 Table 4 발췌. 모든 행은 OcMotion 학습·평가 조건이다. GT Keypoints는 실제 detector 입력을 쓰지 않는 oracle 조건이다.
DWT는 DCT보다 세 위치 오차 지표가 낮지만 Accel은 18.8로 DCT의 17.6보다 높다. 즉 DWT가 모든 면에서 보편적으로 우월하다고 말할 수 없다. 반면 2D prior와 3D diffusion을 결합한 최종 구성은 비-oracle 행 가운데 네 지표가 모두 가장 낮다. GT keypoint 행과의 차이는 detector 관측 오류가 여전히 큰 여지를 남긴다는 것도 보여 준다.
논문은 2D prior pretraining 없이 predicted keypoint를 DWT한 뒤 3D diffusion을 학습하는 변형을 MotionWavelet과 비슷한 설정으로 설명한다. 따라서 결과가 말하는 핵심은 “DWT 하나를 붙이면 해결된다”가 아니다. 2D 관절의 관측 구조에서 먼저 잡음 제거 prior를 학습하고, 그 표현을 3D 복원에 넘기는 두 단계 설계가 중요하다는 주장이다.
이 표에는 coefficient map을 끈 행이나 reliable 관절 고정을 해제한 행이 없다. 따라서 Table 4만으로 그 두 요소의 독립적인 효과를 계산할 수는 없다. 어떤 계수가 실제 동작이고 어떤 계수가 오류인지 완벽하게 식별했다는 증명으로 읽어서도 안 된다.
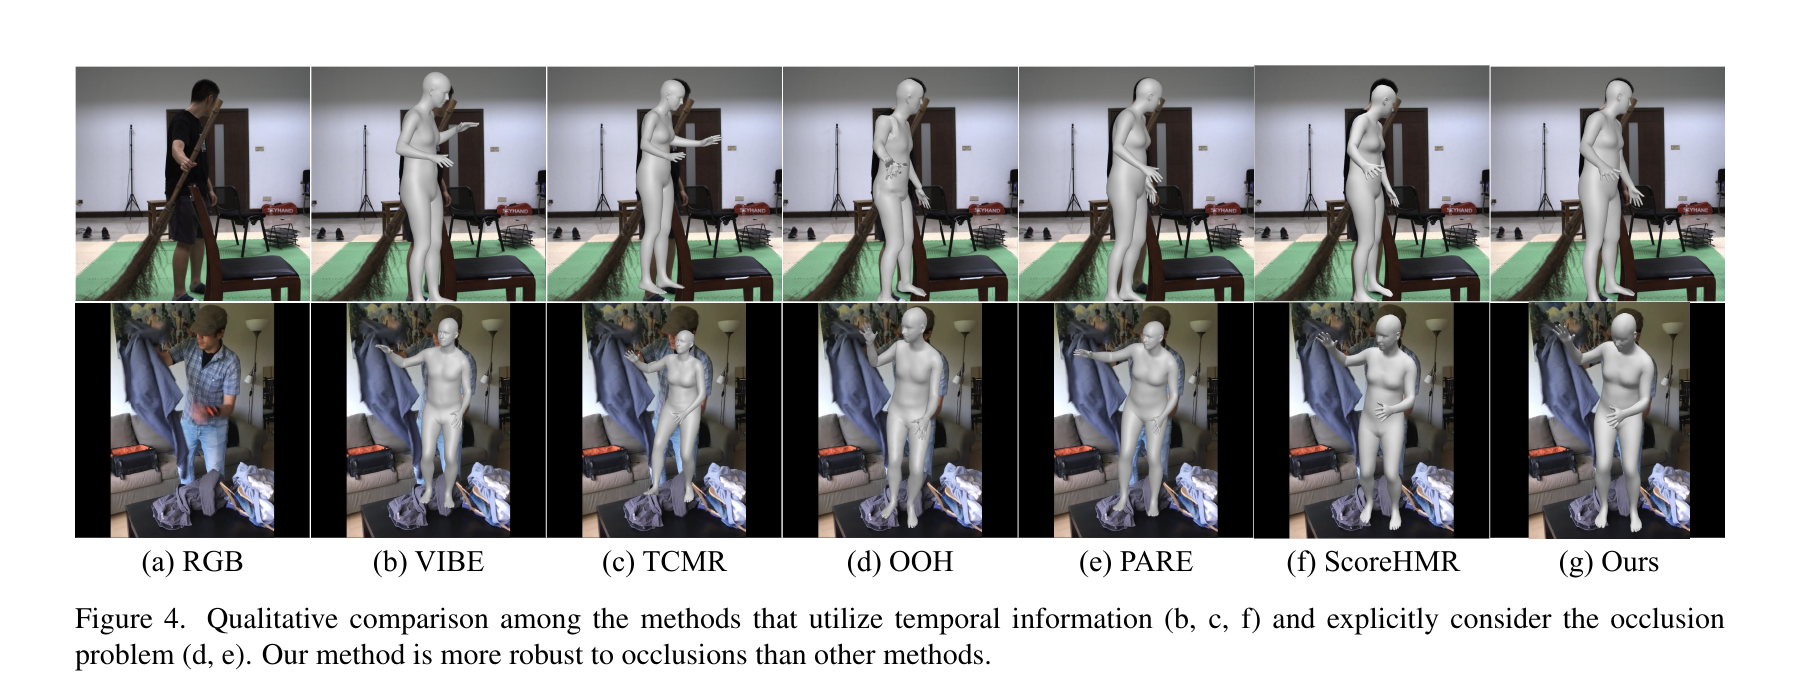 출처: 논문 Fig. 4. 두 장면에서 RGB 입력과 VIBE, TCMR, OOH, PARE, ScoreHMR, FFDP 결과를 비교한다. 선택된 두 사례는 방법의 차이를 보여 주지만 전체 데이터의 실패율을 뜻하지는 않는다. 이미지를 누르면 크게 볼 수 있다.
Part 6. 읽고 남은 가정과 질문
관절 배열의 이웃과 신체의 이웃
2D DWT의 두 번째 축은 펼친 관절 좌표다. 그러면 같은 뼈대를 다른 순서로 배열했을 때 계수가 달라진다. 배열에서 가까운 좌표가 해부학적으로 연결된 관절인지, $x$와 $y$가 어떤 순서로 놓이는지는 주파수 표현의 의미에 영향을 줄 수 있다.
본문과 보충자료에서는 joint-order ablation을 확인할 수 없었다. 이것은 논문이 실패했다는 결과가 아니라, 방법을 재현하고 해석하려면 남는 질문이다.
자신 있게 틀린 관절은 고정될 수 있다
reliable 관절을 확산 내내 유지하는 설계는 좋은 관측을 보호한다. 동시에 confidence가 높은 오검출에는 취약할 수 있다.
보충자료의 0.7 threshold ablation은 OcMotion에서 기준을 고르는 근거를 제공한다. 그러나 다른 detector와 장면에서도 confidence가 정확도를 잘 대표한다는 보장은 아니다. 가림 물체와 관절 모양이 비슷해 detector가 확신하는 경우를 따로 살펴볼 필요가 있다.
새로운 움직임과 깊이 모호성
motion prior는 관측이 사라진 구간을 메우는 데 강한 단서다. 그만큼 학습 분포에서 드문 불규칙한 동작을 익숙한 움직임 쪽으로 끌어갈 가능성도 생각해야 한다. 논문이 모든 새로운 동작에 일반화했다고 단정할 수는 없다.
또 2D 재투영이 맞는 3D 자세가 하나뿐인 것도 아니다. FFDP가 RGB ViT 특징과 3D supervision을 함께 사용하는 이유를 2D prior만으로 3D가 결정된다고 설명하면 안 된다.
공개 자료에서 멈추는 구현 세부
논문이 안내한 FreqMotion 코드 주소는 2026-09-08 확인 시 접근되지 않았다. 현재 공개된 본문과 보충자료만으로는 다음 값을 확정할 수 없다.
- wavelet family와 boundary mode
- 관절 수와 정확한 좌표 배열 순서
- coefficient map의 활성함수와 값의 범위
- DDIM의 선택 timestep과 세부 schedule
- Transformer의 깊이, 폭, head 수와 일부 freeze 범위
이는 공개 자료의 한계다.
pytorch_wavelets의 기본값이나 CHOMP 저장소의 설정을 FFDP의 구현값으로 대신 쓰면 안 된다.
내가 이 논문에서 중요하게 본 변화
처음에는 주파수 영역이라는 말 때문에 가림 오류를 고주파 잡음으로 보고 지우는 방법이라고 생각하기 쉬웠다. 작은 DWT 계산을 따라가고 나니 오히려 반대가 분명해졌다. 주파수 변환은 답을 정하지 않는다.
FFDP가 바꾼 것은 가려진 좌표를 다루는 학습 문제다. 한 점의 검출값을 정답처럼 믿는 대신 그 주변의 불확실한 좌표에서 시작하고, 보이는 관절은 조건으로 남긴다. 좌표를 부대역으로 펼친 뒤 다른 시간과 관절의 관계를 학습해 계수를 조절한다. 그리고 2D에서 배운 잡음 제거 표현을 고정해 3D decoder의 조건으로 사용한다.
이 연결을 보고 나서야 “웨이블릿 계수 선택 문제로 정식화한다”는 문장이 이해됐다. 가려진 관절을 직접 한 번에 맞히는 대신, 관측과 motion prior를 이용해 어떤 주파수 계수를 신뢰할지 배우는 문제로 바꾼 것이다.
다음 글에서는 이 설명을 실제 기호로 내린다. $P$, $P_t$, $P_0$가 각각 어떤 좌표인지, 36프레임과 diffusion timestep이 왜 다른지, DDIM이 현재 입력과 clean prediction을 어떻게 함께 쓰는지, 고정 DWT를 지나서도 어느 가중치까지 gradient가 흐르는지 계산한다.