CLIP 논문 리뷰 - 자연어로 이미지를 분류하다
해설글
작성 · 9분 읽기 · 조회수 —
들어가며
HEART LAB 세미나에서 발표한 논문이 어느새 다섯 편째다. SVM으로 고전 ML의 최적화 이론을 잡고, ResNet으로 깊은 신경망을, GCN으로 그래프를, BYOL로 라벨 없는 자기지도 학습을 거쳤다. 그리고 마지막으로 고른 논문이 CLIP이었다.
지금까지 본 논문들이 전부 “이미지 안에서만” 혹은 “그래프 안에서만” 노는 단일 모달 모델이었다면, CLIP은 처음으로 이미지와 텍스트라는 두 개의 다른 세계를 한 공간에 묶는 멀티모달 논문이다. 마지막 발표를 이걸로 마무리하고 싶었던 이유이기도 하다.
Learning Transferable Visual Models From Natural Language Supervision — Alec Radford, Jong Wook Kim, et al. (ICML/PMLR 2021)
처음 제목을 봤을 때 “자연어로 비전 모델을 학습한다고? 캡션 생성 같은 건가?” 싶었는데, 핵심은 전혀 달랐다. 이미지와 그에 달린 문장이 서로 짝인지 아닌지를 맞추도록 학습시키면, 그 모델이 한 번도 학습하지 않은 분류 작업을 자연어 프롬프트만으로 곧장 수행한다는 것이다. 발표 준비하며 정리한 흐름을 그대로 옮겨본다.
Why CLIP? — NLP는 되는데 비전은 왜 안 됐나
NLP에서는 이미 BERT, GPT-3처럼 대규모 텍스트를 사전학습한 뒤 다양한 작업에 전이하는 패러다임이 자리를 잡았다. 웹에서 긁어온 방대한 raw text만으로 사전학습하고, 작업별 라벨링은 거의 필요 없었다.
그런데 컴퓨터 비전은 그러지 못했다. 비전 모델은 여전히 ImageNet처럼 사람이 일일이 라벨링한 고정된 클래스 집합에 묶여 있었다. 1000개 클래스를 분류하려고 막대한 GPU 메모리를 쓰면서, 정작 학습한 1000개 밖으로는 나가지 못했다.
이 간극을 메우려는 시도가 두 갈래 있었는데, 둘 다 한계가 있었다.
| 접근 | 방식 | 한계 |
|---|---|---|
| Zero-shot Learning | 학습하지 않은 카테고리를 의미 정보로 추론 | 정확도가 매우 낮음 |
| Weak Supervised Learning | 웹의 해시태그/메타데이터를 약한 라벨로 활용 | 고정된 라벨 집합에 묶여 zero-shot 능력을 제한 |
저자들은 특히 두 번째, weak supervised learning이 어느 정도 성과를 냈지만 결국 미리 정해둔 라벨 공간에 갇혀 새로운 작업으로의 일반화를 막는다고 지적한다. 그래서 라벨이 아니라 자연어 그 자체를 supervision으로 쓰자는 게 CLIP의 출발점이다.
핵심 아이디어: 이미지-문장 쌍을 입력으로 받아 cross-modal(image-text) contrastive learning을 진행한다.
데이터셋 — WIT (WebImageText)
자연어를 supervision으로 쓰려면, 일단 이미지와 문장이 짝지어진 데이터가 어마어마하게 많아야 한다. 기존 비전 데이터셋은 이 목적에 맞지 않았다.
- MS-COCO, Visual Genome: 라벨 품질은 좋지만 양이 약 10만 개로 너무 적음
- YFCC100M: 1억 장으로 양은 많지만 메타데이터 품질이 들쑥날쑥 (양질의 캡션이 아님)
그래서 저자들은 인터넷에서 직접 수집한 4억 개의 (image, text) 쌍으로 구성된 새 데이터셋 WIT를 만들었다. 다양성을 위해 50만 개의 텍스트 쿼리를 쓰고, 한 쿼리당 2만 쌍을 넘지 않도록 제한했다. 다른 비전 연구가 쓰던 데이터(약 35억 인스타그램 사진 규모)에 견줄 만한 웹 스케일 코퍼스다.
효율적인 사전학습 방법 고르기
처음엔 VirTex처럼 이미지를 CNN으로 인코딩하고 그 캡션을 단어 순서까지 정확히 예측하는 방식을 시도했다. 그런데 이건 비효율적이었다. “이 이미지를 설명하는 정확한 문장”을 생성하는 건 너무 어려운 과제다.
저자들은 과제를 바꿨다. 문장을 토씨 하나까지 맞추는 대신, 어떤 이미지에 어떤 문장이 짝인지만 맞추도록 바꾼 것이다(bag-of-words + contrastive). 이 한 번의 전환으로 학습 효율이 크게 뛴다.
예측 과제를 “정확한 캡션 생성”에서 “올바른 쌍 매칭”으로 완화하자, 같은 연산량 대비 zero-shot ImageNet 정확도가 약 4배 효율적으로 올랐다.
모델 아키텍처 — Contrastive Pre-training
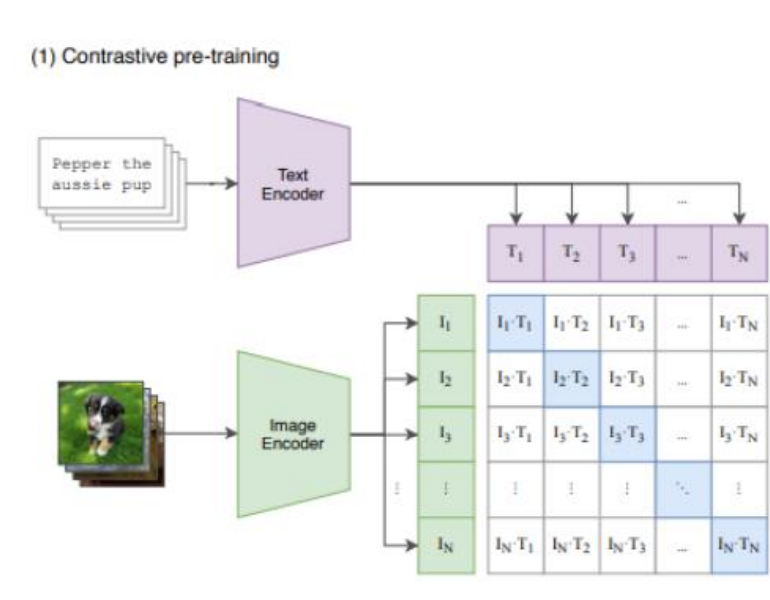
이제 CLIP의 본체다. 구조 자체는 의외로 단순하다. 이미지 인코더 하나, 텍스트 인코더 하나, 그리고 둘을 같은 공간에 정렬시키는 대조 손실.
두 개의 인코더
| 인코더 | 구성 | 표현 추출 |
|---|---|---|
| 이미지 인코더 $f_I$ | ResNet 계열(변형) 또는 ViT(패치 임베딩 + Transformer) | global pooling 또는 [CLS] 토큰 |
| 텍스트 인코더 $f_T$ | 토크나이저(BPE) + 위치 임베딩 + Transformer 블록 | 마지막 레이어 [CLS] 또는 평균 풀링 |
각 인코더 출력은 선형 프로젝션 헤드를 거쳐 같은 차원 $d$ 의 임베딩 공간으로 매핑되고, L2 정규화 후 코사인 유사도로 비교된다.
대조 학습의 동작
배치 크기를 $N$ 이라 하면, $N$ 개의 (image, text) 쌍이 들어온다. 두 인코더로 각각 임베딩을 뽑으면 $N \times N$ 의 유사도 행렬이 만들어진다.
- 이미지 임베딩 $I_i$ 와 텍스트 임베딩 $T_j$ 의 코사인 유사도를 전부 계산 → $N^2$ 개의 값
- 그중 대각 성분 $N$ 개가 실제 짝(positive pair)
- 나머지 $N^2 - N$ 개는 전부 짝이 아닌 것(negative pair)
한 배치 안에서 정답 쌍 하나만 positive, 같은 이미지에 대한 나머지 모든 텍스트(그리고 그 반대)는 전부 negative로 취급된다. 이게 in-batch negative다. 그래서 배치가 클수록 negative가 풍부해져 학습이 잘 된다 (CLIP은 배치 32,768을 썼다).
손실은 이미지→텍스트, 텍스트→이미지 양방향의 대칭적 cross-entropy(InfoNCE)다. 정규화된 유사도를 온도 $\tau$ 로 스케일링한 logits에 softmax를 씌운다. 의사코드로 보면 핵심은 단 몇 줄이다:
\[\text{logits} = \tau \cdot (I_e \cdot T_e^{\top}), \quad \mathcal{L} = \tfrac{1}{2}\big(\text{CE}(\text{logits},\, \text{labels})_{\text{row}} + \text{CE}(\text{logits},\, \text{labels})_{\text{col}}\big)\]여기서 정답 label은 그냥 $0, 1, \dots, N-1$ — 즉 대각선이다. “$i$ 번째 이미지의 정답은 $i$ 번째 텍스트” 라는 뜻이다.
모델 라인업과 학습 설정
| 항목 | 설정 |
|---|---|
| 이미지 인코더 | ResNet 5종(RN50 ~ RN50x64), ViT 3종(ViT-B/32, B/16, L/14) — 총 8개 |
| 옵티마이저 | Adam (가중치 감쇠 분리 → AdamW), 코사인 LR 스케줄 |
| 온도 $\tau$ | 0.07로 초기화, 안정성 위해 logits가 100을 넘지 않도록 클리핑 |
| 배치 | 초대형 미니배치 32,768, 총 32 에포크 |
이미지 인코더는 너비·깊이·해상도를 모두 키우며 확장했지만, 텍스트 인코더는 너비만 맞추고 깊이는 늘리지 않았다. CLIP 성능이 텍스트 인코더 크기에는 덜 민감하다는 걸 발견했기 때문이다.
Zero-shot 전이 — 텍스트 인코더가 분류기를 만든다
CLIP의 진짜 매력은 여기서 나온다. 사전학습이 끝난 CLIP은 추가 학습 없이 새로운 분류 작업을 바로 수행한다.
분류기를 자연어로 “조립”한다
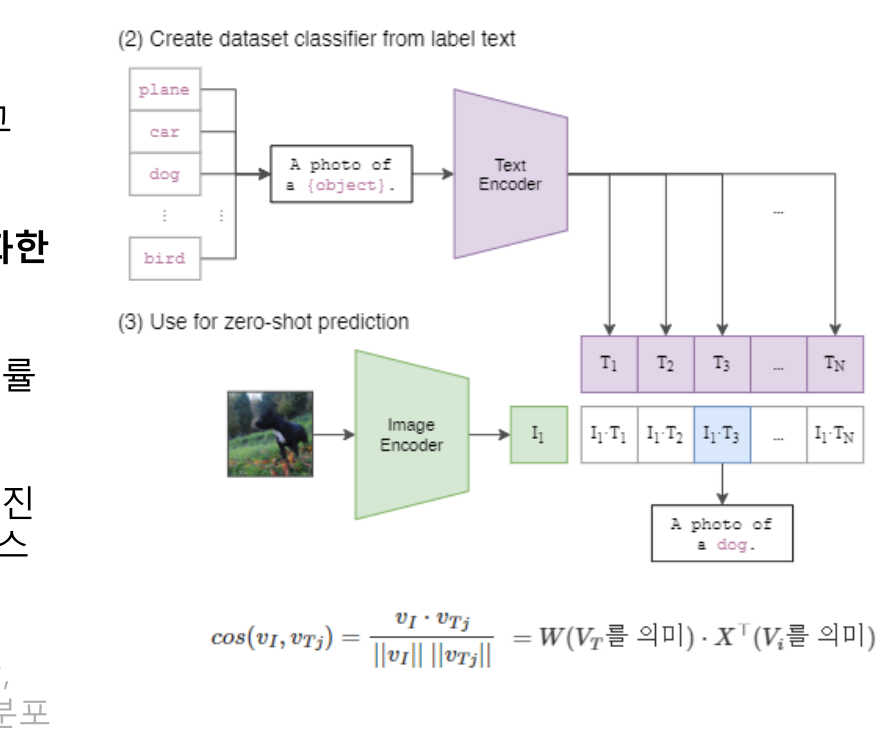
원리는 이렇다. 분류하고 싶은 클래스 이름들을 프롬프트 템플릿에 끼워 넣고, 텍스트 인코더로 임베딩한다.
- 클래스 이름 $y_j$ 를
"A photo of a {label}."같은 템플릿에 넣어 텍스트 임베딩 $t_j = f_T(\text{prompt}(y_j))$ 생성 - 이미지 $x$ 는 이미지 인코더로 $v_I = f_I(x)$, 둘 다 L2 정규화
- 코사인 유사도를 온도로 스케일링해 logits 계산, softmax로 확률화
여기서 결정적인 통찰. 이 계산은 bias 없는 선형 분류기 + softmax(=로지스틱 회귀) 와 정확히 같은 꼴이다. 텍스트 임베딩 행렬 $T$ 가 곧 분류기의 가중치 $W$ 역할을 한다.
\[s = \tau\, \tilde{v}_I\, T^{\top} \;=\; W \cdot X^{\top} \quad (W \leftarrow T,\; X \leftarrow v_I)\]즉 텍스트 인코더는 “클래스가 나타내는 시각 개념을 설명하는 텍스트로부터 선형 분류기의 가중치를 즉석에서 생성하는 하이퍼네트워크(hypernetwork)” 다. 새 작업이 와도 클래스 이름만 문장으로 적으면, 텍스트 인코더가 그 자리에서 분류기를 만들어낸다. 파라미터 업데이트가 전혀 없으니 zero-shot이다.
왜 학습 없이 동작하나
CLIP은 방대한 이미지-문장 쌍으로 이미지와 텍스트를 같은 의미 공간에 정렬해뒀다. 그래서 처음 보는 클래스라도 자연어로 서술하기만 하면, 그 텍스트 임베딩이 같은 공간에서 해당 이미지와 가까이 위치할 확률이 높다. 비유하자면 이미지와 텍스트를 같은 ‘언어’로 번역해둔 사전을 미리 만들어둔 셈이다.
Zero-shot의 확장된 의미
전통적인 zero-shot은 “개·고양이·사자·호랑이를 학습하고, 한 번도 안 본 얼룩말을 맞추기” 처럼 보지 못한 객체 카테고리에 대한 일반화였다. 그런데 CLIP은 이 의미를 한 단계 넓힌다.
CLIP의 zero-shot은 보지 못한 데이터셋(=작업, task) 자체에 대한 일반화다. 새로운 라벨을 맞추는 걸 넘어, 한 번도 접하지 않은 ‘문제’ 자체를 얼마나 잘 푸는지를 본다.
이건 NLP의 GPT-2가 zero-shot으로 언어 모델의 작업 학습 능력을 측정했던 것에서 영감을 받았다. 그래서 여기서 두 개념을 구분할 필요가 있다.
| 개념 | 의미 | CLIP에서 |
|---|---|---|
| Representation Learning | 데이터의 좋은 특징을 학습하는 데 초점 | 인코더가 뽑는 임베딩의 품질 |
| Task Learning | 작업 정의를 입력받아 즉시 분류기/정책을 구성하는 능력 | 작업 정의 = 자연어 프롬프트 → 텍스트 임베딩으로 분류기 생성 |
CLIP 논문은 zero-shot 전이를 task learning 능력의 측정 도구로 본다. 비지도 학습 연구가 주로 representation learning에 집중하는 것과 대비되는 지점이다.
프롬프트 엔지니어링 & 앙상블
클래스 이름만 텍스트 인코더에 넣으면 문제가 생긴다. 문맥이 없어 다의성(polysemy) 이 발생하기 때문이다.
- ImageNet의
crane→ 건설용 기중기인가, 날아다니는 학인가? - Oxford-IIIT Pet의
boxer→ 개 품종인가, 권투선수인가?
이걸 해소하려고 "A photo of a {label}." 템플릿을 기본값으로 쓰면, 텍스트가 이미지 내용에 관한 것임을 명시해준다. 이것만으로 ImageNet 정확도가 1.3% 오른다. 작업에 맞게 "A photo of a {label}, a type of pet." 처럼 맞춤화하면 더 오른다.
여기에 여러 문맥 프롬프트(a photo of a big {label}, a photo of a small {label} 등)로 만든 분류기를 앙상블하면 추가로 좋아진다. ImageNet에서 80개 프롬프트를 앙상블해 3.5% 더 올렸고, 프롬프트 엔지니어링 + 앙상블을 합치면 거의 5% 향상된다.
앙상블은 임베딩을 먼저 L2 정규화한 뒤 평균 내고 다시 정규화한다. 여러 프롬프트로 만든 텍스트 임베딩들을 클래스당 하나의 안정적인 프로토타입 벡터로 합치는 것이다.
실험 결과
Visual N-Grams와의 비교
이전의 대표적 zero-shot 비교 대상인 Visual N-Grams를 CLIP이 압도한다.
| aYahoo | ImageNet | SUN | |
|---|---|---|---|
| Visual N-Grams | 72.4 | 11.5 | 23.0 |
| CLIP | 98.4 | 76.2 | 58.5 |
특히 ImageNet에서 11.5% → 76.2%. 더 놀라운 건 이 결과가 ImageNet의 128만 개 크라우드소싱 라벨을 하나도 쓰지 않고 나왔다는 점이다. zero-shot만으로 원본 ResNet-50의 지도학습 성능과 맞먹는다. (단, 데이터·연산 규모 차이가 통제되지 않았으니 직접적 방법 비교로 보면 안 된다.)
Zero-shot CLIP vs Linear Probe ResNet-50
ResNet-50 특징 위에 완전 지도학습된 로지스틱 회귀를 올린 baseline과 27개 데이터셋에서 비교하면, zero-shot CLIP이 16개에서 baseline을 앞선다.
- 잘하는 곳: Stanford Cars, Food101(세분화 분류)에서 20%+ 우세. Kinetics700, UCF101(행동 인식)에서 크게 우세 — 자연어가 명사뿐 아니라 동사 관련 시각 개념까지 폭넓게 가르쳐주기 때문.
- 약한 곳: EuroSAT(위성), PatchCamelyon(종양 탐지), CLEVRCounts(객체 수 세기), GTSRB(자율주행 표지판) 같은 전문적·복잡한 작업에선 매우 약하다.
few-shot과 비교하면 더 직관적이다. zero-shot CLIP이 같은 특징 공간의 4-shot 선형 분류기 평균 성능과 일치한다. 자연어로 시각 개념을 직접 “전달”받기 때문에, 예제에서 간접적으로 개념을 추론해야 하는 지도학습보다 유리한 것이다.
프롬프트 엔지니어링의 효과
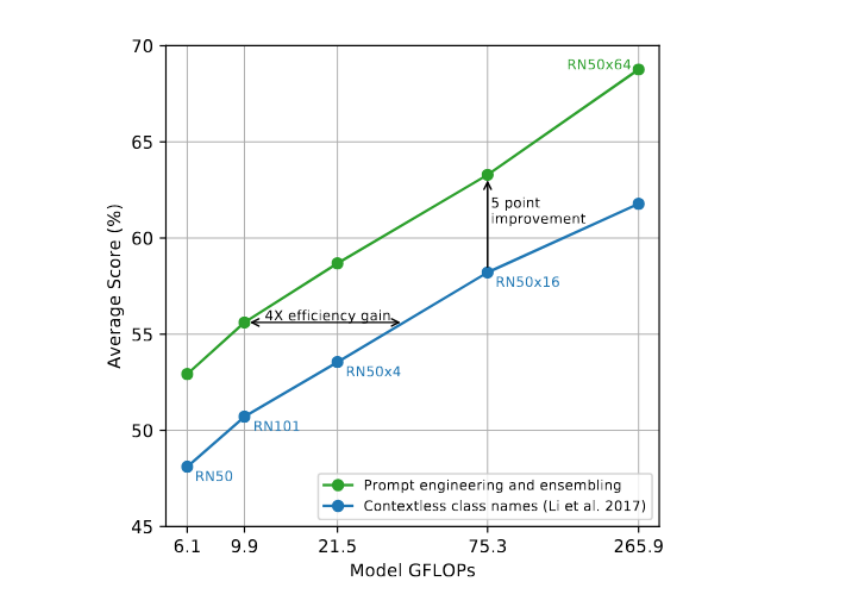
위 그래프에서 초록(프롬프트 엔지니어링+앙상블)이 파랑(문맥 없는 클래스 이름)을 모든 모델 규모에서 일관되게 앞선다. 같은 성능에 도달하는 데 약 4배 적은 연산으로 충분하고, 같은 모델에서 약 5포인트가 그냥 올라간다.
Representation Learning & Robustness
- 표현 학습(3.2): 인코더를 고정하고 그 위에 선형 분류기만 올려 평가하면, 가장 큰 CLIP 모델(RN50x64)이 기존 최고 모델(Noisy Student EfficientNet-L2)을 살짝 능가한다. CLIP ViT는 CLIP ResNet보다 연산 효율이 약 3배 높다. 최종 최고 모델은 고해상도로 미세조정한 ViT-L/14로 평균 2.6% 우세.
- 분포 변화 견고성(3.3): zero-shot CLIP은 특정 분포에만 유효한 허위 상관관계를 학습할 수 없으므로 실질적 견고성(effective robustness) 이 높다. ImageNet 정확도와 분포 변화 하 정확도의 격차를 최대 75%까지 줄인다. 반대로 ImageNet에 선형 분류기로 적응시키면 ImageNet 정확도는 9.2% 오르지만 분포 변화 하 정확도는 오히려 약간 떨어진다 — 향상이 ImageNet 분포 주변에만 집중된다는 뜻이다.
헷갈리기 쉬운 포인트
발표 준비하면서, 그리고 Q&A에서 막혔던 부분들을 정리해둔다.
1. “CLIP은 캡션을 생성하는 모델인가?”
아니다. 초기 시도는 캡션 예측이었지만 비효율적이라 버렸다. CLIP은 생성 모델이 아니라 이미지-텍스트 쌍이 맞는지 판별하는 대조 학습 모델이다. 생성은 후속 연구(DALL-E 등)의 몫이다.
2. “negative는 어디서 오나? 따로 샘플링하나?”
따로 안 한다. 배치 안의 다른 모든 쌍이 곧 negative다(in-batch negative). $N$ 개 쌍이면 각 이미지에 대해 정답 텍스트 1개 외 $N-1$ 개가 전부 negative다. 그래서 배치가 클수록 학습 신호가 풍부해진다.
3. “zero-shot인데 왜 텍스트 인코더는 계속 쓰나?”
zero-shot은 “학습이 전혀 없다”가 아니라 “대상 작업에 대한 추가 학습이 없다” 는 뜻이다. 인코더 자체는 사전학습으로 이미 고정돼 있고, 추론 시엔 텍스트로 분류기 가중치를 만들 뿐 파라미터 업데이트가 없다.
4. “텍스트 인코더가 분류기 가중치라는 게 무슨 말?”
코사인 유사도 + softmax 과정이 bias 없는 선형 분류기 + softmax와 수식적으로 동일하기 때문이다. 텍스트 임베딩 행렬 $T$ 가 가중치 $W$ 자리에 그대로 들어간다. 그래서 텍스트 인코더를 분류기를 생성하는 하이퍼네트워크라고 부른다.
5. “CLIP의 zero-shot이 기존 zero-shot이랑 같은 건가?”
범위가 다르다. 기존은 보지 못한 카테고리, CLIP은 보지 못한 데이터셋/작업 전체에 대한 일반화다. CLIP은 zero-shot을 representation의 품질이 아니라 task learning 능력의 측정 도구로 본다.
정리하며
CLIP의 핵심은 한 줄로 압축된다.
이미지-텍스트 쌍을 대조 학습으로 같은 공간에 정렬해두면, 자연어 프롬프트만으로 처음 보는 분류 작업의 분류기를 즉석에서 만들어 zero-shot으로 풀 수 있다.
전체 흐름은 이렇게 흘러간다:
자연어 supervision → 4억 쌍 대조 학습(positive=대각, negative=나머지) → 같은 의미 공간 정렬 → 텍스트 인코더로 분류기 생성 → Zero-shot 전이
다섯 편의 세미나를 SVM의 최적화 이론으로 시작해 CLIP의 멀티모달 정렬로 마친 셈인데, 돌아보면 한 줄기로 이어진다. SVM이 “마진을 최대화해 좋은 결정 경계를 찾는” 이야기였다면, CLIP은 “좋은 표현 공간을 먼저 만들면, 결정 경계(분류기)는 자연어로 그 자리에서 그려진다“는 이야기다. 모델이 점점 라벨에서 자유로워지는 흐름을 마지막 논문에서 가장 선명하게 본 것 같아, 마무리로 잘 골랐다는 생각이 든다.
참고
- Radford, A., et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML.
- 본 글의 발표 슬라이드: lab-seminar-2025 / 05_CLIP.pdf
« BYOL 논문 리뷰 - 네거티브 샘플 없이 표현을 학습하다
TabPFN 논문 리뷰 - 학습 없이 1초 만에 테이블 데이터를 분류하다 »