ResNet 논문 리뷰 - 잔차 학습으로 심층 신경망을 살리다
해설글
작성 · 9분 읽기 · 조회수 —
들어가며
학부연구생으로 들어간 첫 학기에 랩 세미나에서 발표했던 두 번째 논문이 ResNet이었다. 직전에 SVM을 발표하면서 고전적인 ML에서 딥러닝으로 넘어왔고, 이제 본격적으로 심층 신경망을 다뤄보는 첫 논문이었다. 처음에는 심층 모델은 무조건 좋은 거 아닌가? 라는 막연한 인식이 있었는데, ResNet 논문을 읽으면서 그 인식이 깨졌다. 단순히 층만 쌓으면 오히려 성능이 나빠진다. 그걸 어떻게 해결했는지가 ResNet의 핵심이다.
발표 자료 만들면서 정리했던 흐름을 그대로 블로그에 옮겨본다.
Deep Residual Learning for Image Recognition — Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun (CVPR 2016)
Why ResNet? — 심층 신경망이 왜 필요했나
깊게 쌓는 이유
먼저 “왜 깊게 쌓아야 하는가”부터 짚고 가야 한다. 깊은 신경망은 두 가지 이점이 있다:
- 계층적 표현(Hierarchical representation) — 저층은 점·선·면 같은 저수준 특징을, 심층은 눈·얼굴·표정 같은 고수준 특징을 학습한다
- 비선형 활성화 함수의 누적 — 층이 깊을수록 ReLU 같은 비선형성이 여러 번 합성되어 더 복잡한 결정 경계를 만들 수 있다
깊게 쌓을 때의 벽
문제는 깊게 쌓으려고 하면 Vanishing/Exploding Gradient가 발생한다는 것이다. 역전파 과정에서 기울기가 0으로 수렴하거나 지수적으로 폭발해서 학습 자체가 불가능해진다.
이전 모델들의 흐름
한 줄 요약
ResNet 직전까지의 CNN 발전사를 한 줄로 정리하면 이렇다:
LeNet → AlexNet → VGGNet → BN & He init → (그래도 안 됨)
각 모델의 기여
| 모델 | 핵심 기여 |
|---|---|
| LeNet | 합성곱 연산으로 이미지 분석에 새로운 접근을 열었다 |
| AlexNet | sigmoid 대신 ReLU를 도입해 치역이 $(0, 1)$에서 $(0, \infty)$로 바뀌어 Vanishing Gradient를 완화. Local Response Normalization도 함께 도입 |
| VGGNet | 필터를 전부 3×3으로 통일하고 “depth matters”를 실험적으로 증명. 7×7 한 번 대신 3×3 세 번이 파라미터 수도 적고($49$ vs $27$) ReLU도 더 많이 쓸 수 있다 |
| BN & He init | BN은 입력 분포를 정규화해 Exploding Gradient를 완화하고, He init은 ReLU에 맞춘 가중치 초기화로 깊은 네트워크에서도 활성화 분포가 균일해진다 |
그래도 남은 문제
이렇게까지 했는데도 30층, 50층 이상으로 가면 새로운 문제가 등장한다. Vanishing/Exploding Gradient는 어느 정도 해결됐는데, 그것과는 다른 종류의 문제다.
Degradation Problem — “왜 더 깊은데 더 못해?”
실험에서 발견된 현상
이 부분이 논문의 가장 중요한 출발점이다. 저자들이 실험에서 발견한 현상은 이렇다:
- 56층 네트워크가 20층 네트워크보다 training error도 더 높고, test error도 더 높았다
- 이건
과적합(overfitting)이 아니다. 과적합이면 training error는 낮은데 test error만 높아야 한다. training error부터 높다는 건 모델이 그냥 학습 자체를 못 하는 거다
논문의 핵심 주장
논문에서 정확하게 말한 부분은 이거다:
“There exists a solution by construction to the deeper model: the added layers are identity mapping, and the other layers are copied from the learned shallower model. The existence of this constructed solution indicates that a deeper model should produce no higher training error than its shallower counterpart.”
이 문장을 처음 봤을 때 정확히 무슨 말인지 한참 헤맸다. 풀어서 해석하면 이런 의미다:
얕은 네트워크에 새 층을 추가해서 깊게 만들었다고 하자. 그 추가된 층이 만약 $y = x$ (항등 매핑) 이라면, 깊은 모델은 얕은 모델과 정확히 같은 출력을 낸다. 즉 이론적으로는 깊은 모델이 얕은 모델보다 못할 이유가 없다. 그런데 실제로는 더 못한다. 결론: 옵티마이저가 그 해(solution)를 못 찾고 있다.
그러니까 Degradation은 표현력의 문제가 아니라 최적화의 문제라는 게 저자들의 주장이다.
옵티마이저를 바꾸면 안 되나?
여기서 나는 의문이 하나 들었다. “그러면 SGD 말고 Adam을 쓰면 되는 거 아닌가?” — 알아보니 그렇지 않았다. Adam은 초반 수렴은 빠르지만 일반화 성능에서 SGD가 더 낫다는 게 잘 알려진 사실이다. 실제로 2017년 논문 “Improving Generalization Performance by Switching from Adam to SGD” 에서는 초기엔 Adam, 후반엔 SGD로 갈아타는 방식을 제안한다.
What is ResNet? — 가설과 잔차 학습
항등 매핑이 어려운 이유
그러면 옵티마이저가 항등 매핑을 못 찾는 이유는 뭘까?
일반적인 conv-relu 층 $\text{ReLU}(Wx + b)$로는 $y = x$를 표현하기가 어렵다. ReLU는 음수를 다 0으로 잘라버리기 때문에 입력의 음수 성분이 절대적으로 사라진다. 가중치 초기화만으로는 $y = x$를 정확히 재현할 수 없다.
잔차 학습 아이디어
저자들의 아이디어는 단순하다 — 항등 매핑을 구조적으로 강제하자. 그 결과가 잔차 학습(Residual Learning)이다:
\[H(x) = F(x) + x\]층이 학습해야 하는 건 출력 $H(x)$ 그 자체가 아니라, 입력 대비 잔차 $F(x) = H(x) - x$ 이다. 만약 항등 매핑이 최적이면 $F(x)$를 0으로 만들기만 하면 된다 — 가중치를 0에 가깝게 학습하면 되니까, 이게 훨씬 쉬운 최적화 문제다.
Residual Structure — 식과 그림
잔차 블록의 수식
수식으로 풀어보면 (편의상 bias는 생략):
\[F(x) = W_2 \cdot \text{ReLU}(W_1 x)\] \[H(x) = \text{ReLU}(F(x, W_i) + x)\]입력과 출력의 차원이 다르면 $x$ 쪽에 선형 사영 $W_s$를 곱해서 차원을 맞춰준다:
\[H(x) = \text{ReLU}(F(x, W_i) + W_s x)\]이 식은 FCL 기준으로 적었지만 conv 층에도 그대로 적용된다.
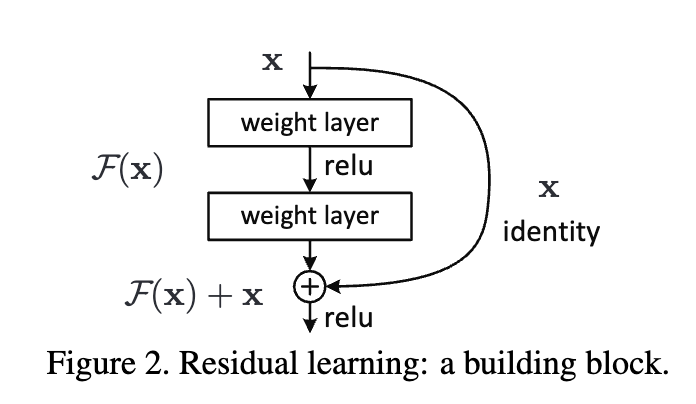
마지막 ReLU는 항등 매핑을 깨지 않나?
여기서 한 가지 의문점이 들었다. 마지막에 ReLU를 또 씌우면 항등 매핑이 깨지지 않나? 맞는 지적이다. 논문 초반 가설이 “추가된 층이 $y = x$라면 성능 저하가 없다”인데, $\text{ReLU}(z_2 + x)$로는 best case인 $y = x$를 정확히 표현할 수 없다.
이 약점은 후속 논문 “Identity Mappings in Deep Residual Networks” (2016)에서 지적되었고, 거기서는 구조를 바꿔서 해결한다:
\[y = \text{ReLU}(\mathcal{F}(x) + x) \;\;\to\;\; y = x + \mathcal{F}(\text{BN}(\text{ReLU}(x)))\]발표 때 받았던 질문 중 하나가 이 부분이었는데, 후속 논문까지 같이 봐두는 게 좋다.
Residual Block — Basic vs Bottleneck
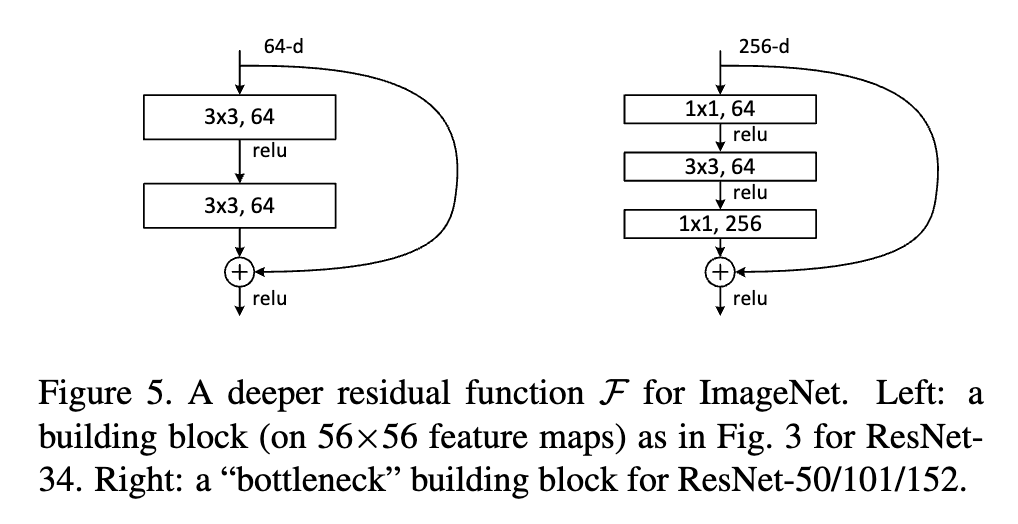
블록은 두 가지 종류가 있다:
Basic block (ResNet-18, 34)
\[z_1 = \text{ReLU}(\text{Conv}_1 x)\] \[z_2 = \text{ReLU}(\text{BN}_2 \text{Conv}_2(z_1))\] \[y = \text{ReLU}(z_2 + x)\]Bottleneck block (ResNet-50, 101, 152)
$1 \times 1$ conv로 채널을 줄였다가, $3 \times 3$ conv를 한 다음, 다시 $1 \times 1$ conv로 채널을 늘리는 구조. 파라미터를 줄이면서도 표현력을 유지하기 위한 트릭이다.
Network Architectures — 왜 첫 층이 7×7인가
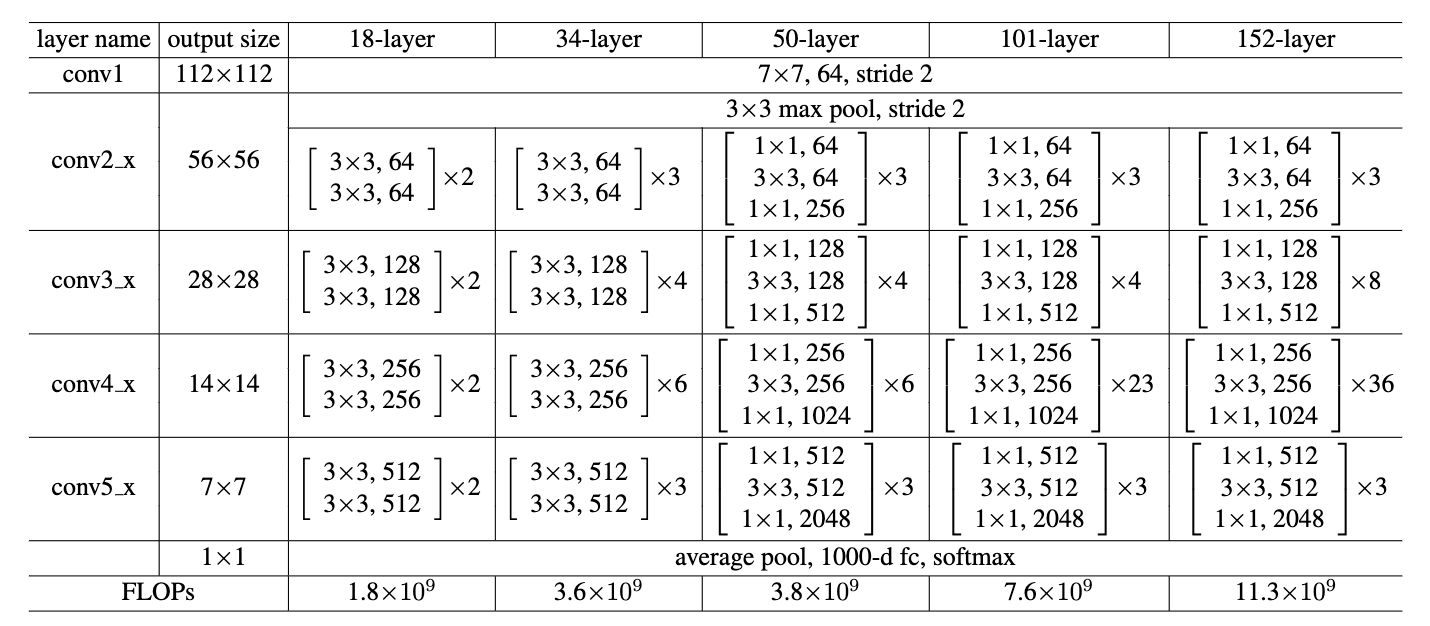
ResNet은 18, 34, 50, 101, 152층 버전이 있다. 모든 버전이 공통적으로 첫 번째 conv 층만 7×7이고 나머지는 다 3×3이다. 처음에는 이게 이상했다. VGGNet에서 3×3이 더 효율적이라고 했는데 왜 첫 층만 7×7로 쓸까?
세 가지 이유가 있다.
1. 짝수 커널의 구조적 문제 회피
7은 홀수다. 6×6이나 8×8 같은 짝수 커널은 연산의 중심점이 모호해서 공간 정보가 왜곡될 수 있다. 홀수 커널은 명확한 중심점이 있어 대칭적인 연산이 가능하고, Same Padding 시 패딩 개수가 소수점 없이 깔끔하게 계산된다.
2. 넓은 수용 영역(Receptive Field) 확보
7×7은 3×3보다 한 번에 훨씬 넓은 영역을 본다. 네트워크 초기 단계에서 이미지의 전반적인 형태·질감·색상 분포 같은 일반적인 맥락을 잡아야 과적합도 막을 수 있다. 9×9, 11×11은 파라미터 대비 성능 증가가 미미하고, 5×5는 영역이 좁아서 7×7이 절충점이다.
3. 첫 conv 연산의 파라미터 효율
이게 가장 결정적이다. RGB 입력은 $224 \times 224 \times 3$이라 채널이 3개뿐이다. 첫 conv의 파라미터 수는 $7 \times 7 \times 3 \times 64 = 9408$로 적다. 반면 만약 중간 층에서 같은 7×7을 쓴다면 입력 채널이 64라서 $7 \times 7 \times 64 \times 64 = 200704$ 개가 된다 — 약 21배 차이. 첫 층은 채널이 적기 때문에 큰 필터를 부담 없이 쓸 수 있는 거다.
| 위치 | 입력 채널 | 파라미터 수 |
|---|---|---|
| 첫 conv (7×7) | 3 | $7 \times 7 \times 3 \times 64 = 9408$ |
| 중간 conv (7×7 가정) | 64 | $7 \times 7 \times 64 \times 64 = 200704$ |
Down Sizing — Shortcut의 세 가지 옵션
Residual block에서 입력과 출력의 차원이 다르면(특히 다운샘플링 시) shortcut $x$의 차원을 어떻게 맞출지 결정해야 한다. 논문은 세 가지 옵션을 비교한다:
| 항목 | A | B | C |
|---|---|---|---|
| Shortcut conv | X | 다운사이징 시 1×1 | 항상 1×1 |
| 공간 축소 방법 | stride=2 Avg Pool 또는 subsample | 1×1 Conv with stride=2 | 1×1 Conv with stride=2 |
| 추가 파라미터 | 없음 | 다운사이징 projection에서만 | 모든 블록에서 |
| 계산량 | 매우 작음 | 적절 | 매우 큼 |
| 성능 | 실용적, 손해 있음 | 정확함, 효율 균형 | 약간 더 나음, 효율 떨어짐 |
논문에서는 B를 기본으로 채택했다. 50층 이상의 깊은 네트워크에서는 B 옵션이 사용된다.
Avg Pooling + 1000-FCL + Softmax
마지막 단계는 다음과 같다:
- 마지막 feature map $7 \times 7 \times 2048$에 Average Pooling을 수행하면 각 채널의 전체 평균값 1개만 남는다 → $1 \times 1 \times 2048$
- Edge나 pattern을 추출하기 위한 Max Pooling보다, 일반화 성능을 위해 Avg Pooling을 사용한다
- Flatten 없이도 공간 축소와 채널 유지가 한 번에 된다
- $2048$ → $1000$ (ImageNet 클래스 수) FCL → Softmax로 확률값 출력
Implementation 세부 사항
논문에서 명시한 학습 설정:
- 짧은 변을 $(256, 480)$ 사이 무작위 크기로 리사이즈 (aspect ratio 유지)
- $224 \times 224$로 crop, 좌우 반전, 평균값 제거
- 모든 conv 이후 BN 수행
- He 초기화로 conv 필터 초기화
- 옵티마이저는 SGD (Adam이 아님 — 일반화 성능 때문)
실험 결과 — Plain vs ResNet
핵심 그래프
논문의 핵심 실험 그래프다:
Plain Network 쪽 (왼쪽 가설): plain-34가 plain-18보다 training error도 test error도 더 높다. Degradation 현상이 명확히 관찰된다.
ResNet 쪽 (오른쪽 가설): ResNet-34가 ResNet-18보다 두 error 모두 더 낮다. 잔차 학습 도입만으로 깊이의 이점이 살아난다.
ImageNet 분류 결과 (top-5 error)
| 모델 | top-5 error |
|---|---|
| VGG-16 | 9.33% |
| GoogLeNet | 9.15% |
| plain-34 | 10.02% |
| ResNet-34 B | 7.46% |
| ResNet-50 | 6.71% |
| ResNet-101 | 6.05% |
| ResNet-152 | 5.71% ← VGG-16보다 8배 깊지만 복잡도는 더 낮음 |
152층이 1위인데 VGG-16(16층)보다 더 가벼운 모델이라는 게 진짜 인상적이다.
헷갈리기 쉬운 포인트
발표 준비하면서, 그리고 발표 후 Q&A에서 헷갈렸던 부분들을 정리해둔다.
1. “Vanishing Gradient랑 Degradation이 같은 거 아닌가?”
다르다. Vanishing/Exploding은 기울기가 0으로 수렴하거나 폭발해서 학습 자체가 안 되는 문제다. BN과 He init으로 어느 정도 해결됐다. Degradation은 그것과는 별개로, 학습은 되는데 깊을수록 더 못하는 현상이다. ResNet이 해결한 건 후자다.
2. “Degradation이 과적합 아니라는 걸 어떻게 확신해?”
과적합이면 training error가 낮아야 한다. 그런데 plain-56은 training error부터 plain-20보다 높다. 모델이 학습 데이터조차 제대로 못 외운다는 뜻이라 과적합이 아니다.
3. “$y = x + F(x)$에서 마지막 ReLU 때문에 진짜 $y = x$가 안 되는데, 그래도 효과가 있는 이유는?”
ReLU($z + x$)는 $y = x$를 정확히 표현하지는 못하지만, $F(x)$를 0에 가깝게 학습하면 $y \approx \text{ReLU}(x)$ ≈ $x$ (음수 성분 제외) 정도는 된다. 완벽한 항등은 아니지만, 일반 conv-relu보다는 항등 매핑에 훨씬 가깝게 갈 수 있다. 후속 논문에서 완벽한 항등 매핑 구조로 개선했다.
4. “Bottleneck block은 왜 깊은 모델에서만 쓰나?”
파라미터 수와 계산량의 trade-off다. ResNet-50 이상은 층 수가 많아 모든 블록을 basic으로 쓰면 파라미터가 폭발한다. 1×1 conv로 채널을 일시적으로 줄여서 3×3 연산의 비용을 낮추고 다시 복원하는 게 bottleneck의 아이디어다. ResNet-18, 34는 깊이가 적당해서 basic block으로 충분하다.
5. “ResNet은 왜 첫 conv에서만 stride=2를 쓰고 maxpool도 또 쓰지?”
$7 \times 7$ stride=2 conv 한 번으로 $224 \to 112$, $3 \times 3$ maxpool stride=2로 $112 \to 56$. 즉 두 단계로 빠르게 다운샘플링을 한다. 입력 해상도가 워낙 크니까 초반에 빠르게 줄여서 이후 연산량을 감당 가능하게 만든 것이다.
정리하며
ResNet의 핵심 통찰은 한 줄로 정리된다 — “깊은 신경망에서 학습이 안 되는 게 표현력 부족 때문이 아니라 최적화 실패 때문이라면, 항등 매핑을 구조적으로 보장해주자.”
이걸 $H(x) = F(x) + x$라는 단순한 식 하나로 구현했고, 결과적으로 152층까지 학습이 가능해졌다. 그리고 이 아이디어는 단순히 이미지 분류에 그치지 않고, 잔차 학습 원리 자체가 다른 심층 모델(객체 탐지, 분할, NLP의 Transformer 등)에도 일반적인 학습 구조로 적용되는 길을 열었다.
지금 내가 보는 ST-GCN의 backbone 안에도 결국 residual connection이 들어가 있다. 모든 깊은 신경망의 근간이 된 논문이라는 말이 과장이 아니다.
참고
- He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep Residual Learning for Image Recognition. CVPR.
- He, K., et al. (2016). Identity Mappings in Deep Residual Networks. ECCV. — 후속 논문, ReLU 위치 개선
- Keskar, N. S., & Socher, R. (2017). Improving Generalization Performance by Switching from Adam to SGD. — 옵티마이저 선택의 근거
- 본 글의 발표 슬라이드: lab-seminar-2025 / 02_ResNet.pdf
« SVM 논문 리뷰 - 마진을 최대화해서 최적의 분류기를 찾다
GCN 논문 리뷰 - 그래프에 합성곱을 가져오다 »