GCN 논문 리뷰 - 그래프에 합성곱을 가져오다
해설글
작성 · 10분 읽기 · 조회수 —
들어가며
HEART Lab 세미나에서 SVM, ResNet에 이어 세 번째로 발표한 논문이 GCN이다. 앞의 두 논문이 각각 고전 ML의 최적화 이론과 CNN의 깊이 문제를 다뤘다면, 이번엔 처음으로 그래프 구조 데이터를 정면으로 다루는 논문이었다.
이미지나 문장은 격자(grid)나 시퀀스라서 합성곱·순환 구조가 자연스럽게 들어맞는다. 그런데 소셜 네트워크, 논문 인용 관계, 지식 그래프처럼 노드와 엣지로만 정의되는 데이터는 정해진 순서도, 일정한 이웃 수도 없다. 여기에 어떻게 “합성곱”을 정의할 것인가 — 이게 GCN이 푼 문제다.
Semi-Supervised Classification with Graph Convolutional Networks — Thomas N. Kipf, Max Welling (ICLR 2017)
막상 발표를 준비하니 스펙트럴 그래프 이론, 그래프 라플라시안, 푸리에 변환 같은 낯선 수학이 줄줄이 나와서 그냥 이웃 노드 평균 내는 거 아닌가 했던 첫인상이 완전히 깨졌다. 결국 GCN의 그 간결한 한 줄짜리 전파 규칙이 어떻게 스펙트럴 합성곱의 1차 근사에서 유도되는지를 따라가는 게 이 글의 목표다.
그래프 구조 데이터와 준지도 학습
그래프란 무엇인가
그래프는 노드(node)와 그 사이의 관계(edge)로 표현되는 데이터다. 보통 $G = (V, E)$ 로 쓰고, $V$ 는 정점(vertex/node), $E$ 는 간선(edge/link)을 의미한다. 소셜 네트워크, 3D 메시, 뇌 신경망처럼 “순서가 없는 관계”를 다룰 때 등장한다.
이 논문이 다루는 핵심 과제는 그래프 내 노드 분류(node classification) 다. 그래프 안의 노드(문서나 논문)에 라벨을 붙이는 문제인데, 전체 노드 중 일부에만 라벨이 주어진 상황을 가정한다.
왜 준지도 학습인가
준지도 학습(semi-supervised learning)은 약간의 라벨된 데이터와 대량의 라벨 없는 데이터를 함께 사용해 모델을 학습하는 방식이다. 이게 가능한 이유는 그래프에 깔린 두 가지 가정 때문이다.
| 가정 | 내용 |
|---|---|
| 평활도 가정 (Smoothness) | 엣지로 연결되었거나 가까운 노드는 비슷한 라벨을 가질 가능성이 높다 |
| 군집 가정 (Cluster) | 데이터가 자연스럽게 군집을 이루면, 같은 군집의 노드는 같은 라벨을 가진다 |
예를 들어 논문 인용 그래프에서 20개 정도의 노드에만 주제 라벨을 주고, 이웃 정보를 전파해 나머지 논문의 주제까지 예측하는 식이다.
기존 방식의 한계 — 그래프 라플라시안 정규화
전통적으로는 손실 함수에 그래프 라플라시안 정규화 항을 더해서 라벨 정보를 그래프 전체로 퍼뜨렸다.
\[\mathcal{L} = \mathcal{L}_0 + \lambda \mathcal{L}_{reg}\] \[\mathcal{L}_{reg} = \sum_{i,j} A_{ij} \lVert f(X_i) - f(X_j) \rVert^2 = f(X)^\top \Delta f(X)\]이 정규화 항은 “연결된 노드는 같은 라벨을 가진다”는 평활도 가정을 직접 강제한다.
문제는 이 가정이 너무 강해서 모델링 능력을 제한한다는 점이다. 그래서 GCN은 명시적 정규화 항을 빼는 대신, 신경망 $f(X, A)$ 가 인접 행렬 $A$ 에 직접 의존하도록 만든다. 그러면 지도 학습 손실의 그래디언트가 그래프 구조를 타고 흘러, 라벨이 있는 노드와 없는 노드의 표현까지 함께 학습된다.
이 논문의 두 가지 기여는 이렇게 정리된다.
- 스펙트럴 그래프 합성곱의 1차 근사로부터, 그래프에 직접 작용하는 간단하고 안정적인 계층별 전파 규칙을 유도한다.
- 이 형태의 모델이 노드의 빠르고 확장 가능한 준지도 분류에 쓰일 수 있음을 보인다.
그래프 위의 합성곱은 어떻게 정의되나
이미지에서 합성곱은 “근처 픽셀에 필터를 곱해 더한다”로 정의된다. 그런데 그래프는 이웃 수가 노드마다 다르고 순서도 없다. 그래서 GCN은 푸리에 영역(스펙트럴 도메인) 으로 우회한다.
인접 행렬과 차수 행렬
먼저 그래프를 행렬로 표현해야 한다.
- 인접 행렬 $A$: 노드 $i$ 와 $j$ 가 연결되어 있으면 $A_{ij} = 1$, 아니면 $0$. $n$ 개 노드면 $n \times n$ 크기다.
- 차수 행렬 $D$: 각 노드가 몇 개의 이웃과 연결됐는지를 대각선에 적은 행렬. $D_{ii} = \sum_j A_{ij}$ 이고 비대각 원소는 $0$.
예를 들어 (1)-(2)-(3) 으로 이어진 그래프라면:
\[A = \begin{bmatrix} 0 & 1 & 0 \\ 1 & 0 & 1 \\ 0 & 1 & 0 \end{bmatrix}, \quad D = \begin{bmatrix} 1 & 0 & 0 \\ 0 & 2 & 0 \\ 0 & 0 & 1 \end{bmatrix}\]그래프 라플라시안 — 진동의 정도
그래프 라플라시안(graph Laplacian)은 “연결된 노드들이 비슷한 값을 갖게 하려는 힘”을 표현하는 행렬이다.
\[\text{비정규화: } L = D - A, \qquad \text{대칭 정규화: } L_{sym} = I_N - D^{-\frac{1}{2}} A D^{-\frac{1}{2}}\]비정규화 라플라시안은 차수에서 연결 구조를 빼서, 각 노드가 자기 주위와 얼마나 달라지는지를 계산한다. 노드 $i$ 의 값과 그 이웃 값의 차이가 클수록 $f^\top L f$ 가 커진다 — 즉 진동(oscillation)이 크다는 뜻이다.
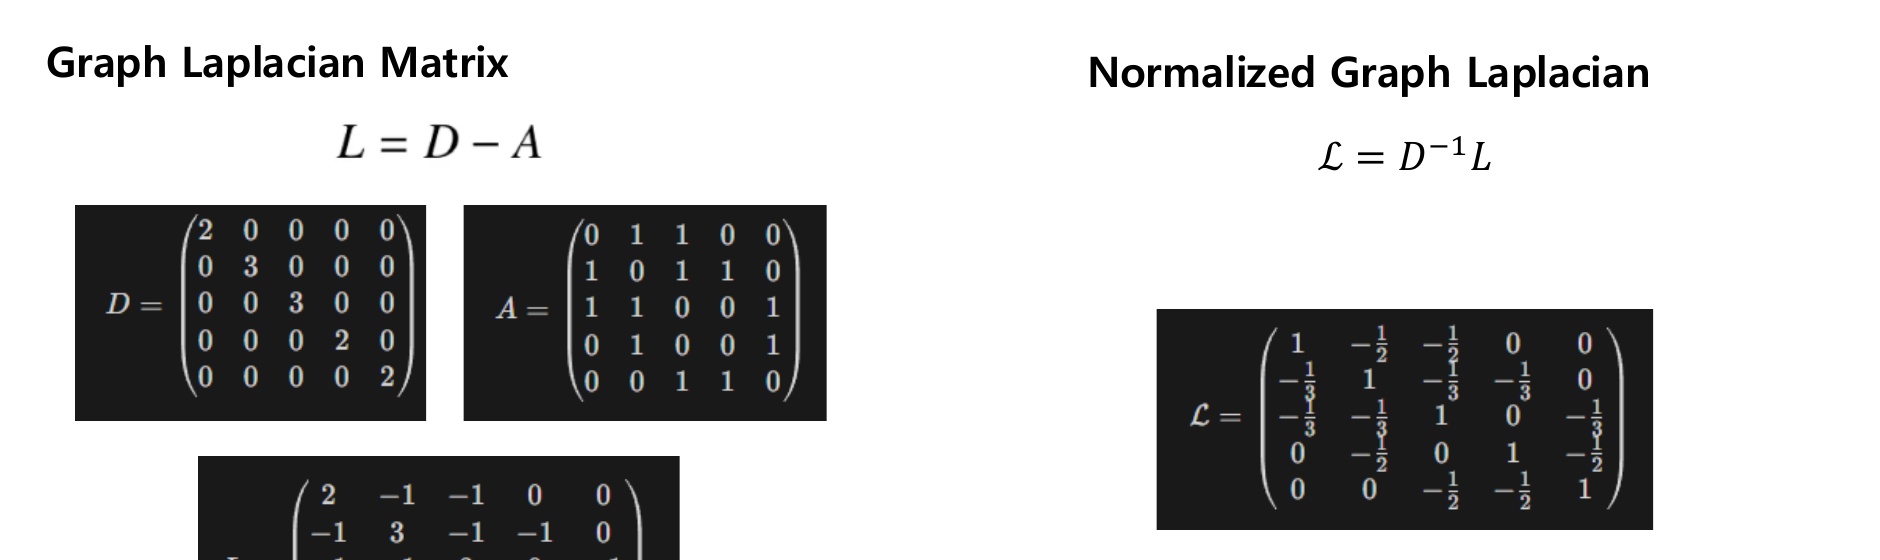
대칭 정규화를 쓰는 이유는 노드 차수가 크게 다를 때 발생하는 문제 때문이다. 차수가 큰 노드는 곱셈에서 과대 반응하고, 작은 노드는 과소 반응한다. 그래서 행·열을 동시에 $\sqrt{\text{차수}}$ 로 보정해 노드 차수의 차를 동등하게 맞춘다.
대칭 정규화 라플라시안 $L_{sym} = I_N - D^{-\frac{1}{2}} A D^{-\frac{1}{2}}$ 은 대칭 행렬이라 고유벡터가 직교($U^\top U = I$)하고, 고유분해 $U \Lambda U^\top$ 가 깔끔하게 된다. 이 성질이 뒤에 나올 그래프 푸리에 변환의 토대가 된다.
고유분해와 그래프 푸리에 변환
라플라시안을 고유분해(eigen-decomposition) 하면 그래프의 진동을 주파수별로 분해할 수 있다.
\[L = U \Lambda U^\top\]- $U = [u_1, u_2, \dots, u_n]$: 고유벡터 집합 = 그래프 푸리에 기저(graph Fourier basis)
- $\Lambda = \text{diag}(\lambda_1, \dots, \lambda_n)$: 고유값 = 그래프 주파수의 세기
각 고유벡터 $u$ 는 하나의 “주파수”에 대응한다.
- $u_0 = \frac{1}{\sqrt{n}}[1,1,1,\dots]$ : 모든 노드에서 동일한 값 → 0 주파수
- 저주파수: 인접 노드 간 값 차이가 완만함
- 고주파수: 인접 노드 간 값 차이가 극심함
원래의 푸리에 변환이 시간 신호 $f(t)$ 를 주파수 성분 $\hat{f}(\omega) = \int f(t) e^{-i\omega t} dt$ 로 바꾸는 것이라면, 그래프에서는 시간 대신 노드 간 연결 구조로 부드러움과 고주파성을 정의한다. 그래프 신호를 고유벡터의 합으로 분해하는 게 그래프 푸리에 변환이다.
\[\hat{f} = U^\top f, \qquad f = \sum_k \hat{f}_k\, u_k\]스펙트럴 그래프 합성곱
이제 푸리에 영역에서 합성곱을 정의할 수 있다. 신호 $x \in \mathbb{R}^N$ (각 노드의 스칼라 값)과, $\theta \in \mathbb{R}^N$ 으로 매개변수화된 필터 $g_\theta = \text{diag}(\theta)$ 의 곱으로 스펙트럴 합성곱을 정의한다.
\[g_\theta * x = U g_\theta U^\top x\]여기서 $U$ 는 정규화 라플라시안 $L = I_N - D^{-\frac{1}{2}} A D^{-\frac{1}{2}} = U \Lambda U^\top$ 의 고유벡터 행렬, 즉 그래프 푸리에 기저다. 그리고 필터 $g_\theta$ 는 고유값 $\theta$ 로 이루어진 대각행렬로, $\Lambda$ 의 역할을 대신한다.
직관적으로 무슨 일이 일어나나
이 연산을 풀어보면 흐름이 보인다. 입력 신호 $x$ 를 각 주파수 $u$ 와 내적($u^\top x$)하면, 그 스칼라 값은 $x$ 와 해당 주파수 $u$ 의 유사도를 나타낸다.
스칼라 값이 크면 그 주파수 성분이 입력 그래프에 강하게 담겨 있다는 뜻이고, 작으면 약하다는 뜻이다. 모든 주파수에 대해 $U^\top x$ 로 분해한 뒤, 필터 $g_\theta$ 로 각 주파수의 세기를 조절하고, 다시 $U$ 를 곱해 원래 노드 공간으로 되돌린다. 푸리에 영역에서 주파수별로 필터링한 뒤 역변환하는 셈이다.
Chebyshev 다항식 근사
그런데 식 $U g_\theta U^\top x$ 에는 두 가지 비용 문제가 있다.
- 라플라시안의 고유분해 자체가 비싸고, $U^\top x$ 행렬곱 계산 복잡도가 $O(N^2)$ 다.
- 노드 수 $N$ 이 커지면 사실상 불가능하다.
그래서 필터 $g_\theta(\Lambda)$ 를 Chebyshev 다항식으로 근사한다.
\[g_{\theta'}(\Lambda) \approx \sum_{k=0}^{K} \theta'_k\, T_k(\tilde{\Lambda})\]Chebyshev 다항식은 $T_n(x) = \cos(n \cos^{-1}(x))$ 로 정의되고, 다음 재귀 성질을 가진다.
\[T_0(x) = 1, \quad T_1(x) = x, \quad T_k(x) = 2x\,T_{k-1}(x) - T_{k-2}(x)\]이 재귀 덕분에 고유분해 없이 라플라시안을 $K$ 번 곱하는 것만으로 필터를 계산할 수 있고, 계수 학습도 안정적이며 경계값에서의 수치 진동(over-shoot)도 막아준다. $K$ 는 근사 다항식의 차수, 즉 몇 차 이웃까지 정보를 모을지를 결정한다.
1차 근사 — GCN의 계층별 전파 규칙
여기가 논문의 핵심이다. Chebyshev 근사에서 차수를 $K = 1$ 로, 그리고 $\lambda_{max} \approx 2$ 로 두는 1차 근사를 취하면 식이 극적으로 단순해진다.
\[g_{\theta'} * x \approx \theta'_0\, x + \theta'_1 (L - I_N)\, x = \theta'_0\, x - \theta'_1\, D^{-\frac{1}{2}} A D^{-\frac{1}{2}}\, x\]여기서 첫째 항 $\theta’_0 x$ 는 자기 정보, 둘째 항은 이웃 정보에 해당한다. 파라미터 수를 줄이기 위해 $\theta = \theta’_0 = -\theta’_1$ 으로 묶으면 다음과 같이 정리된다.
\[g_\theta * x \approx \theta \left( I_N + D^{-\frac{1}{2}} A D^{-\frac{1}{2}} \right) x\]Renormalization trick
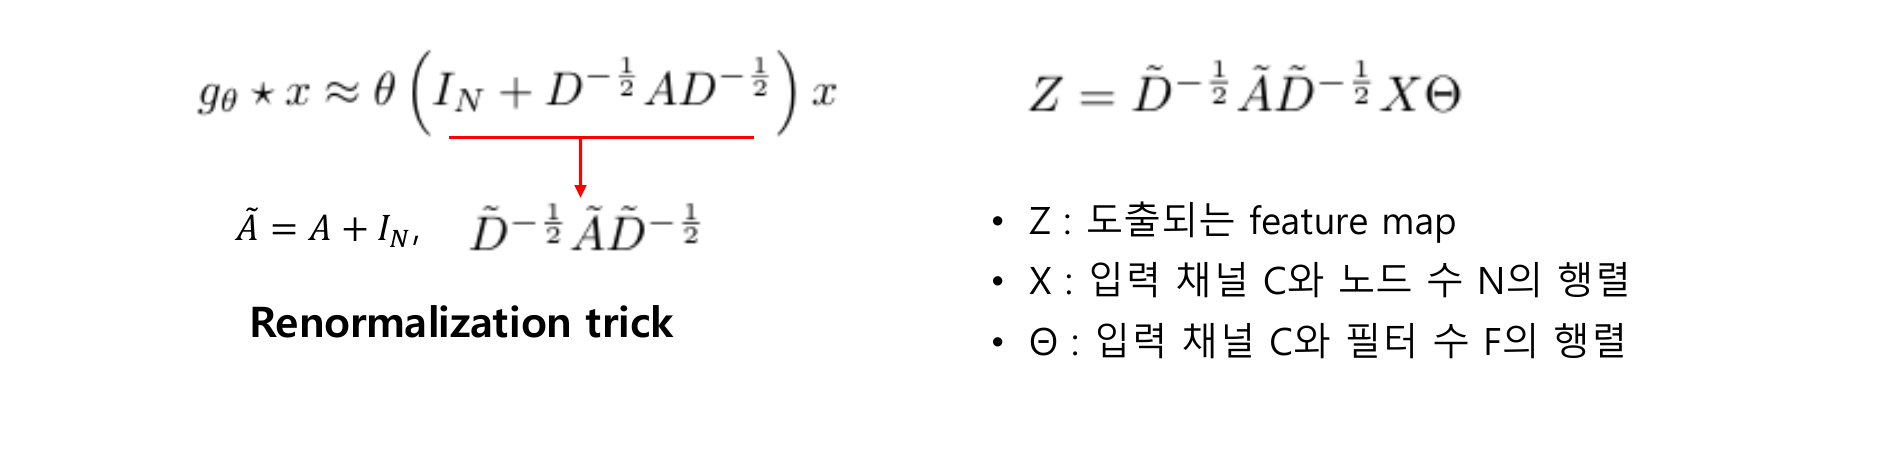
그런데 위 식의 $I_N + D^{-\frac{1}{2}} A D^{-\frac{1}{2}}$ 는 고유값 범위가 $[0, 2]$ 라서, 깊게 쌓으면 수치가 발산하거나 소실되기 쉽다. 그래서 renormalization trick을 적용한다 — self-loop을 추가한 인접 행렬에 정규화를 다시 거는 것이다.
\[\tilde{A} = A + I_N, \qquad \tilde{D}_{ii} = \sum_j \tilde{A}_{ij}\] \[I_N + D^{-\frac{1}{2}} A D^{-\frac{1}{2}} \;\rightarrow\; \tilde{D}^{-\frac{1}{2}} \tilde{A} \tilde{D}^{-\frac{1}{2}}\]self-loop($+I_N$)을 넣는 이유는 세 가지다.
- 이웃 평균을 낼 때 자기 정보의 손실을 막는다 (자기 자신도 이웃에 포함).
- 수치 안정화: 정규화로 고유값을 $[-1, 1]$ 부근으로 눌러 곱할수록 발산하는 것을 방지.
- 고립 노드 문제 해결: 간선 정보가 $0$ 이라 정규화 시 $0$ 으로 나누는 오류를 피한다.
계층별 전파 규칙
이걸 여러 채널·여러 층으로 일반화하면, GCN의 그 유명한 계층별 전파 규칙이 나온다.
\[H^{(l+1)} = \sigma\!\left( \tilde{D}^{-\frac{1}{2}} \tilde{A} \tilde{D}^{-\frac{1}{2}} H^{(l)} W^{(l)} \right)\]각 항의 의미는 다음과 같다.
| 기호 | 의미 |
|---|---|
| $\tilde{A} = A + I_N$ | self-loop을 추가한 인접 행렬 |
| $\tilde{D}{ii} = \sum_j \tilde{A}{ij}$ | $\tilde{A}$ 의 차수 행렬 |
| $W^{(l)}$ | $l$ 층의 학습 가능한 가중치 행렬 |
| $\sigma$ | ReLU, Softmax 같은 활성화 함수 |
| $H^{(l)} \in \mathbb{R}^{N \times D}$ | $l$ 층의 노드 표현(활성화) 행렬, $H^{(0)} = X$ |
한 줄로 읽으면 이렇다. “이웃 노드 특성을 정규화된 인접 행렬 $\tilde{D}^{-\frac{1}{2}} \tilde{A} \tilde{D}^{-\frac{1}{2}}$ 로 가중 평균하고($\to$ aggregate), 가중치 $W$ 로 변환한 뒤($\to$ transform), 활성화 함수를 통과시킨다.” 스펙트럴 그래프 이론에서 출발한 식이 결국 “이웃을 모아서 섞는다”는 직관적인 메시지 패싱으로 수렴한 것이다.
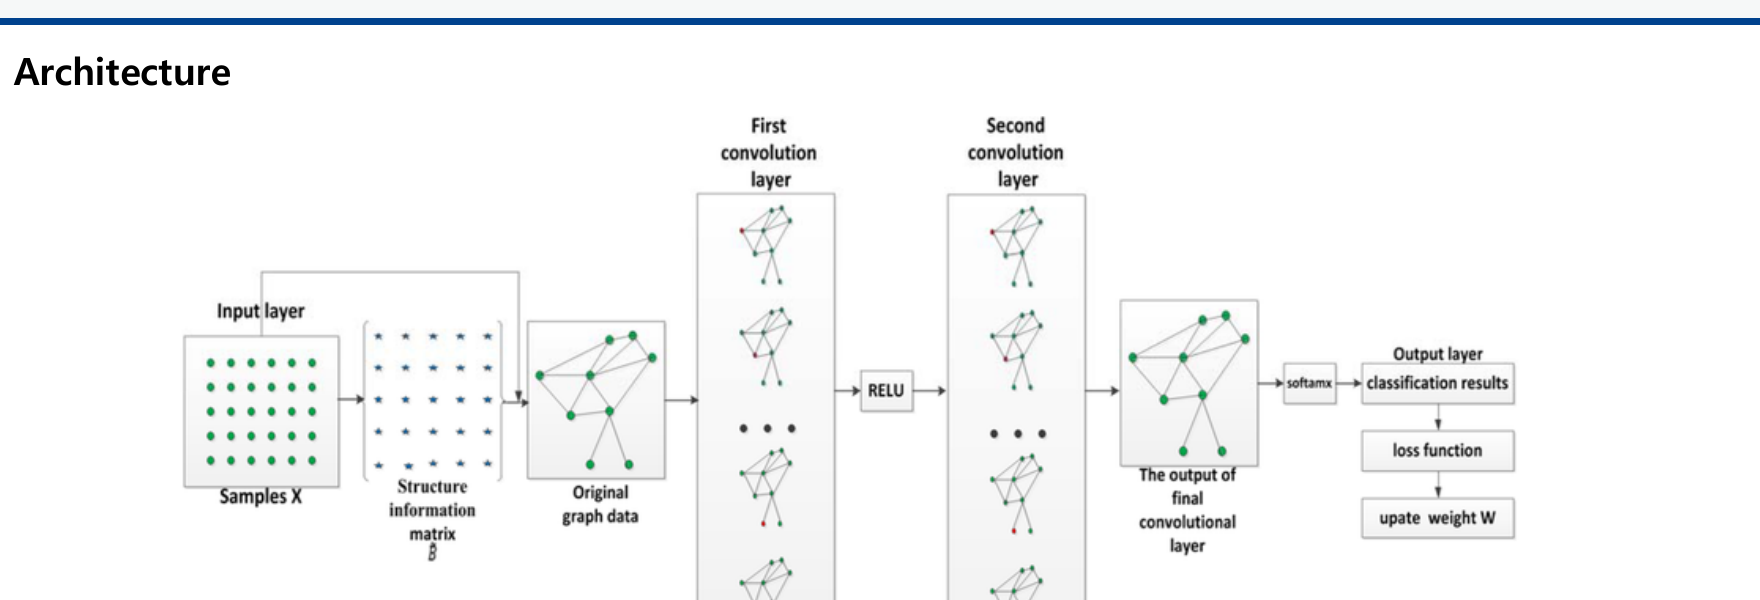
위 그림처럼 입력층은 각 노드의 초기 특성 벡터와 그래프 연결 구조(인접 행렬)를 받고, 합성곱 층은 인접 노드 특성을 구조 행렬로 집계해 가중치 $\theta$ 로 새 노드 표현을 만들며, 출력층은 Softmax로 각 노드의 라벨을 예측한다.
준지도 노드 분류로 묶기
마지막으로 이 전파 규칙을 준지도 분류 손실과 연결한다. 2층 GCN의 forward는 다음과 같다.
\[Z = \text{softmax}\!\left( \tilde{A}\; \text{ReLU}\!\left( \tilde{A} X W^{(0)} \right) W^{(1)} \right), \qquad \tilde{A} = \tilde{D}^{-\frac{1}{2}} \tilde{A} \tilde{D}^{-\frac{1}{2}}\]손실은 라벨이 있는 노드에 대해서만 교차 엔트로피로 계산한다.
\[\mathcal{L} = -\sum_{l \in Y_L} \sum_{f=1}^{F} Y_{lf}\, \ln Z_{lf}\]여기서 $Y_L$ 은 라벨이 있는 노드 인덱스 집합이다.
핵심은 이것이다. 라벨이 없는 노드도 $\tilde{A}$ 연산(이웃 집계)에 참여하기 때문에, 손실은 라벨된 노드에서만 계산되지만 그 그래디언트는 그래프 구조를 타고 라벨 없는 노드의 표현에까지 흘러간다. 명시적 라플라시안 정규화 항 없이도 평활도 가정이 모델 구조 자체에 녹아드는 것이다.
실험 결과
논문은 citation network(Citeseer, Cora, Pubmed)와 knowledge graph(NELL) 벤치마크에서 검증한다. 노드는 논문, 엣지는 인용 관계, 노드 특성은 본문 단어의 BoW(Bag-of-Words), 라벨은 논문 주제다. 라벨률이 0.3~5% 수준으로 매우 낮은 전형적인 준지도 설정이다.
| Method | Citeseer | Cora | Pubmed | NELL |
|---|---|---|---|---|
| DeepWalk | 43.2 | 67.2 | 65.3 | 58.1 |
| Planetoid | 64.7 | 75.7 | 77.2 | 61.9 |
| GCN (this paper) | 70.3 | 81.5 | 79.0 | 66.0 |
단순한 2층 구조만으로도 기존 모든 모델보다 정확도와 효율성에서 앞섰다. 모델 정규화 $\tilde{A} = \tilde{D}^{-\frac{1}{2}} \tilde{A} \tilde{D}^{-\frac{1}{2}}$ 가 그래프 구조와 노드 특성을 동시에 처리한 덕분이다.
헷갈리기 쉬운 포인트
발표 준비하면서, 그리고 Q&A에서 막혔던 부분들을 정리해둔다.
1. “그래프 합성곱이 왜 굳이 푸리에 영역으로 가나?”
이미지처럼 고정된 격자가 아니라 이웃 수·순서가 제각각이라 공간 영역에서 필터를 직접 정의하기 어렵다. 그래서 라플라시안 고유벡터(주파수 기저)로 신호를 분해한 뒤, 주파수별로 필터링하고 역변환하는 방식으로 합성곱을 정의한다.
2. “고유분해를 매번 한다고?”
스펙트럴 합성곱이니 매번 라플라시안을 고유분해한다 — 아니다. 그게 너무 비싸서($O(N^2)$) Chebyshev 다항식으로 근사하고, GCN은 거기서 다시 $K=1$ 1차 근사까지 내려간다. 결국 고유분해 없이 정규화 인접 행렬 곱만 남는다.
3. “self-loop($\tilde{A} = A + I_N$)은 왜 넣나?”
세 가지다 — (1) 이웃을 평균 낼 때 자기 정보가 사라지는 걸 막고, (2) renormalization으로 수치 발산을 방지하며, (3) 고립 노드에서 0으로 나누는 오류를 피한다.
4. “라벨 없는 노드는 학습에 안 쓰이는 거 아닌가?”
손실은 라벨된 노드에서만 계산되지만, 라벨 없는 노드도 $\tilde{A}$ 의 이웃 집계에 참여한다. 그래서 그래디언트가 그래프 전체로 전파되어 라벨 없는 노드의 표현까지 같이 학습된다 — 이게 준지도 학습의 핵심이다.
5. “정규화를 $L_{sym}$ 대칭으로 하는 이유?”
노드 차수가 크게 다르면 차수 큰 노드가 과대 반응하고 작은 노드가 과소 반응한다. 행·열을 동시에 $\sqrt{\text{차수}}$ 로 보정하면 차수 차가 동등해지고, 대칭 행렬이라 고유벡터가 직교해 고유분해도 깔끔해진다.
정리하며
GCN의 핵심은 한 줄로 정리된다.
스펙트럴 그래프 합성곱을 1차 근사하면, “이웃 노드를 정규화된 인접 행렬로 집계하고 가중치로 변환한다”는 간결한 전파 규칙이 나온다.
전체 흐름은 결국 이 줄기를 따라간다.
그래프 라플라시안 → 고유분해(푸리에 기저) → 스펙트럴 합성곱 $U g_\theta U^\top x$ → Chebyshev 근사 → 1차 근사 + renormalization → $H^{(l+1)} = \sigma(\tilde{D}^{-\frac{1}{2}} \tilde{A} \tilde{D}^{-\frac{1}{2}} H^{(l)} W^{(l)})$
처음엔 스펙트럴 그래프 이론의 낯선 수학에 압도됐지만, 그 복잡한 유도가 결국 “이웃을 모아 섞는다”는 직관적인 메시지 패싱으로 귀결된다는 게 인상적이었다. SVM에서 최적화 이론을, ResNet에서 깊은 네트워크의 학습을 봤다면, GCN에서는 정형 격자를 벗어난 데이터에 딥러닝을 어떻게 일반화하는가를 처음으로 마주했다. 이후 GNN 계열 논문을 읽는 토대가 됐다는 점에서, 세 번째 논문으로 GCN을 고른 게 좋은 선택이었다.
참고
- Kipf, T. N., & Welling, M. (2017). Semi-Supervised Classification with Graph Convolutional Networks. ICLR.
- 본 글의 발표 슬라이드: lab-seminar-2025 / 03_GCN.pdf
</content> </invoke>
« ResNet 논문 리뷰 - 잔차 학습으로 심층 신경망을 살리다
BYOL 논문 리뷰 - 네거티브 샘플 없이 표현을 학습하다 »