SVM 논문 리뷰 - 마진을 최대화해서 최적의 분류기를 찾다
해설글
작성 · 10분 읽기 · 조회수 —
들어가며
학부연구생으로 들어간 첫 학기, 랩 세미나에서 가장 처음 발표한 논문이 SVM이었다. 딥러닝으로 넘어가기 전에 고전 ML의 정수를 한 번 짚고 가자는 취지였는데, 막상 논문을 펴보니 수식이 끝도 없이 나왔다.
처음엔 그냥 선 하나 긋는 분류기 아닌가 하고 가볍게 봤는데, 왜 그 선이 최적인지를 수학적으로 증명하는 과정이 SVM의 전부였다. 마진 최대화에서 시작해서 라그랑지안 변환, KKT 조건, 쌍대 공간, 커널 트릭까지 — 최적화 이론을 처음 제대로 마주한 게 이 논문이었다.
A Training Algorithm for Optimal Margin Classifiers — Bernhard E. Boser, Isabelle M. Guyon, Vladimir N. Vapnik (COLT 1992)
발표 자료 만들면서 정리했던 흐름을 그대로 블로그에 옮겨본다.
Why SVM? — 왜 SVM인가
좋은 분류기를 만들려면 분류 함수의 용량(파라미터 수)과 학습 데이터의 크기가 균형을 이뤄야 한다.
- 파라미터가 너무 많으면 → 과적합 (일반화 성능 저하)
- 파라미터가 너무 적으면 → 과소적합
그런데 SVM은 이 trade-off를 직접 조율하지 않는다. 마진을 최대화하는 것만으로 용량이 자동으로 조절된다.
세 가지 강점
| 강점 | 핵심 |
|---|---|
| 전역 최적해 보장 | Convex 최적화라 Local Minimum이 존재하지 않음 |
| 일반화 성능 이론 | 마진 최대화 + Robust / Outlier 처리 |
| 효율성·해석 가능성 | Support Vector만으로 결정 경계 형성 |
각각의 근거는 아래에서 하나씩 풀어간다.
이진 분류와 결정 함수
데이터와 라벨
이진 분류에서는 각 데이터 $x_k$ 에 라벨 $y_k$ 를 부여한다.
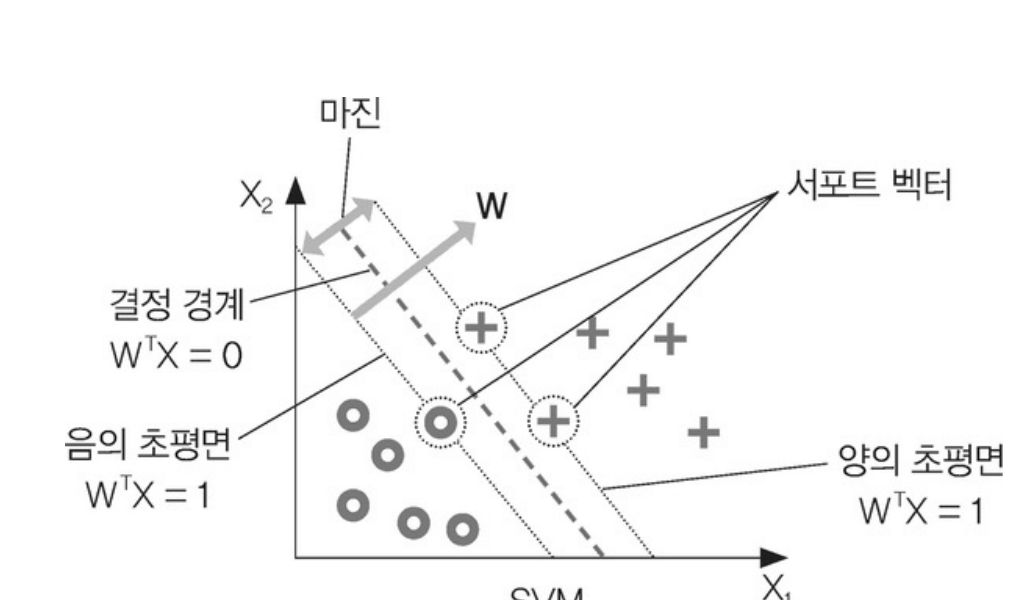
\[(x_1, y_1), (x_2, y_2), \dots, (x_p, y_p)\] \[x_k \in \text{class A} \Rightarrow y_k = +1, \quad x_k \in \text{class B} \Rightarrow y_k = -1\]학습으로 결정 함수 $D(x)$ 의 파라미터를 찾고, 새 입력은 $D(x) > 0$ 이면 A, 아니면 B로 분류한다. 그리고 $D(x) = 0$ 인 점들의 집합이 바로 결정 경계(초평면) 다.
선형이어야 하는 건 파라미터지 입력이 아니다
여기서 처음에 헷갈렸던 핵심 포인트.
결정 함수는 파라미터 $(w, b)$ 에 대해서는 선형이어야 하지만, 입력 $x$ 에 대해서는 비선형이어도 된다.
매핑 함수 $\phi$ 나 커널 $K$ 로 입력을 비선형 변환할 수 있기 때문이다. 그래서 결정 함수는 두 가지 표현이 가능하다.
① 직접 공간 (Direct Space)
고차원 특징을 직접 다루는 공간:
\[D(x) = \sum_{i=1}^{N} w_i \phi_i(x) + b\]② 쌍대 공간 (Dual Space)
라그랑주 승수와 커널을 다루는 공간:
\[D(x) = \sum_{k=1}^{p} \alpha_k y_k K(x_k, x) + b\]여기서 서포트 벡터(Support Vector) 는 결정 경계에서 가장 가까운 표본을 말한다. SVM 학습에는 오직 이 서포트 벡터만 기여한다.
고차원 매핑 φ — 왜 필요한가
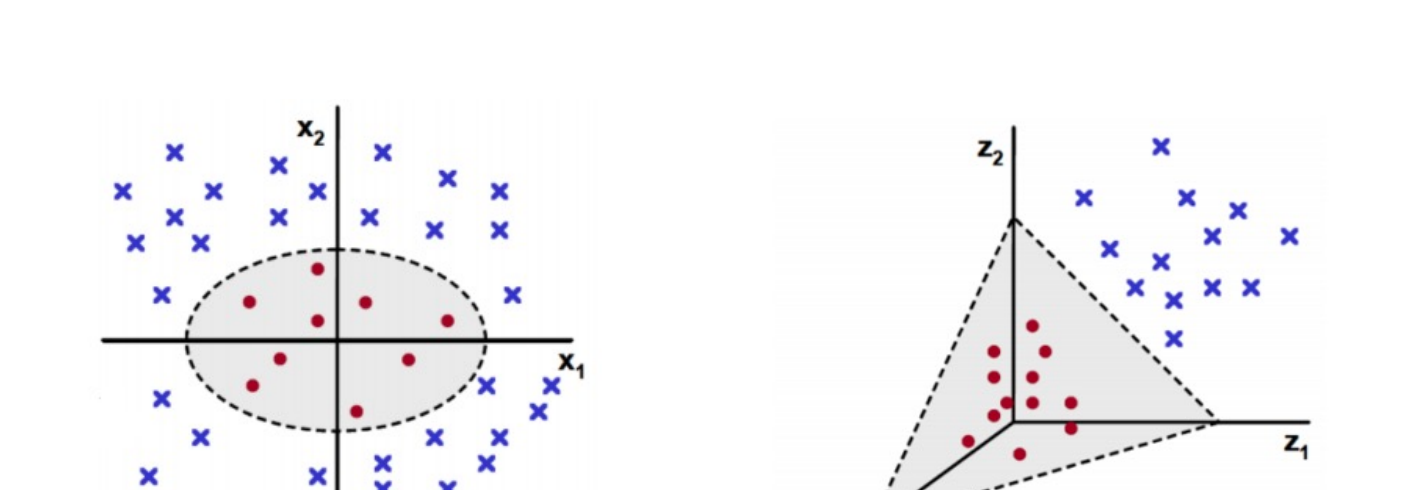
저차원에서 선형 분리가 안 되는 데이터라도, 더 높은 차원으로 매핑하면 선형 분리가 가능해진다. 이게 $\phi$ 함수의 역할이다.
예를 들어 2차원 좌표를 다음처럼 3차원으로 올린다:
\[\phi(x_1, x_2) = (x_1^2,\; \sqrt{2}\,x_1 x_2,\; x_2^2)\]아래 그림에서 왼쪽은 원래 공간에서 원형 경계로만 나뉘는 비선형 데이터인데, $\phi$ 로 고차원에 매핑하면 오른쪽처럼 평면(초평면) 하나로 깔끔하게 갈린다.
직접 공간에서의 마진 최대화
마진 거리 유도
직접 공간의 결정 함수는 $D(x) = W \cdot \phi(x) + b$ 이고, 초평면과 점 사이의 거리는 $\frac{D(x)}{\lVert W \rVert}$ 로 나타난다.
서포트 벡터 한 점을 $x_0$, 거기서 초평면에 내린 수선의 발을 $x_p$ 라고 하면, 거리 벡터 $x_0 - x_p$ 는 법선 벡터 $w$ 와 평행하므로 $x_0 - x_p = r \cdot \hat{w}$ 이다. $x_p$ 는 초평면 위의 점이므로 $w \cdot (x_0 - r\hat{w}) + b = 0$, 이를 $r$ 에 대해 풀면:
\[r = \frac{\lvert w \cdot x_0 + b \rvert}{\lVert w \rVert}\]마진 최대화 → 노름 최소화
모든 학습 예제가 마진 $M$ 이상 떨어져 있어야 하므로 $y_k(w \cdot \phi(x_k) + b) \ge M$ 이고, 마진 최대화 문제는 다음과 같다:
\[M^* = \max_{W,\, \lVert w \rVert = 1} M \quad \text{subject to } y_k(w \cdot \phi(x_k)) \ge M\]그런데 $M$ 은 $w, b$ 로 이루어져 있어 둘 다 변수다. 그래서 $M$ 을 1로 고정하고, 그 대신 가중치 노름 $\lVert w \rVert$ 를 최소화하는 문제로 바꾼다 (미분이 쉽도록 제곱):
\[\min_{w} \frac{1}{2}\lVert w \rVert^2 \quad \text{subject to } y_k(w \cdot \phi(x_k)) \ge 1\]이때 최대 마진은 $M^* = 1/\lVert w^* \rVert$ 다.
직접 공간에서 차원이 매우 높거나 무한대면 $\phi$ 가 너무 복잡해져 비효율적이다. 그래서 쌍대 공간으로 옮긴다.
쌍대 공간으로 — 라그랑지안, KKT, 커널 트릭
이 파트가 발표 준비하면서 제일 빡셌던 부분이다. 부등식 제약이 있는 최적화 문제를 풀기 위해 라그랑지안 변환이 필요하다.
라그랑지안 변환
일반적인 부등식 제약 최적화는 $\min f(x)$ subject to $g_i(x) \le 0$, $h_j(x) = 0$ 형태이고, 라그랑지안은 원함수와 제약조건을 라그랑주 승수로 선형결합한 것이다:
\[\mathcal{L}(x, \lambda, \nu) = f(x) + \sum_{i=1}^{m} \lambda_i g_i + \sum_{j=1}^{p} \nu_j h_j\]SVM에 적용하면 ($\alpha$ 가 라그랑주 승수):
\[\mathcal{L}(w, b, \alpha) = \frac{1}{2}\lVert w \rVert^2 - \sum_{k=1}^{p} \alpha_k \left[ y_k(w \cdot \phi(x_k) + b) - 1 \right]\]KKT 조건 — 최적화의 필요조건 4가지
| # | 조건 | 식 |
|---|---|---|
| 1 | Stationarity (정지) | $\nabla_x \mathcal{L} = 0$ |
| 2 | Primal feasibility (원 제약) | $g_i \le 0,\; h_j = 0$ |
| 3 | Dual feasibility (쌍대 변수) | $\lambda_i \ge 0$ |
| 4 | Complementary slackness (상보성) | $\lambda_i \cdot g_i = 0$ |
4번 상보성 조건이 SVM의 핵심이다. 제약이 활성화된(경계에 걸린) 점만 $\alpha_k > 0$ 이고, 나머지는 $\alpha_k = 0$ 이 된다. 즉 서포트 벡터만 살아남고 나머지 데이터는 무시되는 이유가 바로 여기서 나온다.
w 소거와 쌍대 함수
라그랑지안을 $w$ 로 편미분해서 0으로 두면, 최적 $w^*$ 는 서포트 패턴들의 선형결합으로 표현된다:
\[\frac{\partial \mathcal{L}}{\partial w} = 0 \;\Rightarrow\; w^* = \sum_{k=1}^{p} \alpha_k y_k \phi(x_k)\]$b$ 로도 편미분하면 $\sum_k \alpha_k y_k = 0$ 이 나와 $b$ 항이 소거된다. 결국 $w$ 를 소거한 쌍대 목적 함수 $J(\alpha)$ 가 얻어진다:
\[J(\alpha) = \sum_{k=1}^{p} \alpha_k - \frac{1}{2} \sum_{k=1}^{p} \sum_{l=1}^{p} \alpha_k \alpha_l y_k y_l K(x_k, x_l)\]그리고 결정 함수는 $D(x) = \sum_k \alpha_k y_k K(x_k, x) + b$ 형태가 된다.
왜 쌍대 공간으로? 그리고 왜 커널 트릭이 되나
여기서 두 가지 의문이 들었다.
Q1. 왜 굳이 쌍대 공간으로 옮기나?
쌍대 함수로 변환하면 식 안에 $\phi(x_i) \cdot \phi(x_j)$ — 고차원 매핑된 벡터끼리의 내적만 남는다. 직접 공간처럼 $\phi$ 를 통째로 계산할 필요가 없어진다.
Q2. 왜 옮기니까 커널 트릭이 되나?
그 내적을 일일이 계산하는 대신, 일반화된 커널 함수 하나로 치환할 수 있기 때문이다:
\[\phi(x_i) \cdot \phi(x_j) = K(x_i, x_j)\]즉 고차원으로 직접 올라가지 않고도, 저차원 입력만으로 고차원 내적 결과를 얻는다. 이게 커널 트릭이다. 커널은 원하는 결정 경계 모양에 따라 고른다:
| 커널 | 식 | 경계 |
|---|---|---|
| Linear | $K(x, x’) = x^T x’$ | 기존 공간 그대로 (선형) |
| Polynomial | $K(x, x’) = (x^T x’ + c)^d$ | 원 같은 비선형 |
| RBF (Gaussian) | $K(x, x’) = \exp(-\gamma \lVert x - x’ \rVert^2)$ | 복잡한 비선형 |
| Sigmoid | $K(x, x’) = \tanh(\alpha x^T x’ + c)$ | 신경망 수준의 경계 |
편향 b 구하기
편향 $b$ 는 두 클래스의 서포트 벡터 $x_A$($y=+1$), $x_B$($y=-1$) 를 결정 함수에 대입해 연립하면 구할 수 있다 — 두 서포트 벡터의 중점이 결정 경계 위에 오도록:
\[b^* = -\frac{1}{2} w^* \cdot (\phi(x_A) + \phi(x_B))\]알고리즘의 특징 (Properties)
유일 해 (Unique Solution)
SVM의 학습 문제는 목적 함수가 이차식(quadratic)이고 제약이 선형(linear)인 Quadratic Programming 문제다. 이런 문제는 convex 구조라서 국소 최소점(local minima)이 없고 전역 최적해가 유일하다.
초기값이나 학습 경로에 의존하지 않고 항상 같은 해를 찾는다는 강력한 이론적 보장이다. (왜 convex인지는 아래 보충 섹션에서)
일반화 성능 (Generalization)
SVM은 경험 오차만 최소화하는 게 아니라 모델 복잡도까지 함께 고려하는 구조적 위험 최소화(SRM, Vapnik) 원칙을 따른다:
마진이 클수록 서포트 벡터 수가 줄고, 그 결과 일반화 오차가 낮아진다. Leave-One-Out 추정으로 일반화 오차의 상한도 잡힌다:
\[R(f) \le \frac{m}{n} \quad (m = \text{선형 독립 서포트 벡터 수},\; n = \text{전체 샘플 수})\]계산 효율성 & 해석 가능성
학습이 끝나면 $\alpha_k$ 중 서포트 벡터만 0이 아닌 값을 갖고 나머지는 전부 0이다.
- 예측 시 → 서포트 벡터와의 내적만 계산
- 고차원 → 커널 트릭으로 직접 다룰 필요 없음
- 해석 → $\alpha_k$ 의 크기로 어떤 샘플이 결정 경계에 얼마나 기여했는지 파악 가능
Soft Margin — 현실의 노이즈를 다루기
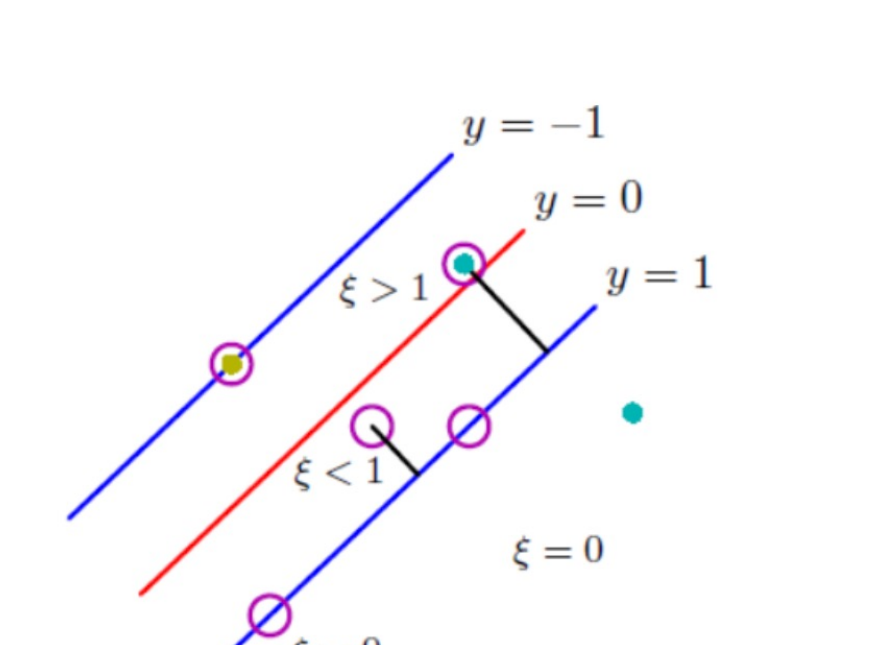
현실 데이터는 노이즈가 많아 완벽한 선형 분리가 안 되는 경우가 대부분이다. 그래서 슬랙 변수(Slack Variable) $\xi_i$ 를 도입해 일부 위반을 허용한다.
슬랙 변수의 세 가지 경우
| 경우 | 의미 |
|---|---|
| $\xi_i = 0$ | 알맞은 라벨이 마진 밖에 위치 (제대로 분류) |
| $0 < \xi_i < 1$ | 알맞은 라벨이 마진 내부에 위치 |
| $\xi_i > 1$ | 잘못 분류된 라벨 |
이 슬랙 변수가 제약조건과 목적 함수에 추가된다:
\[\min_{w, b, \xi} \frac{1}{2}\lVert w \rVert^2 + C \sum_{i=1}^{n} \xi_i \quad \text{subject to } y_k(w \cdot \phi(x_i) + b) \ge 1 - \xi_i,\; \xi_i \ge 0\]상수 C — 과적합과 과소적합 사이
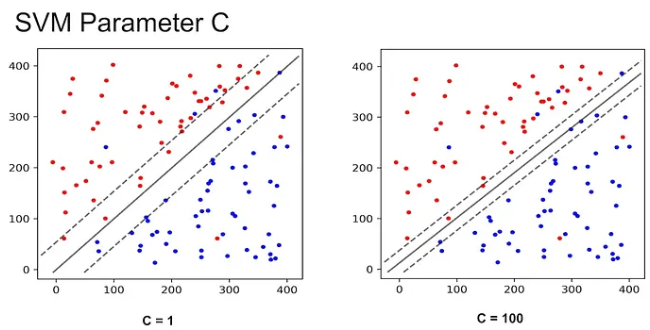
상수 $C$ 는 전체 위반량에 대한 패널티 계수다.
- $C$ 가 클수록 → 위반에 민감 → 마진이 좁아짐 → 과적합 위험
- $C$ 가 작을수록 → 위반에 둔감 → 마진이 넓어짐 → 과소적합 위험
하이퍼파라미터 튜너
그래서 일반화 성능을 가장 높이는 $C$ 를 찾는 게 중요하다.
GridSearchCV
가능한 모든 조합을 전부 탐색. 튜닝 파라미터가 $C$ 하나뿐인 선형 커널에 적합.
RandomSearchCV
일부 조합을 무작위 샘플링.
Bayesian Optimization
이전 결과를 바탕으로 좋은 조합이 나올 확률이 높은 곳을 탐색 (Gaussian Process 기반의 Optuna, skopt 등). 다항식 커널($\gamma, c, d, C$)처럼 파라미터가 많고 복잡도가 급증할 때 효율적.
(보충) SVM은 왜 유일 해를 갖는가 — Convex 증명
발표 후 받았던 질문 중 하나가 “유일 해를 갖는다는 걸 어떻게 보장하냐”였다. 유일 해의 조건은 두 가지다.
- 목적 함수가 convex
- 제약조건으로 정의된 영역이 convex set
함수가 convex라는 것
정의역 안의 모든 부분이 아래로 볼록하다는 의미다:
\[f(\lambda x_1 + (1-\lambda)x_2) \le \lambda f(x_1) + (1-\lambda)f(x_2)\]볼록하면 극값이 하나뿐이고, 그 점이 곧 Global Minimum이 된다 (접선 불등식 정리).
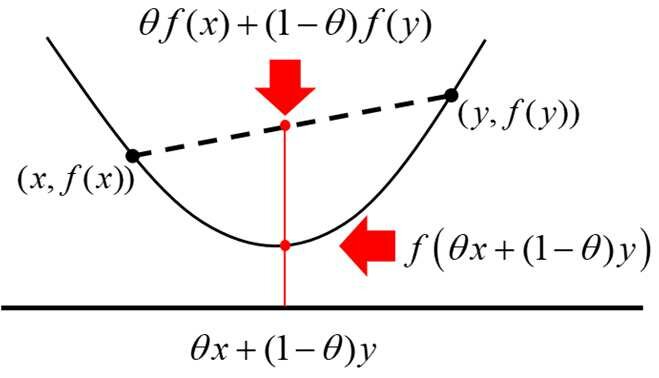
목적 함수 J가 convex인 이유
목적 함수 $J(\alpha) = -\frac{1}{2}\alpha^T H \alpha + \mathbf{1}^T \alpha$ 의 헤시안은 $\nabla^2 J(\alpha) = H$ 인데, 머서 정리(Mercer’s theorem) 에 의해 커널 $K$ 가 PSD(positive semi-definite)이므로 커널 행렬 $H_{ij} = y_i y_j K(x_i, x_j)$ 도 PSD다.
머서 정리 대신 매핑 함수 $\phi$ 로 직접 보일 수도 있다:
\[\nu^T K \nu = \sum_{i,j} \nu_i \nu_j \phi(x_i)^T \phi(x_j) = \left\lVert \sum_i \nu_i \phi(x_i) \right\rVert^2 \ge 0\]선형 결합의 제곱 꼴이라 항상 0 이상이다.
정리하면
제약조건(KKT 4가지)은 모두 선형 결합이라 정의역도 convex set이다. 따라서:
커널 $K$ convex → 목적 함수 $J$ convex → 제약 영역 convex → 유일 해 보장
헷갈리기 쉬운 포인트
발표 준비하면서, 그리고 Q&A에서 헷갈렸던 부분들을 정리해둔다.
1. “왜 굳이 쌍대 공간으로 옮기나?”
직접 공간에서는 $\phi$ 가 고차원/무한차원이면 $w$ 를 직접 계산할 수 없다. 쌍대로 가면 식에 $\phi(x_i) \cdot \phi(x_j)$ 내적만 남고, 이걸 커널 함수로 치환(커널 트릭)하면 고차원에 직접 올라가지 않고도 계산이 끝난다.
2. “마진 최대화가 왜 노름 최소화랑 같은 거야?”
마진 $M = 1/\lVert w \rVert$ 이기 때문이다. $w$ 를 스케일하는 자유도가 있으니 $M = 1$ 로 고정하고, 그 대신 $\lVert w \rVert$ 를 최소화하면 마진이 최대가 된다.
3. “서포트 벡터만 학습에 기여한다는 게 무슨 뜻?”
KKT 상보성 조건 때문이다. 마진 경계에 걸린 점만 $\alpha_k > 0$ 이고 나머지는 $\alpha_k = 0$ 이다. 그래서 멀리 있는 점이나 이상치를 제거해도 결정 경계가 거의 안 흔들린다 — 이게 SVM의 robustness다.
4. “C는 클수록 좋은 거 아닌가?”
클수록 정확하니까 좋다 — 아니다. $C$ 가 크면 오류에 민감해져 마진이 좁아지고 과적합된다. $C$ 가 작으면 마진이 넓어져 과소적합된다. 데이터에 맞게 튜닝해야 하는 하이퍼파라미터다.
5. “SVM은 왜 local minimum 걱정이 없나?”
목적 함수가 convex이고 제약 영역도 convex set이라, 최적화 문제 전체가 convex다. 신경망과 달리 초기값·경로에 상관없이 항상 같은 전역 최적해를 찾는다. 이게 고전 ML로서 SVM이 갖는 가장 깔끔한 장점이다.
정리하며
SVM의 핵심은 한 줄로 정리된다.
결정 경계와 서포트 벡터 사이의 마진을 최대화하면, 분류 함수의 용량이 자동으로 조절되어 일반화 성능이 좋아진다.
전체 흐름은 결국 이 한 줄기를 따라간다:
마진 최대화 → $\lVert w \rVert$ 최소화 → 라그랑지안 변환 → KKT 조건 → 쌍대 함수 → 커널 트릭
첫 발표라 수식의 양에 압도됐지만, 돌이켜보면 라그랑주 승수·KKT·쌍대 문제·convex 최적화 같은 최적화 이론의 기초를 여기서 처음 제대로 잡았다. 이후 딥러닝의 손실 함수와 최적화를 이해하는 토대가 됐다는 점에서, 첫 논문이 SVM이었던 게 다행이라는 생각이 든다.
참고
- Boser, B. E., Guyon, I. M., & Vapnik, V. N. (1992). A Training Algorithm for Optimal Margin Classifiers. COLT.
- 본 글의 발표 슬라이드: lab-seminar-2025 / 01_SVM.pdf
« SQLite 총정리 - 코드와 정의 치트시트
ResNet 논문 리뷰 - 잔차 학습으로 심층 신경망을 살리다 »