BYOL 논문 리뷰 - 네거티브 샘플 없이 표현을 학습하다
해설글
작성 · 7분 읽기 · 조회수 —
들어가며
HEART LAB 세미나에서 발표한 네 번째 논문이다. SVM으로 고전 ML의 최적화 이론을 잡고, ResNet으로 깊은 네트워크를, GCN으로 그래프 위의 학습을 보고 나서, 이번엔 레이블 없이 표현을 배우는 자기지도학습(SSL)으로 넘어왔다.
처음 BYOL 제목을 봤을 때 가장 의아했던 건 이거였다. 대조학습(contrastive learning) 계열은 “비슷한 건 가깝게, 다른 건 멀게”가 핵심이라고 배웠는데, BYOL은 네거티브 샘플이 꼭 필요하다는 그 전제를 정면으로 깨버린다. 밀어낼 음성 쌍 없이, 같은 이미지의 두 뷰를 서로 가깝게 만드는 것만으로 표현이 무너지지(collapse) 않고 학습된다는 주장이었다.
Bootstrap Your Own Latent: A New Approach to Self-Supervised Learning — Jean-Bastien Grill et al. (NeurIPS 2020)
“그러면 그냥 모든 출력을 같은 벡터로 만들어서 손실 0으로 치팅하면 되는 거 아냐?”라는 의문에서 출발해, BYOL이 그 함정을 어떻게 피하는지를 따라가며 정리한 글이다.
Why SSL? — 왜 자기지도학습인가
Vision에서 가장 흔한 레시피는 ImageNet으로 미리 학습한 모델을 가져와 전이학습(transfer learning)하는 것이다. 방대한 데이터로 좋은 필터를 학습시켜 두고, 내 task에 맞게 마지막 부분만 다시 학습한다.
여기서 두 가지 용어를 먼저 못 박아두자.
| 용어 | 의미 |
|---|---|
| Upstream task | pre-training 단계의 학습 task (예: ImageNet으로 ResNet50 백본 학습) |
| Downstream task | 전이학습으로 풀고 싶은 실제 target task (분류·검출·분할 등) |
그런데 기존 방식에는 두 가지 의문이 따라붙는다.
- Supervised Learning 방식이 Downstream task에 효과적인 feature를 학습하는 데 도움이 되는가?
- 백본을 학습하는 데(Upstream) 대용량 레이블이 정말 필요한가?
첫 번째 답이 “꼭 그렇지는 않다”면, 두 번째 답은 자연스럽게 “레이블이 필요 없다”로 따라온다. 그래서 첫 번째 질문만 고민하면 된다.
의자 예시 — “무엇인가” vs “무엇과 닮았는가”
CNN 분류 학습의 목표는 모양이 제각각인 의자들을 전부 “의자”라는 하나의 레이블로 몰아넣는 것이다. 그런데 사람이 유아기에 의자를 구분하게 된 건 누가 “이것도 의자, 저것도 의자”라고 일일이 알려줘서가 아니라, 각 사물의 특성을 먼저 파악하고 서로 닮았는지를 비교해 나갔기 때문이다.
즉, 다양한 의자를 처음부터 “모두 같은 것”이라고 가정하고 출발하는 게 인간의 학습 방식에 맞지 않다고 본 것이다. 핵심은 “What is it?” 이 아니라 “What is it like?” — 무엇인지보다 무엇과 닮았는지를 먼저 배운다.
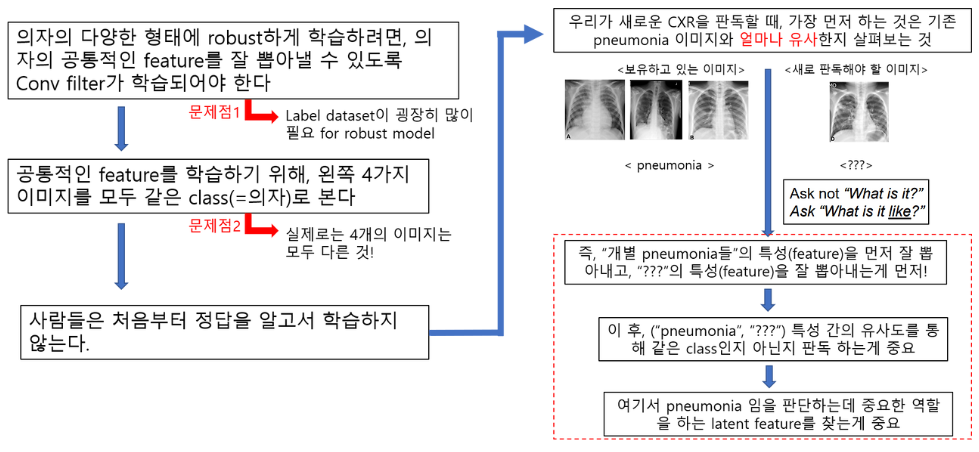
레이블이 미리 박아둔 기준(pre-define)에 과적합되면, 새 데이터에서 의미 있는 소견이 무시되거나 적은 데이터셋에서 cheating에 최적화될 위험이 있다. 그래서 먼저 이미지 자체의 특성을 잘 표현하도록 학습시키는 게 순서라는 발상이 SSL의 동기다.
Representation Learning — 좋은 표현이란
SSL이 진짜로 원하는 건 분류 정확도가 아니라 좋은 표현(representation) 이다. 사진·문장·오디오를 고정 길이 벡터로 인코딩하는 것인데, 좋은 표현은 세 가지 속성을 갖는다.
| 속성 | 의미 | 수식 |
|---|---|---|
| 불변성 (invariance) | 같은 의미면 표현이 비슷 | $f_\theta(x) \approx f_\theta(t(x)),\ t \in \mathcal{T}$ |
| 구별성 (discrimination) | 다른 의미면 표현이 멀리 | $\lVert f_\theta(x_i) - f_\theta(x_j) \rVert$ 크게, if $y_i \ne y_j$ |
| 압축 (compression) | 고차원을 저차원에 잘 압축 | 잡음 제거, 정보 밀도 향상 |
여기서 한 가지 복선. 대조학습은 위 표의 불변성과 구별성을 동시에 다룬다(가까운 쌍 + 밀어낼 음성 쌍). 뒤에서 보겠지만 BYOL은 불변성만 직접 최적화한다 — 그런데도 표현이 무너지지 않는 게 이 논문의 핵심 마술이다.
Pretext task — 가짜 과제로 진짜 표현을 얻는다
레이블이 없으니 학습 신호를 데이터 자체에서 만들어야 한다. 그래서 SSL은 최종 목표가 아닌 가짜(proxy) 학습 과제, 즉 pretext task를 설계한다.
\[\min_{\theta}\ \mathbb{E}_{x \sim p_x}\left[ \mathcal{L}\big(g_\phi(f_\theta(t_1(x))),\ g_\phi(f_\theta(t_2(x)))\big) \right]\]- $f_\theta$: 인코더, $t_1, t_2$: 증강 함수(증강군 $\mathcal{T}$에서 샘플링), $g_\phi$: projection/prediction head
- $\mathcal{L}$: pretext 손실 (Contrastive Loss, Reconstruction Loss 등)
손실 함수의 형태가 곧 pretext task의 종류를 결정한다.
BYOL의 pretext task는 “같은 원본에서 만든 두 뷰의 표현이 서로 같아지도록” 하는 것이다. 단, 한쪽 방향(teacher → student)만 학습하도록 stop-gradient를 적용한다. 이 비대칭이 왜 중요한지는 구조를 보면 드러난다.
Augmentation — 두 개의 뷰 만들기
증강은 같은 샘플을 다르게 변형해도 ‘같은 의미’로 인식하도록 학습시키는 핵심 장치로, 논문에서 $\mathcal{T}$ 기호로 등장한다.
\[x' = t(x),\quad t \in \mathcal{T}\]가장 중요한 조건은 변환 후에도 의미(Label)가 바뀌면 안 된다는 것. 좌우 반전·회전·색 변화·노이즈·크롭·블러 등을 쓴다. BYOL은 한 이미지 $x$에서 두 변환 $t, t’$를 i.i.d.로 뽑아 두 뷰 $v = t(x)$, $v’ = t’(x)$를 만든다.
\[t,\, t' \sim^{\text{i.i.d.}} \mathcal{T}\]이 두 뷰는 같은 원본에서 나왔으니 임베딩이 가까워야 하고(불변성), 색·노이즈·크롭의 차이를 줄이려다 보면 모델은 공통의 의미·구조 특징을 학습하게 된다.
BYOL의 구조 — Online / Target / Predictor
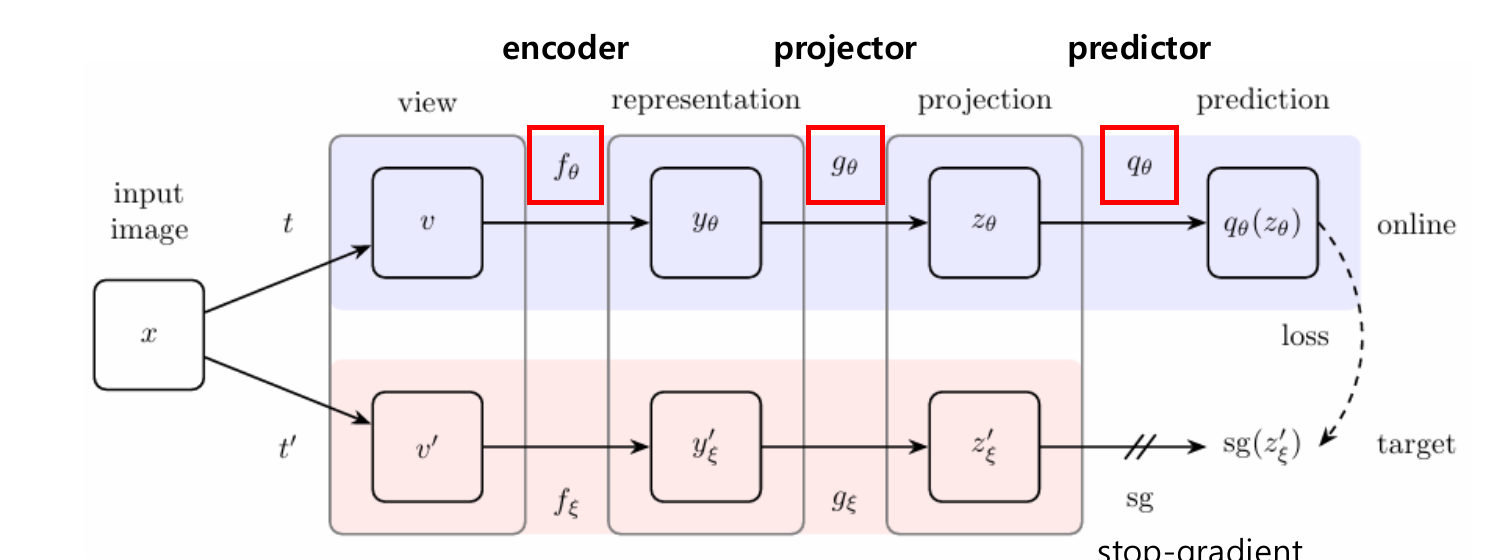
이제 본론. BYOL은 서로 상호작용하며 함께 학습하는 두 개의 신경망, 온라인 네트워크($\theta$)와 타깃 네트워크($\xi$)로 이루어진다.
Online Network — 학습 대상
온라인 네트워크는 세 부분으로 이루어진다.
\[\text{Online} = f_\theta(\text{Encoder}) + g_\theta(\text{Projection}) + q_\theta(\text{Predictor})\]- encoder $f_\theta$: ResNet (마지막 FCL·softmax 없이 특징 벡터만 출력) → $y_\theta = f_\theta(v)$
- projector $g_\theta$: 특징 벡터를 latent space로 매핑 → $z_\theta = g_\theta(y_\theta)$
- predictor $q_\theta$: 타깃의 표현을 예측 → $q_\theta(z_\theta)$
Target Network — EMA로만 갱신
타깃 네트워크는 predictor가 없는 비대칭 구조다.
\[\text{Target} = f_\xi(\text{Encoder}) + g_\xi(\text{Projection})\]핵심은 타깃이 역전파로 학습되지 않고, 온라인 가중치의 지수이동평균(EMA) 으로만 천천히 따라온다는 점이다.
\[\xi \leftarrow \tau\,\xi + (1-\tau)\,\theta,\qquad \tau \approx 0.99 \sim 0.996\]$\tau$가 1에 가까우니 타깃은 “온라인이 방금 배운 것”을 아주 느리게 반영한다. 덕분에 타깃이 안정적인 예측 목표가 되어 준다.
Projection은 왜 끼우나
인코더가 만든 특징 벡터 $h$를 손실에 직접 노출시키면, 표현이 손실에 과도하게 맞춰져 왜곡될 수 있다. projection head(보통 2~3층 MLP + BN + ReLU, 출력 $4096 \to 256$)를 한 겹 끼워 인코더 표현을 손실로부터 한 단계 떨어뜨려 보호한다.
Predictor는 왜 한쪽에만
predictor는 온라인 쪽에만 달려서 두 네트워크를 비대칭으로 만든다. 인코딩+사영 단계가 “모든 벡터를 동일하게”라는 함정에 빠지더라도, predictor를 한 번 더 거치면서 그 함정이 깨진다. 이게 collapse를 막는 구조적 장치다.
손실 함수와 학습 흐름
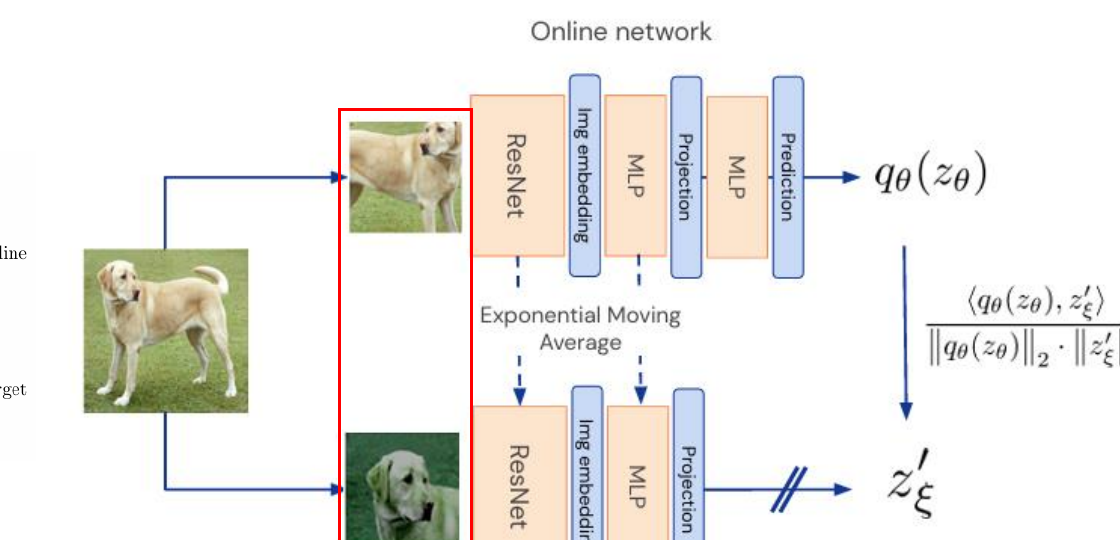
두 뷰를 각각 두 네트워크에 통과시킨 뒤, 온라인의 예측 $q_\theta(z_\theta)$와 타깃의 표현 $z’_\xi$를 $\ell_2$ 정규화하고 MSE(코사인 유사도와 동치)로 맞춘다.
\[\bar{q}_\theta(z_\theta) = \frac{q_\theta(z_\theta)}{\lVert q_\theta(z_\theta) \rVert_2},\qquad \bar{z}'_\xi = \frac{z'_\xi}{\lVert z'_\xi \rVert_2}\] \[L_{\theta,\xi} = \big\lVert \bar{q}_\theta(z_\theta) - \bar{z}'_\xi \big\rVert_2^2 = 2 - 2\cdot\frac{\langle q_\theta(z_\theta),\, z'_\xi \rangle}{\lVert q_\theta(z_\theta) \rVert_2 \cdot \lVert z'_\xi \rVert_2}\]두 뷰의 역할을 바꿔(symmetrize) 한 번 더 계산한 뒤 합산한다. 노트 표기로 쓰면:
\[\mathcal{L} = \lVert q_1 - \text{sg}(z_2) \rVert_2^2 + \lVert q_2 - \text{sg}(z_1) \rVert_2^2\]여기서 $\text{sg}(\cdot)$가 stop-gradient다. 타깃 쪽 표현에는 그래디언트가 흐르지 않는다.
한 step의 흐름
- 두 뷰 생성: $v = t(x)$, $v’ = t’(x)$
- 온라인: $z_\theta = g_\theta(f_\theta(v))$ → $q_\theta(z_\theta)$
- 타깃: $z’\xi = g\xi(f_\xi(v’))$ (predictor 없음, stop-gradient)
- 손실 $L^{\text{BYOL}}$을 온라인 $\theta$만 역전파로 갱신
- 타깃 $\xi$는 EMA로만 갱신
정리하면: 손실은 양방향으로 계산하지만, 각 방향마다 학습되는 건 온라인 한쪽뿐이다. 타깃은 그래디언트가 아니라 EMA로 따라온다.
네거티브 샘플 없이 왜 collapse가 안 되나
이 글을 쓰게 만든 질문. 모든 입력을 같은 상수 벡터 $c$로 보내면 손실이 0이 되는 자명한 해(collapsed solution) 가 분명히 존재한다. SimCLR 같은 대조학습은 음성 쌍을 밀어내서 이걸 막지만, BYOL엔 음성 쌍이 없다. 그런데도 무너지지 않는 이유는 세 가지가 맞물린 결과다.
1. 비대칭 predictor
온라인에만 predictor $q_\theta$가 있어 두 경로가 비대칭이다. 인코더+사영이 “모두 동일 벡터” 함정에 빠져도, predictor가 한 겹 더 있어 그 평형을 깨뜨린다.
2. stop-gradient + EMA 타깃
타깃은 그래디언트를 받지 않고 EMA로만 움직인다. 그래서 온라인이 타깃을 쫓아갈 때 두 네트워크가 동시에 같은 상수로 붕괴하는 경로가 막힌다. 타깃이 “느리게 움직이는 안정적 목표” 역할을 한다.
3. predictor 최적성 가정
논문은 predictor가 최적($q_\theta = q^*$)이라고 가정한다. 이때 최적 predictor는 주어진 온라인 투영에서 타깃 투영의 조건부 평균을 낸다.
\[q^\*(z_\theta) = \mathbb{E}\big[z'_\xi \mid z_\theta\big],\qquad q^\* = \arg\min_q \mathbb{E}\big[\lVert q(z_\theta) - z'_\xi \rVert_2^2\big]\]이 가정 아래 $\theta$ 갱신 방향을 풀면, 손실 그래디언트가 타깃 투영의 조건부 분산을 줄이는 방향이 된다.
\[\nabla_\theta\,\mathbb{E}\big[\lVert q^\*(z_\theta) - z'_\xi \rVert_2^2\big] = \nabla_\theta\,\mathbb{E}\big[\textstyle\sum_i \mathrm{Var}(z'_{\xi,i} \mid z_\theta)\big]\]즉 온라인 투영 $z_\theta$가 타깃 투영 $z’_\xi$의 불확실성을 줄여 더 예측 가능하게 만드는 방향으로 특징을 학습한다. 상수로 붕괴하는 건 이 분산-감소 목표에 비춰 결코 안정적인 평형이 아니다.
물론 BYOL도 $q_\theta$가 상수 함수가 되는 undesirable equilibrium이 이론적으로는 존재 가능하다. 다만 predictor가 그 정체 상태를 빠르게 벗어나도록 그래디언트를 흘려보내, 실제 학습에서는 그 평형에 머무르지 않는다.
평가 — Linear Evaluation
학습된 표현이 좋은지는 어떻게 재나. 표준 방법은 linear evaluation protocol이다. pre-training으로 얻은 인코더 $f_\theta$를 얼려두고(frozen), 그 위에 선형 분류기 하나만 얹어 ImageNet 등에서 학습해 정확도를 측정한다. 인코더가 이미 좋은 표현을 뽑고 있다면 선형 분류기만으로도 높은 정확도가 나온다는 논리다.
이후 downstream task(검출·분할·깊이 추정 등)로 전이할 때는 AP50, IoU/mIoU, RMSE·AbsRel 같은 task별 지표로 평가한다.
헷갈리기 쉬운 포인트
1. “대조학습이니까 음성 쌍이 필요한 거 아냐?”
네거티브 샘플이 꼭 필요하다 — BYOL은 아니다. 음성 쌍 없이 양성 쌍의 일치만 최적화한다. collapse는 비대칭 predictor + stop-gradient + EMA 타깃의 조합으로 막는다.
2. “타깃 네트워크도 역전파로 학습되나?”
아니다. 타깃 $\xi$는 그래디언트를 전혀 받지 않고 온라인 $\theta$의 EMA로만 갱신된다. 역전파로 학습되는 건 온라인뿐이다.
3. “predictor와 projector가 헷갈린다”
projector $g$는 양쪽 다 있고(인코더 표현 → latent space), predictor $q$는 온라인에만 있다(타깃 투영을 예측). 이 비대칭이 핵심이라 둘을 섞으면 안 된다.
4. “stop-gradient를 왜 거나?”
타깃 경로로 그래디언트가 흐르면 두 네트워크가 함께 같은 상수로 붕괴할 수 있다. sg로 한쪽 방향(online → target 예측)만 학습시켜 그 경로를 끊는다.
5. “EMA의 $\tau$는 왜 1에 가깝나?”
$\tau \approx 0.99\sim0.996$이면 타깃이 아주 천천히 움직여 안정적인 예측 목표가 된다. 타깃이 너무 빨리 변하면 따라갈 목표가 흔들려 학습이 불안정해진다.
정리하며
BYOL의 핵심은 한 줄로 요약된다.
같은 이미지의 두 뷰를 가깝게 만드는 것만으로, 비대칭 predictor·stop-gradient·EMA 타깃의 조합 덕분에 네거티브 샘플 없이도 collapse 없이 표현을 학습한다.
전체 흐름은 이렇게 이어진다.
증강으로 두 뷰 생성 → 온라인(encoder·projector·predictor) / 타깃(encoder·projector) → 온라인이 타깃 투영을 예측 → 온라인만 역전파, 타깃은 EMA → linear evaluation으로 표현 품질 측정
SVM에서 “왜 그 경계가 최적인가”를 증명으로 따라갔다면, BYOL은 “왜 무너지지 않는가”를 구조의 비대칭으로 설명하는 논문이었다. 대조학습의 음성 쌍이 필수라는 통념을 깬 지점이 가장 인상 깊었고, 표현학습을 분류 정확도가 아니라 표현 자체의 품질로 바라보는 관점을 잡는 계기가 됐다.
참고
- Grill, J.-B., et al. (2020). Bootstrap Your Own Latent: A New Approach to Self-Supervised Learning. NeurIPS.
- 본 글의 발표 슬라이드: lab-seminar-2025 / 04_BYOL.pdf
« GCN 논문 리뷰 - 그래프에 합성곱을 가져오다
CLIP 논문 리뷰 - 자연어로 이미지를 분류하다 »